SkillsBench: 评估AI智能体技能在不同任务中表现的基准测试
快速阅读
随着智能体应用的发展,“Agent Skills”(智能体技能,即辅助大语言模型推理的程序化知识包)被广泛使用。然而,这些技能真的有用吗?有多大用处?这篇论文提出了 SkillsBench——第一个将“技能”作为第一类评估对象的基准测试。研究团队在 11 个领域的 84 个任务中,测试了 7 种“模型-脚手架”组合,并比较了三种情况:无技能、人工精选技能和模型自生成技能。
核心结论包括:
- 人工精选技能显著提升表现:平均通过率提升了 16.2 个百分点,但收益在不同领域差异巨大(如医疗保健提升 51.9%,而软件工程仅提升 4.5%)。
- 自生成技能几乎无用:模型自己生成的程序化知识平均带来 -1.3% 的负面效果,说明模型无法可靠地编写自己所需的程序化知识。
- “小而美”的技能更好:2-3 个模块的精准技能,比冗长详尽的文档更能帮助智能体。
- 技能可以弥补模型规模的不足:使用技能的小模型,表现可以媲美甚至超越没有技能的大模型。
1. 简介与背景
大语言模型(LLM)正从单纯的文本生成器进化为能够在真实世界环境中执行复杂多步任务的自主智能体。Claude Code、Gemini CLI 和 Codex CLI 等基于终端的代理工具,让开发者能够在工作流中直接借助前沿模型的能力。
然而,我们面临一个根本性的矛盾:基础模型具有广泛的通用能力,但缺乏特定领域工作流所需的程序化知识(Procedural Knowledge);另一方面,微调模型成本高昂且会牺牲通用性。
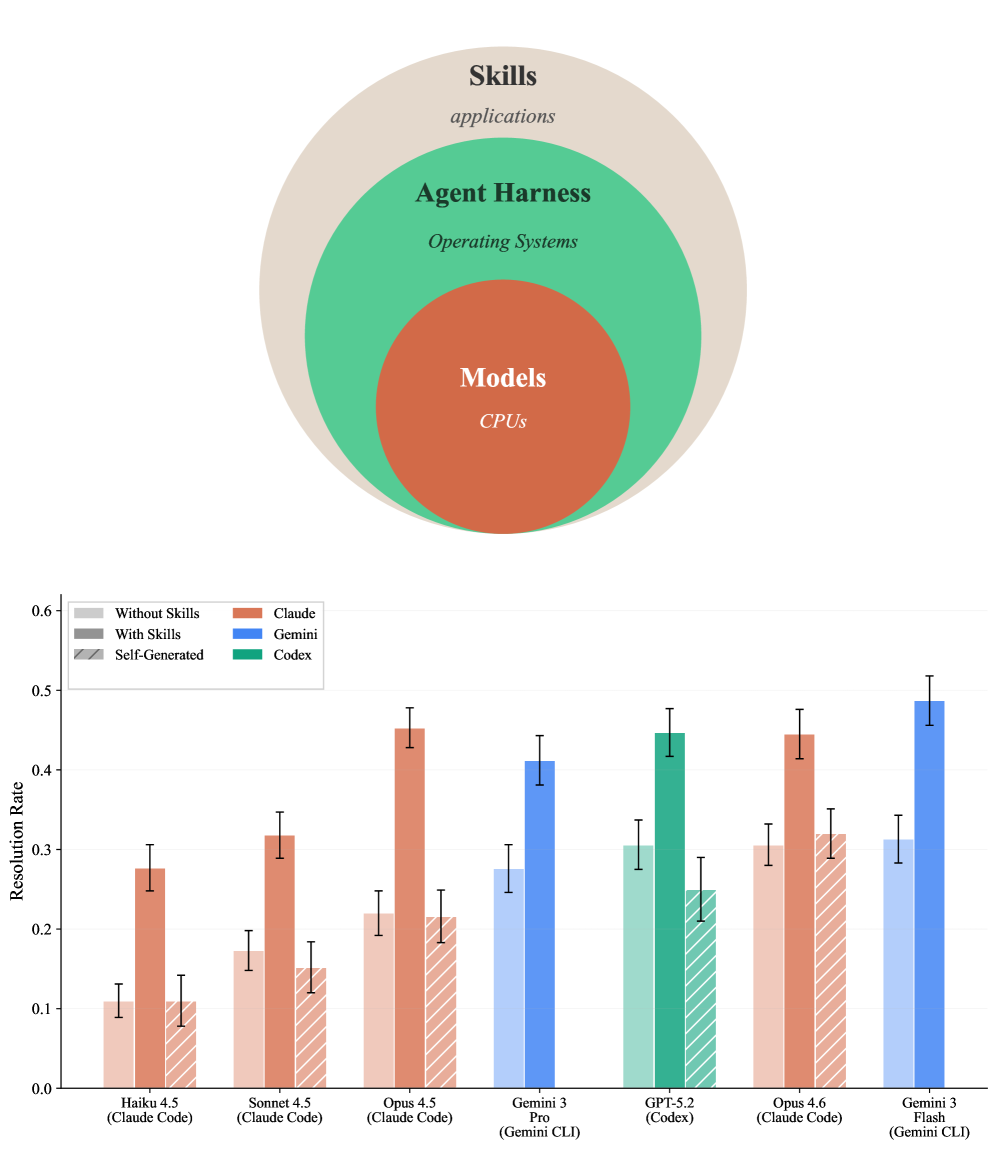
Agent Skills(智能体技能) 成了新兴的解决方案。技能是一种结构化的知识包(包含指令、代码模板、资源和验证逻辑),能够在推理阶段增强智能体的行为,而无需修改模型本身。尽管社区和企业快速积累了数以万计的技能,但在此之前,没有一个标准的基准测试来衡量这些技能究竟多大程度上帮助了智能体。
2. 什么是 SkillsBench?
SkillsBench 建立在 Harbor 框架之上,采用容器化的结构。每个任务包含环境(内置技能和数据)、确定性验证器和参考解决方案。这也是业界首个系统性评估技能效用的基准测试。
在 SkillsBench 中,每一个“技能”必须满足以下标准:
- 程序化内容:包含操作指南、工作流或 SOP,而不是纯粹的事实检索。
- 任务类别普适性:适用于一类问题,而不仅仅是单个实例。
- 结构化组件:包含一个
SKILL.md文件以及可选的资源(脚本、模板、示例)。 - 可移植性:完全基于文件系统,易于编辑和跨平台使用。
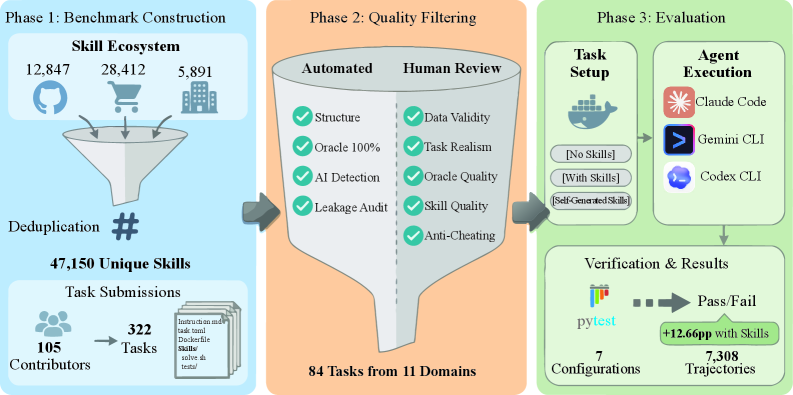
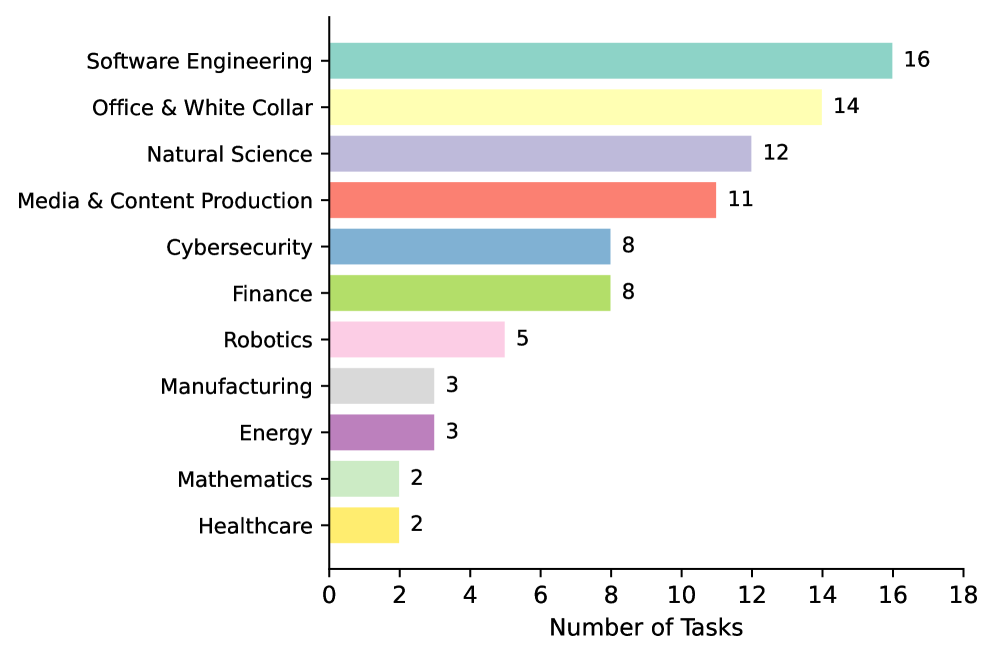
整个基准测试的构建经过了严格的自动化检查和人工审查,包含 84 个任务,跨越 11 个领域。
3. 实验发现
研究团队对 7 种“模型-框架”组合在无技能、有精选技能和模型自生成技能这三种条件下的 7308 条轨迹进行了评估。
发现一:技能提供了巨大但存在差异的收益
平均而言,技能将任务通过率提升了 16.2 个百分点。但具体的收益高度依赖于模型和任务。例如,Claude Code 配合 Opus 4.5 提升最明显(+23.3%)。
发现二:模型自生成的技能往往无用甚至帮倒忙
当让模型先自己生成领域知识再解决问题时,平均表现相比基线甚至下降了 1.3%。这表明,真正有效的技能需要人类专家整理的领域知识,这是当前模型无法凭空可靠生成的。
发现三:收益因领域而异
在模型预训练阶段覆盖较少的专业领域(如医疗数据协调、制造业工作流),技能带来的提升最大(医疗 +51.9%,制造 +41.9%)。而在软件工程等模型本身就非常擅长的领域,提升较小,甚至在个别任务中会因为技能带来的冲突或复杂性导致负面效果。
发现四:技能数量和复杂度:少即是多
研究发现,为任务提供 2-3 个技能模块是最优的,提供 4 个以上的技能反而会导致边际收益递减。 此外,中等长度的精简技能比极其详尽的全面文档效果更好。冗长的技能内容会消耗上下文预算,反而让智能体抓不到重点。
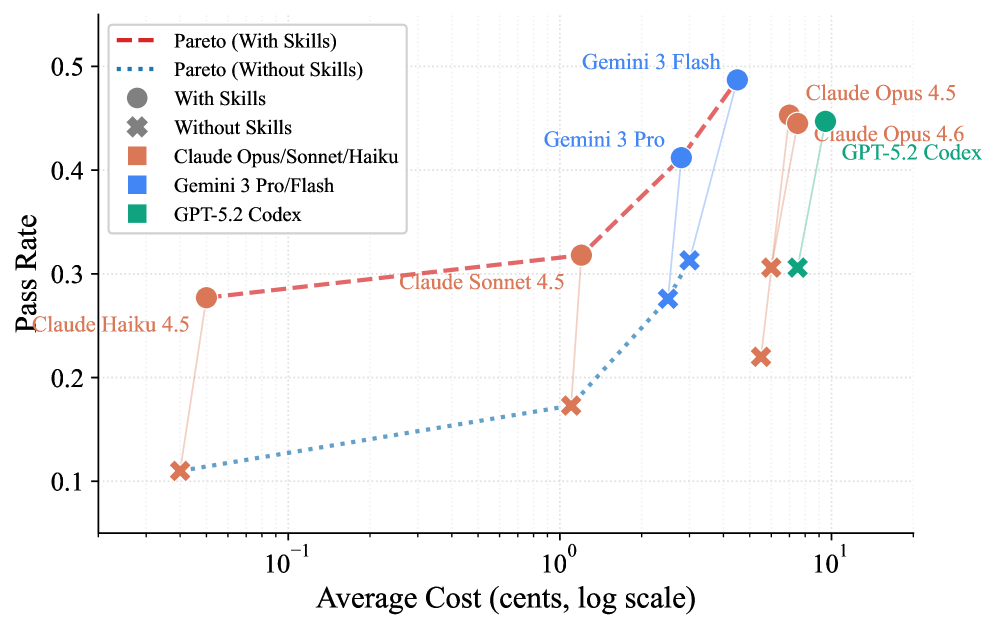 (图 4:各个配置下通过率与成本的帕累托前沿。图中标实心的点代表使用了技能的情况,显著拉高了整体性能边界)
发现五:技能可以抵消模型规模的劣势
在测试中,使用技能的 Claude Haiku 4.5(小模型)通过率为 27.7%,比没有使用技能时提升了 16.7%。这一成绩甚至超过了没有使用技能的 Claude Opus 4.5(22.0%)。这证明,针对程序化任务,优秀的技能知识库可以部分弥补模型本身容量和规模的不足。
4. 总结与启发
SkillsBench 为 AI 智能体应用开发者带来了重要启示:
- 不要盲目堆砌技能:最有效的技能应该包含简洁的分步指南和至少一个有效示例,而不是百科全书式的详尽文档。
- 专注于模型不擅长的特定程序:模型在常识和通用代码上已经很强,技能的重点应放在那些对格式敏感、工作流特殊的垂直领域。
- 框架支持至关重要:智能体的外围脚手架(Harness)需要能够稳定地检索和调用这些技能,否则再好的技能也无法发挥作用。
未来,随着智能体生态的繁荣,对技能本身的设计、选择和评估将成为与模型训练同样重要的基础设施工程。
🔗 原文链接:SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks