Shopify 的 Autoresearch 实践:AI Agent 不仅仅用于训练模型
快速阅读
本文分享了 Shopify 工程师 David Cortés 如何利用 AI Agent(特别是 Andrej Karpathy 提出的 Autoresearch 概念)来优化软件工程中耗时且繁琐的任务。最初,David 只是想解决 CI(持续集成)频繁失败且耗时 30 分钟的问题。他发现,与其通过向 AI 寻求“一次性”的解决方案,不如让 AI 像人类研究员一样,在后台进行无限循环的假设测试与迭代优化。通过设定明确的优化指标(例如 Polaris 的构建时间),AI Agent 能够自主尝试各种改动,如果指标提升就保留,失败或变慢则回滚。
最终,这种方法找出了很多连人类都不愿去做的“枯燥优化”,比如剔除无用的重复编译等,成功将构建速度提升了 65%。随后,Shopify 创始人 Tobi Lütke 也加入其中进行结对编程,并主导了包含多指标支持的 32 次代码提交,最终两人将项目开源为 pi-autoresearch。如今,该工具不仅在 GitHub 上获得了数千颗星,还在 Shopify 内部优化了 40 多项指标。
这一切始于一个崩溃的 CI
晚上 7 点,我依然坐在办公桌前。我的分支又一次在 CI(持续集成)中失败了。这已经是连续第五次了,我几乎想要合上笔记本直接放弃。
当时我还不知道,几天后,Shopify 创始人 Tobi 会向我发起一个针对我副业项目的包含 32 次提交的 PR,从而彻底解决这个问题。
让我们退回一点来看。我在 Polaris 团队工作。每次我们进行极其微小的代码更改时,都会引发随机的视觉回归测试失败——这意味着我们需要白白等待 30 分钟的 CI,仅仅为了发现自己破坏了其他东西。那是 30 分钟的等待,然后被告知必须再等 30 分钟。但第二天醒来时,我有了一个完全不同的想法:我不仅要修复我手头的任务,我要修复这“30分钟”。
在我推送了几个更改并让 CI 在后台运行时,我打开了社交媒体 X。当时所有人都在谈论一个新话题:Andrej Karpathy 创建的 Autoresearch。
Autoresearch 的魔力
Autoresearch 的核心概念是让 AI 模仿人类研究员的工作。过去,训练 GPT-2 级别模型需要几个月的时间,而通过使用 Autoresearch,Andrej 在他睡觉的时候,让 AI 自动在几小时内完成了训练。
Autoresearch 实质上是一个在循环中运行的 AI。如果你听说过 Ralph Loops,它们非常相似,只是 Autoresearch 更加专业。Andrej 使用它来训练模型。而我对我亲爱的 AI 助手 Opus 很满意,并且目前也没有训练模型的计划,所以这肯定帮不了我的忙,对吧?这是给那些训练模型的聪明人用的,不是给我用的。
这时我的 PR 终于通过了。我打开了另一个终端,并开始向一个 Agent 提出提示:
Let’s investigate how we can reduce this CI time. Start with Polaris build time. Swap libraries, or migrate to others that are faster. Use Rust. Use whatever you want but make this problem go away. MAKE NO MISTAKES. Ultrathink. (让我们调查一下如何减少这个 CI 时间。从 Polaris 的构建时间开始。切换库,或者迁移到速度更快的库。使用 Rust。用任何你想用的东西,只要让这个问题消失。不要犯错。深度思考。)
它运行了很长一段时间,找到了一些性能技巧,让单元测试运行得更快。它试图通过“一次生成(one-shot)”来给出解决方案。然而,它不仅没有改善时间,甚至连代码都无法成功构建。
我让它继续运行,然后打开了我们的内部 Wiki 系统 Vault。如果在 X 上找不到答案,也许公司内部有人能帮我。
在这里,我看到了另一篇关于 Autoresearch 的引用,这次来自我的同事 Swati Swoboda。她也追随潮流在试验 Autoresearch。
也许我错过了什么?她说它不仅仅可以用来训练模型。但是怎么做呢?她尝试让 Agent 来改善一个具体的指标(metric)。我也正好有一个需要改善的指标,相同的概念,不同的应用。我怎么没想到?我立即停下了手头的所有工作。
我打开了我最喜欢的 Agent 运行框架 Pi,并开始了一个新会话。我的计划是为 Autoresearch 创建一个扩展插件。因为我以前做过一些扩展,所以这对我来说很合理:
Pi, create an extension for Autoresearch. We’ll show a custom UI for each iteration as table rows, we will focus on a metric and see how it improves over time. It will run forever (Pi,为 Autoresearch 创建一个扩展。我们将为每次迭代在表格行中显示自定义 UI,我们将专注于一个指标并观察它如何随着时间的推移而改善。它将永远运行)
Pi 能够读取它自己的扩展文档。事情就是这么简单。它从外面看起来可能很吓人,但它就像你需要什么扩展就提示什么一样简单。在此期间我去倒了杯咖啡,却忘了喝。当我在心流状态中意识到它时,咖啡已经凉了。
不到半小时的交互后,它就能正常工作了。
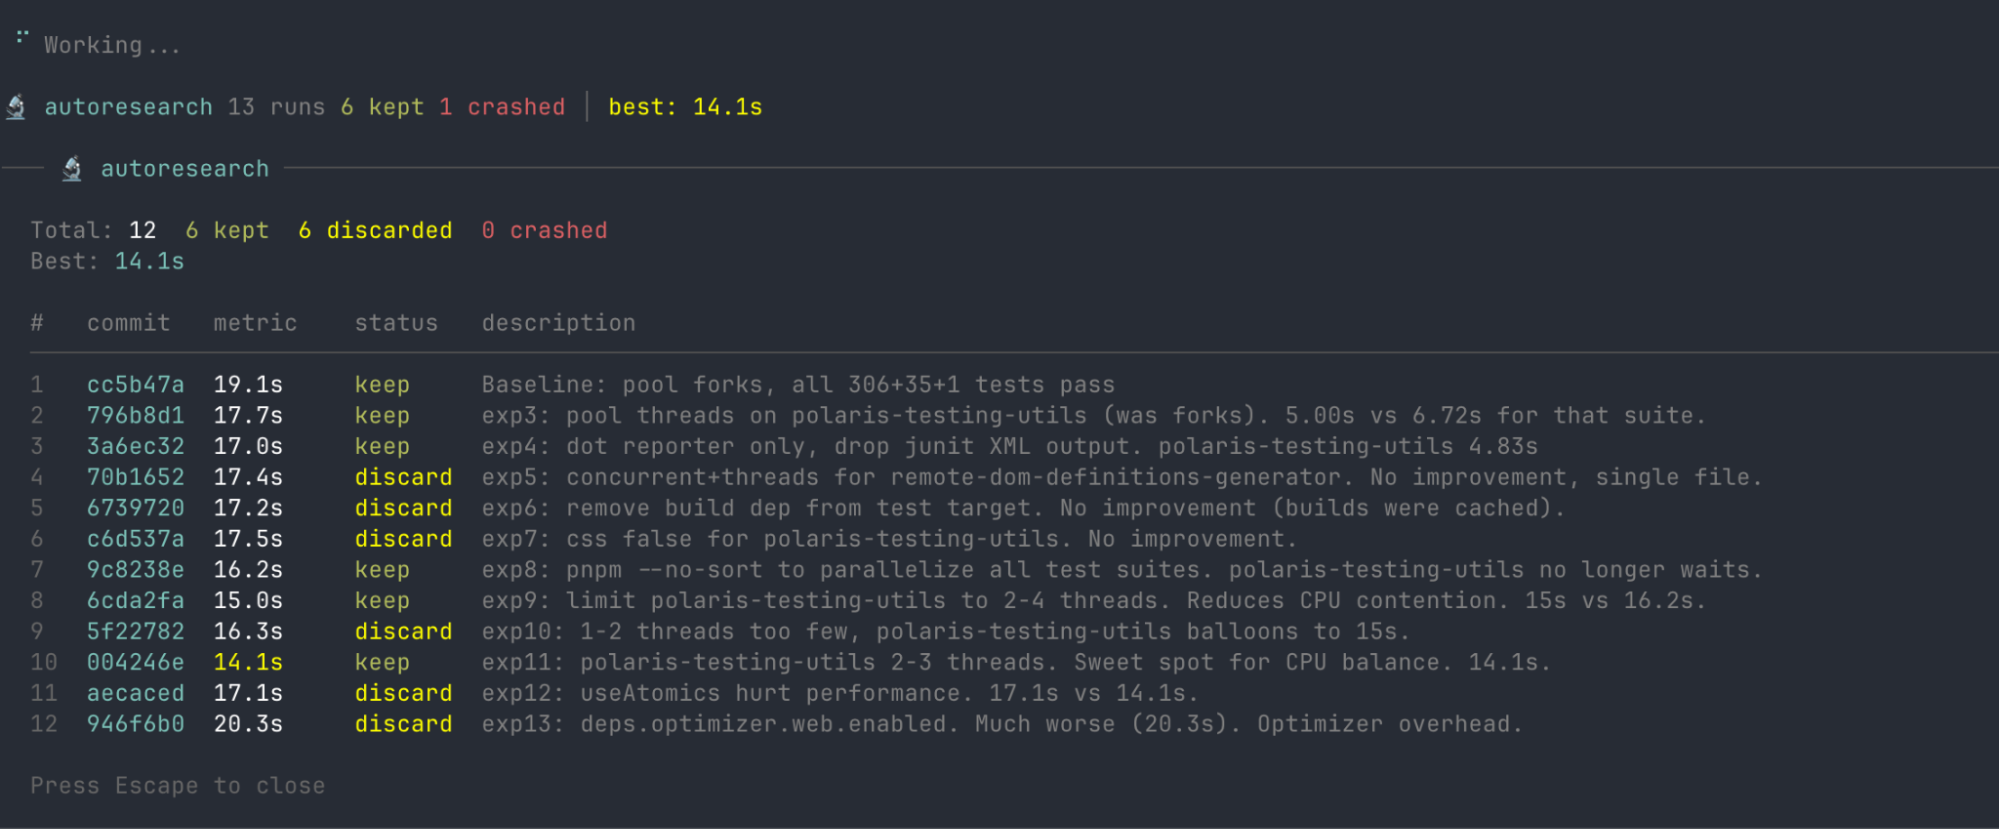
无限优化循环的工作原理
第一版其实非常简单:
- 寻找要改进的指标:在这种情况下,我专注于构建时间,因为所有的 CI 流水线都依赖于 Polaris 的构建。
- 测量指标基线:当我开始运行它时,构建耗时是 19.1 秒。
- 假设测试:对于每次迭代,它形成一个假设,写下来并开始测试。此时可能发生三种情况:运行速度比基线快(保留代码),崩溃(丢弃代码),或者运行速度变慢(同样丢弃)。
- 重复:它会一直运行,直到你决定停止它,或者它的上下文耗尽。在系统提示中甚至写着:“NEVER STOP LOOPING”。
这比直接对 Agent 说“改进 Polaris 构建时间”要好得多,因为之前的“一次性”解决方案根本行不通。有了这种新方法,它有了针对特定指标的焦点。它有明确的目标,并且有明确的方法来衡量它是否在朝着正确的方向前进。
同时,我们给了它尝试疯狂想法的机会。虽然让它无限运行,它有机会尝试在正常运行中人类不会尝试的东西。借助 Autoresearch,你会随着时间的推移获得微小的渐进式改进。即使每次迭代只有 1% 的提升,积累起来也能获得显著的效果。每次孤立的优化可能没什么意义,但总体而言,它能够显著优化你交给它的每个指标。
我让它运行了几次迭代,并证明它确实有效。这很简单,你不需要成为机器学习研究员也能让它工作。每次迭代都使构建变得更快。有时它会崩溃,但它会忽略并继续前进。它有时也会做一些丑陋的黑客攻击(Hacks),比如删除大量文件——是的,那样是更快了,但这是不可接受的。
但有一个伟大的想法留存了下来:我们的 VRT 构建在此之前一直运行完整的组件流水线——IIFE 打包、类型声明、所有的一切——然后才交给 Storybook,而 Storybook 反正也会从源码重新编译。这纯粹是浪费。Agent 还发现 TypeScript 转换正在处理所有 580 个组件文件,而实际上只有 105 个文件真正需要处理。
突然之间,构建速度加快了 65%。我扔掉了所有丑陋的 Hack 代码,保留了精华部分。
在 Autoresearch 之前,AI Agent 所做的工作与人类相同,只是速度更快。但 Autoresearch 不同——它能做没有人会手动尝试的工作。没有人的冲刺计划会包括“花三个月的时间将构建时间减少 30%”。这有价值,大家都同意它有价值,但它很枯燥,它与功能开发竞争,而且它只能存在于一天中零碎的时间裂缝里。但是 AI Agent 没有相互竞争的优先级,它不会感到无聊,不需要向产品经理证明投资回报率(ROI),也没有最后期限把它拉走。
事实证明,人类正确选择忽视的“苦差事”,成为了自主循环执行的完美工作负载。
与 Tobi 的结对编程
我对这个扩展进行了截图,并在我们 Slack 的 #pi 频道上发帖:“WIP autoresearch extension. I’ll keep you posted.”(Autoresearch 扩展开发中,稍后更新)。同时,我也让 autoresearch 在后台运行三个其他能让 CI 更快的指标。
团队里的其他人开始关注。Slack 的回应点赞越来越多,我的多巴胺水平也随之飙升。然后,发生了一件我没想到的事情:Tobi(Shopify 创始人)说他很喜欢。我不得不读了两遍。我推开门告诉我的妻子:“Tobi 喜欢我做的东西!”
Tobi 建议我应该让其他人更容易安装。我立即创建了一个代码仓库,并在频道中回复:“只需运行 pi install repo-url。”它必须足够简单,否则没人会用。
第二天,我继续对该扩展进行改进。这时我已经忘了 Tobi 是这个工具的粉丝。直到他给我发私信:“嘿,我真的很喜欢你创造的这个东西。我在上面做了一些工作。”
他刚刚创建了 32 次提交。他添加了多指标支持、持续执行每次迭代的脚本、Agent 运行技能的改进、自动提交以及许多其他东西。他现在是这个扩展的主要贡献者了。
我发现了一些我可能会以不同方式处理的地方。思考了一分钟后,我在 PR 中添加了一条评论。五分钟后,他已经推送了修复程序。在接下来的几个小时里,我们继续在上面合作。我从未体验过如此激烈的结对编程体验。我们能在几分钟内从想法转化为执行。 “如果指标不好,我们是否应该避免提交?” “决定了,实现它。” “接下来做另一件事。”
对我来说,这一天即将结束。我在巴塞罗那,比多伦多早六个小时。在我的时间晚上 9 点,Tobi 仍在做修改,然后他告诉我:“我认为完成了。让我们把它开源吧。”
什么?现在?这么快?如果我们暴露了内部信息怎么办?我应该谨慎处理。而且,这是我们两人共同开发的,我不太习惯以我的名义发布它。但他坚持说:“你的想法,你的代码仓库。”
我意识到,他是真的想“现在”就发。
将其开源
吃完晚饭,我哄孩子们睡觉。然后我再次拿起笔记本电脑,走到沙发上,开始准备开源所需的一切。
我已经有一段时间没有做过开源工作了——上一次是 FlashList 仓库。我运行了 gitleaks,以确保代码中没有暴露任何机密,一切正常。
我还让 Agent 对代码跑了一遍:“我即将发布内部代码吗?没有,一切都好。”
所以,我想……我们发布它吧?我在出汗。
管他呢。我告诉 Agent:“Make it public(设为公开)。”
然后它就发布了。就这样?好吧,搞定了。
我合上笔记本电脑,我的身体立刻有了反应。我整天都很紧张,只是自己没有意识到。
两天后。当我醒来查看手机时,我的 X(推特)已经爆炸了。我在几个小时内从 600 名粉丝增加到 800 名。因为 Tobi 刚刚在 X 上发布了关于我们项目的推文,这就解释得通了。
OK, well. I ran /autoresearch on the the liquid codebase. 53% faster combined parse+render time, 61% fewer object allocations. This is probably somewhat overfit, but there are absolutely amazing ideas in this. — tobi lutke (@tobi) March 12, 2026
最好的消息是:我们的项目 pi-autoresearch 受到了极大关注。100 颗星、200 颗星、500 颗星。天哪,我从未见过这样的阵仗。此时我意识到我的 Github 帐户中充满了 10 年前的各种杂乱测试项目。我对我的 PHP 过去感到有点羞愧,所以我开始将所有内容都设为私有。请不要告诉任何人。
在写这篇文章的时候,pi-autoresearch 在 Github 上已有超过 3,600 颗星,以及 200 多个分支衍生版本。我仍在积极努力使其变得更好。在公司内部,我们有一个 #autoresearch-wins 频道,来自全公司的人在这里分享他们的成就。到目前为止,我们看到了单元测试运行速度提高 300 倍、挂载 React 组件速度提高 20%、减少多个项目的构建时间、提高 playwright 测试速度等案例……多亏了它,我们甚至成功让 pnpm 运行得更快。
到这里,我希望我已经给了你足够的理由去尝试一下。现在轮到你了。去运行它吧,然后看着这些枯燥繁重的指标数值逐渐下降。
🔗 原文链接:Autoresearch isn’t just for training models (2026) - Shopify