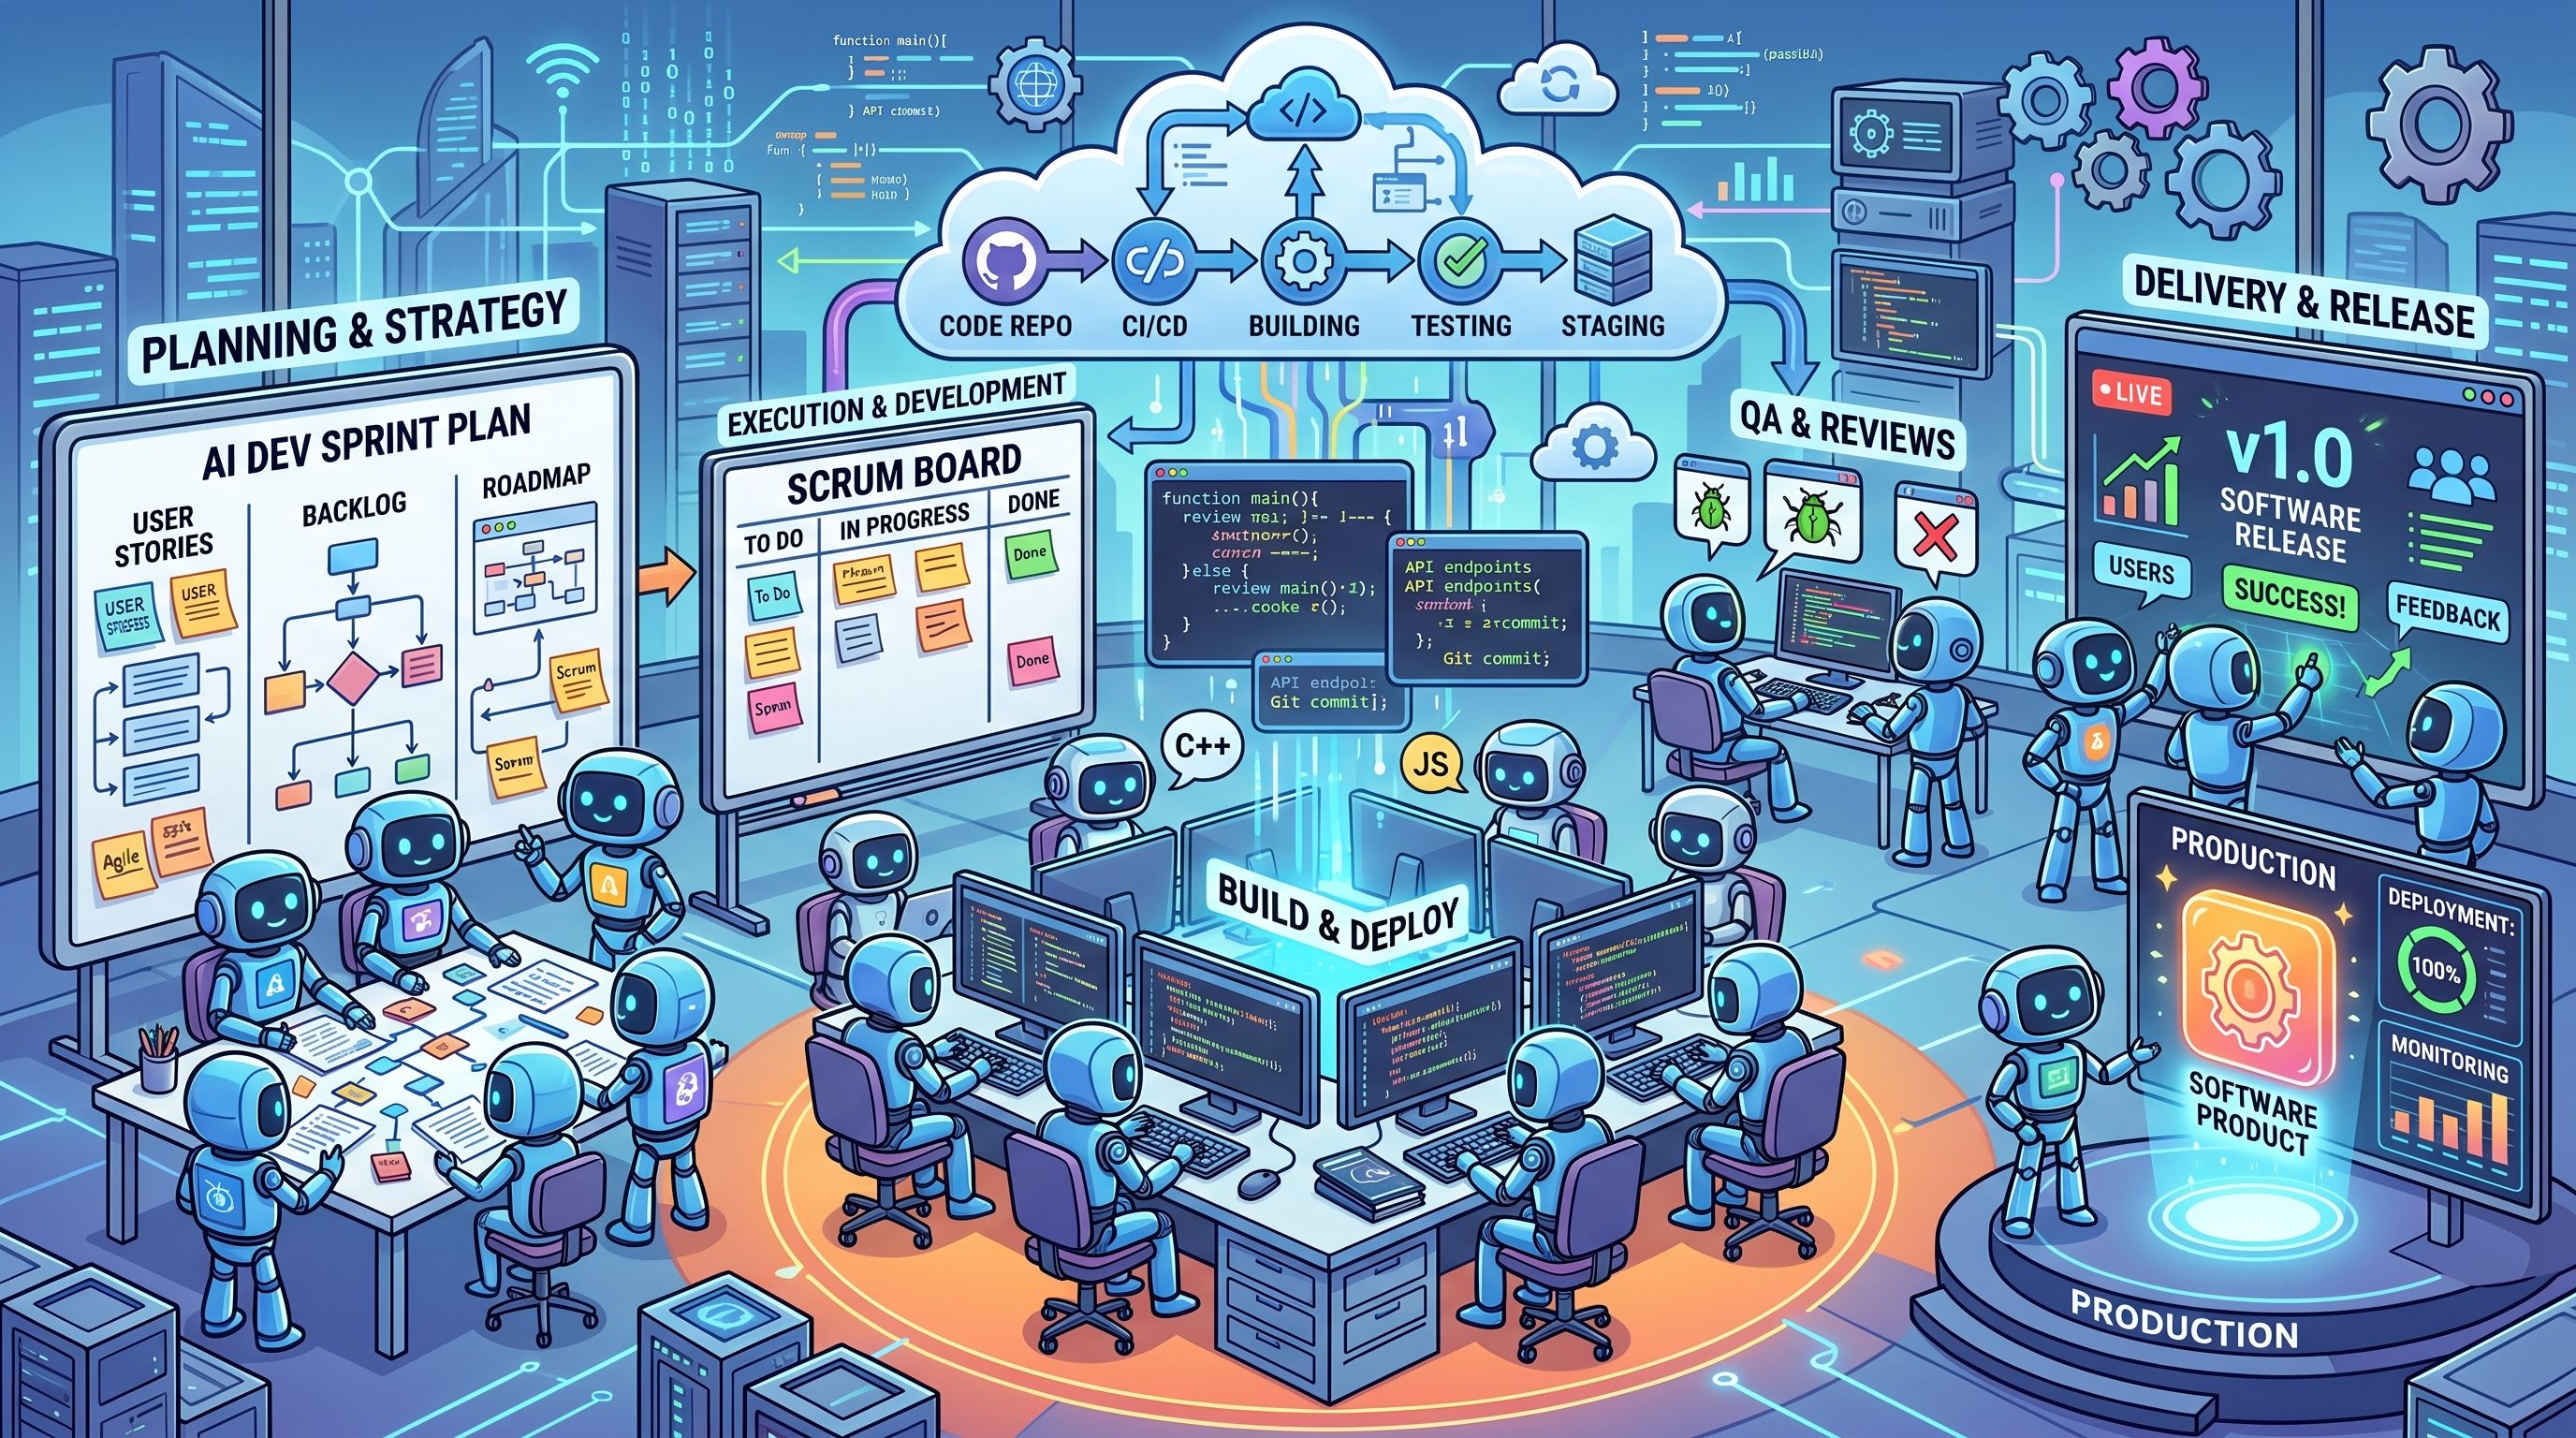
2026 年 10 月的 Agent 编程实战手记:别在模型上省钱,让整个 SDLC 对智能体可见
快速阅读
随着 AI Agent 深度渗透软件开发的每一个环节,站在 2026 年 10 月 的时间节点回看,传统的编码与工程协作范式已经发生了根本性重构。过去许多关于“AI 代码会带来技术债务(Slop)”、“手动抠 Token 限制”以及“人机高频对话调优”的教条,在强大的前沿模型和工具生态面前正在迅速过时。
本文基于一线深度使用 AI Coding Agent(如 Amp、Devin、Claude Code 等)的实战经历,梳理了 15 条颠覆性的核心认知与行动准则:
- 必须用最顶尖的模型:省下 50% 成本换来随机 20% 变笨的通用模型,只会让你在 10% 的不可知错误上浪费成倍的重试时间。
- 停止担忧代码垃圾(Slop):模型生成的代码质量早已越过“不可维护”的临界点。
- 提示词只管“要什么(What)”,放手让它决定“怎么做(How)”:明确最终交付目标,给 Agent 足够的自主解空间。
- 让整个软件开发生命周期(SDLC)对 Agent 可见且可操作:终结幻觉的唯一解是工具调用(Tool calls)。让 Agent 能够接触真实物理世界——阅读线上日志、触发部署、观察灰度发布、打 Tag 切分支、控制 Feature Flag 并分诊 Bug。
- 为 SDLC 构建专属工具与插件:把排障、报警排查、健康检查、灰度权限都封装为 Agent 可调用的工具。
- 用 A/B 实验评估“智能体知识(Agentic Knowledge)”:代码库堆砌的
AGENTS.md、Skills 和文档到底起不起作用?起 5 个盲测 Agent 做对照实验见真章。 - 告别别扭的本地开发环境:端到端验证需要 Agent 自主安装环境与运行多服务,云端远程沙箱才是标准解法。
- 不要陪 Agent 单步试错,让它构建工具来辅助迭代:让它生成 20 种变体并做成轻量对比页面,或提出 4 种假设并逐一排查验证。
- 索要“不可辩驳的证据(Irrefutable Proof)”:这是最大的 Game Changer。端到端验证用例、前后基准数据、Demo 记录,把“仅凭口头自述不是证据”直接写进
AGENTS.md。 - 不要等 Agent,让 Agent 等你:拥抱异步(Async)与大颗粒度任务批处理,停止焦虑首字延迟(TTFT)。
- 自动化定时、心跳与唤醒机制是杀手级特性:“2 小时后查日志”、“上线后通知我”,让 Agent 拥有长效生命周期。
- 停止手动精打细算上下文:上下文压缩算法已经极为健壮,一个任务一条线程(One thread = one task),无需在 300k 与 380k 之间焦虑。
- 对话线程就是团队的数字资产与记忆:线程与 Git Commit 强关联,让每一次决策过程都具备可追溯性与复利效应。
- 不要让 Agent 代替人类社交表达:除了机械性的事故报告、排错步骤和技术备忘录,保持人际沟通的真实。
- 只审查爆炸半径大的核心文件:一个系统只有不到 5 个最核心的架构枢纽和数据迁移脚本值得人工逐行审阅;对于代码风格和局部写法,只需关注能否端到端跑通以及是否具备未来的可修改性。
站在 2026 年 10 月的节点,AI 编程工具已经从“辅助写代码的代码补全插件”,彻底进化为“在云端独立闭环完成研发任务的工程智能体”。但很多团队在使用 Agent 时,思维依然停留在六个月甚至一年前的旧时代。
以下是我们在高强度、高并发的 Agentic 研发实践中总结出的 15 条前沿经验与范式转变。
1. 坚持使用最顶尖的模型,在智力上省钱是最大的浪费
“一定要用最新、最强的旗舰模型,其他的一切选择本质上都在浪费你的生命。”
如果一个模型有 10% 的时间在犯错,最要命的并不是那 10%,而是你根本不知道它会在哪 10% 的地方出错。这会导致你被迫投入大量精力去防御、排查与反复重试。
为什么要在真实生产中雇佣一个价格便宜 50%、但却随时随地随机变笨 20% 的通用降级模型?到了 2026 年底,谁还在用 Opus 4.5 级别的老旧模型?
顶级模型单次 API 调用的价格看似昂贵,但与人类工程师的调试精力、死循环重试的 Token 损耗以及隐藏缺陷的排查成本相比,最顶尖的推理模型永远是ROI(投入产出比)最高、最经济的生产力投资。
2. 停止担忧“代码垃圾(Slop)”的堆积
社区里长期存在一种恐慌:“滥用 AI 会向代码库里注入大量未经思考的代码垃圾,最终变成完全不可维护的烂摊子。”
半年前或许这个担忧还有一定依据。但在今天?我们完全不认同它会引入代码垃圾。
更重要的是,即便 Agent 偶尔产生了一些并不完全符合传统美学偏好的代码,这些代码也绝非不可维护。随着测试覆盖、类型推导工具和下一代审查 Agent 的成熟,只要系统边界清晰,AI 生成代码的整体健壮性和演进弹性早已超越了普通水平的人工编写代码。过度恐慌 Slop 只是保守主义者作茧自缚的借口。
3. 提示词只定义“要什么(What)”,别去管“怎么做(How)”
提示词工程(Prompt Engineering)最大的误区,就是试图手把手指导 Agent 的每一个实现步骤。
在实践中,描述你最终想要的成果(What),而非你认为该怎么做的路径(How),往往能得到惊艳得多的结果。
- 差的提示:“先在第 45 行加一个缓存,然后用哈希表存一下,再改一下循环……”
- 优秀的提示:“将字节码编译器和虚拟机优化到极致。在运行速度提升 2 倍之前,不要停下。这里是系统最终预期的行为与验收标准。”
给模型设定明确的北极星指标、边界条件和验收标准,然后把广阔的方案空间交由前沿模型自行探索与决策。
4. 让整个 SDLC 对 Agent 可见且可操作
为什么早期的 Agent 总是频繁出现幻觉?因为它们触碰不到现实。
真正终结幻觉的,从来不是更长的提示词,而是工具调用(Tool Calls)。工具调用是 Agent 连接外部物理现实的唯一触手。如果 Agent 看不到系统的某一部分,它就会开始凭空捏造。
因此,不要把 Agent 囚禁在一个局部的代码编辑器里,必须把整个软件研发生命周期(SDLC)对它完全开放:
- 让它端到端运行自己构建的代码;
- 让它直接读取生产环境与预发环境的实时日志;
- 让它执行部署、观察发布后的 Canary/Rollout 监控曲线;
- 让它自动打 Release 标签、切割分支;
- 让它翻转 Feature Flag(功能开关)进行灰度验证;
- 让它直接分诊(Triage)客户报告的 Bug,甚至在修复后给客户回复说明邮件。
一句话:凡是人类工程师能看到并操作的环节,Agent 也必须能看到并操作。
5. 为 SDLC 打造专属的一等公民工具链
既然整个生命周期都要向 Agent 敞开,我们就必须为它配备专用的软件工程工具。
在成熟的 Agent 生产团队中,基础设施通常会内置丰富的自定义插件与 MCP 协议工具:
- Bug 报告分诊工具:一键拉取异常堆栈、复现现场与用户环境数据;
- 客户沟通工具:支持以工单/邮件形式向受影响用户推送修复进度与调查说明;
- 健康度探针(“Is our system healthy?”):直接向可观测平台发起实时指标查询,评估错误率与延迟变化;
- 动态特性开关(Feature Flag)控制工具:允许 Agent 在受控权限内开启或关闭对应环境的灰度实验。
当这些工具成为 Agent 的标配,软件工程的“编码-验证-上线-排障”闭环才真正实现全自动化。
6. 用 A/B 实验客观评估“智能体知识”的真实价值
随着项目演进,代码库中往往会堆积大量的指示性资产:AGENTS.md、Skills 文件、开发规范脚本和各种架构文档。
但一个严峻的问题是:Agent 真的在阅读并使用这些知识吗?还是说这些文档只是人类的一厢情愿?
不要靠感觉猜测。Agent 本身就是运行对比实验的最佳工具。
在实践中,最有效的评估方式是:
- 启动 5 个没有任何前置干预的盲测 Agent(对照组 Control);
- 启动 5 个注入了特定规则或 Skills 的 Agent(实验组 Treatment);
- 给定相同的复杂研发任务,统计执行成功率、工具调用频次与交付耗时。
通过冷酷的数据实验,淘汰无效的提示指令,精炼出真正能够对 Agent 产生确定性增益的高价值规则。
7. 本地开发环境已显局促,全面转向远程沙箱
随着 Agent 开始承担端到端验证的工作,本地开发(Local Dev)体验已经变得非常别扭且难以忍受。
每个 Agent 任务在执行时,都需要根据需要自由安装系统依赖、启动数据库容器、跑全套端到端浏览器测试。如果全挤在人类工程师的本地笔记本电脑上:
- 端口冲突频发(例如 3000/8080 端口占用);
- 本地 CPU/内存/磁盘资源严重争抢;
- 依赖版本与全局环境变量互相污染。
在云端远程沙箱或轻量虚拟机中,每个 Agent 拥有一个完全隔离、随开随毁的干净环境。让 Agent 在云端无拘无束地测试与搞破坏,本地开发只需要保留轻量的终端和观察视图。
8. 不要陪 Agent 单步拉扯,让它构建工具来自我迭代
很多人的使用习惯依然是:“改一下这个……啊不对,再改一下那个试试。”这种单步来回拉扯效率极低。
正确的做法是:让 Agent 自己写工具来辅助高阶决策与对比。
在方案空间(Solution Space):
“针对这个交互,给我生成 20 种不同的实现变体,并同时写一个轻量的前端对比页面,让我能通过开关快速组合、浏览并挑选它们。”
在问题排查空间(Problem Space):
“针对系统请求延迟暴涨的问题,先给出 4 种最可能的假设理论;然后编写独立的压测脚本和日志分析,逐一全面验证这 4 种理论,给出最终结论。”
把微观的试错循环委托给工具本身,人类只负责在高阶聚合层进行评审与决策。
9. 索要“不可辩驳的证据(Irrefutable Proof)”:最大的 Game Changer
如果说有什么做法能彻底改变你与 Agent 的信任关系,那就是坚决要求不可辩驳的证据。
Agent 极其擅长生产确凿的证据:
- 完整的端到端自动化测试通过录屏或 Walkthrough 日志;
- 真实界面交互的无头浏览器操作截图或录像;
- 优化前后严谨的基准性能压测数据对比表格。
建立对 Agent 的信任不能建立在“自我汇报”上。直接把这一条写进代码库的 AGENTS.md:
“模型自己的口头声称不是有效证据(This is not evidence)。必须附带完整的端到端运行结果、数据对比或日志证明。”
10. 不要等 Agent,让 Agent 等你
如果你在使用 Agent 时还在死盯着“首字生成时间(TTFT)”或者焦急地等待单句回复,说明你的工作方式依然停留在对话时代。
全面拥抱异步(Lean into Async):
- 给出颗粒度更大、更有野心的任务定义(例如“重构认证模块并补齐测试”);
- 触发任务后即可切走去做其他核心事务;
- 采用批处理(Batching)模式并行调度多个任务,而不是碎片化地实时往复。
让 Agent 在后台自主跑半小时完成验证后等待你检阅,而不是你坐在屏幕前等待它打出下一个单词。
11. 自动化调度、唤醒与心跳是绝对的杀手级特性
许多团队起初并没有意识到后台心跳(Heartbeat)与唤醒(Wake-up)有多重要,直到这个功能被临时关掉时,才发现研发工作流几乎瘫痪。
在生产体系中,这种定时与被动触发无处不在:
- 延迟检查:“在这次部署完成 2 小时后,自动去生产日志里拉取 Error 速率并给我报告。”
- 事件唤醒:“PR 合并且预发环境健康检查通过后,立刻唤醒并通知我进入下一步。”
- 周期巡检:“每天早上 9 点,对系统中核心链路的 API 响应时间进行全量扫描。”
长生命周期与定时唤醒,让 Agent 从单纯的被动反应工具变成了永不停歇的守护进程。
12. 停止手动精打细算上下文
很多人至今还在花费心智纠结:“我这一轮到底消耗了 300k 还是 380k Tokens?”
这是纯粹的精力浪费。
现代 Agent 框架的上下文压缩(Compaction)机制已经进化得极其成熟与高效。不要手动去剪辑、清理上下文,贯彻最简单优雅的规则:
- 一个任务对应一条对话线程(One thread = one task);
- 简单的任务可能只有 46 条消息,极度复杂的长程任务可能有 3,714 条消息;
- 信任系统的上下文摘要与淘汰机制,把大脑留给业务逻辑。
13. 对话线程即公司的数字化组织记忆
在像 Amp 这样的现代 Agentic 开发环境中,每一次与 Agent 的交互线程都会直接关联到最终落地的 Git Commit。
这带来了前所未有的知识复利:
过去看一段古老的代码,哪怕有 git blame,你也只能看到“谁在什么时间改了这行代码”,却永远无法得知当初为什么做出这个艰难的折中。
而现在,点击提交记录就能直接跳转到当时完整的对话线程:
- Agent 尝试了哪些替代方案?
- 遇到了哪些隐性边界条件?
- 为什么要采用这种架构设计?
团队用得越多,组织记忆就越丰富。它彻底避免了后人踩坑和重复劳动的悲剧。
14. 别让 Agent 代替人类沟通,除非是纯机械内容
不要让 Agent 代表你去给同事写人情世故的邮件、写 Slack 闲聊、或者假装人类的情感交流。这只会产生令人不适的虚假感。
将 Agent 的文本输出严格限定在事实驱动的机械性场景:
- 故障排查步骤清单(Debugging steps);
- 事故复盘调查报告(Incident Reports);
- 技术接口变更备忘录与 Release Notes。
在这些场景下,接收方只关心信息的准确度、完整度与逻辑结构,而不需要多余的情感修饰。
15. 只审查高爆炸半径的代码
代码审查(Code Review)的策略必须随之重塑。
一个中大型的代码库中,通常只有不到 5 个真正关乎系统生死的架构核心文件——例如基础认证路由、全局状态流转中枢和数据库迁移脚本(Database Migrations)。只有这些文件值得人类工程师逐行推敲。
至于具体实现细节:
- 是用闭包还是类?
- 类型声明是否绝对优美?
- 变量名是否符合某个特定工程师的偏好?
- 局部是否有几行轻微重复?
在 2026 年底,我们真的不再关心这些琐碎细节了。 真正关键的审查问题只有四个:
- 它能在生产环境中正确工作吗?
- 在“系统架构图上的箭头流向”这个层级,你能理解它的数据流动吗?
- Agent 是否已经通过严格的测试进行了全链路端到端验证?
- 如果一个月后业务逻辑发生变化,我们可以轻易地修改或替换它吗?
如果答案都是肯定的,那么代码就是健康的,直接合并上线。
总结:从“辅助工具”到“全自动系统”的跃迁
回顾这 15 条准则,它们共同指向了一个核心事实:
AI 编程的竞争,早已不是“谁的 Prompt 写得更好看”,而是“谁能为 Agent 构建一个更真实、更完整、更有闭环约束的软件工程运行系统”。
| 传统/过渡期视角 | 2026 后期成熟 Agentic 视角 |
|---|---|
| 使用便宜模型节省 Token | 坚决使用最强旗舰模型,消除不确定性返工 |
| 担忧 AI 生成代码垃圾(Slop) | 关注系统能否端到端跑通与未来可维护性 |
| 告诉 Agent 具体怎么写(How) | 告诉 Agent 最终目标与衡量指标(What) |
| 把 Agent 限制在编辑器与本地文件 | 让整个 SDLC(部署/日志/监控/灰度)对 Agent 可见 |
| 人机单步微调,紧盯首字延迟 | 异步大颗粒度批处理,让 Agent 自行开发工具迭代 |
| 依赖 Agent 自我声称的完成度 | 强制要求不可辩驳的运行证据与录屏/数据 |
| 人工逐行挑剔语法、变量名与风格 | 只审查 <5 个高爆炸半径核心文件与数据库变更 |
将整个生命周期向 Agent 敞开,为它提供不可辩驳的物理世界反馈,让它成为系统可靠性的最终交付者。