生产环境中的 AI Agent 如何自我修复
快速阅读
文章介绍了 LangChain 软件工程师 Vishnu Suresh 为其 GTM Agent 构建的一套自动化部署与自我修复流水线。在代码部署到生产环境后,该系统能自动捕获构建失败或运行时的服务端错误,通过泊松分布测试(Poisson Test)将因最新部署引起的新增报错从日常背景噪音中剥离出来。随后,通过专门的 Triage Agent(归因智能体)分析报错与代码 Diff 的因果关联,如果确认是本次部署引发的问题,系统会自动唤醒代码修复智能体(Open SWE)进行修复并提交 PR(Pull Request),整个过程无需人工干预。这种模式代表了未来自动化运维的趋势,让工程师能将更多精力投入到开发而非盯着监控仪表盘。
作者:Vishnu Suresh, Software Engineer @ LangChain
本文介绍了我如何为我们的 GTM Agent 构建一个自我修复的部署流水线。在每次部署之后,它能自动检测性能回退( regressions ),判断这些问题是否由代码变更引起,并启动一个 Agent 自动开一个修复 PR——直到最终代码审查(review)之前,完全不需要人工干预。
软件发布的难点并不在于把代码部署出去,而在于部署之后的一切:弄清楚你的最后一次部署是否破坏了什么东西、是否真的是你的错,以及在用户发现之前把它修好。我希望能做到:一经部署就能放手不管,如果出现问题,系统会自己捕获并形成自我修复的闭环。
自我修复流程是如何工作的?
我们的 GTM Agent 运行在 Deep Agents 上,通过 LangSmith Deployments 进行部署。我们内部已经有一个叫 Open SWE 的开源异步代码智能体,它可以研究代码库、编写修复代码并提交 PR。我们唯一缺少的一环,就是自动化检测性能回退并进行问题分诊(Triage),以此把生产环境的错误与 Open SWE 串联起来。
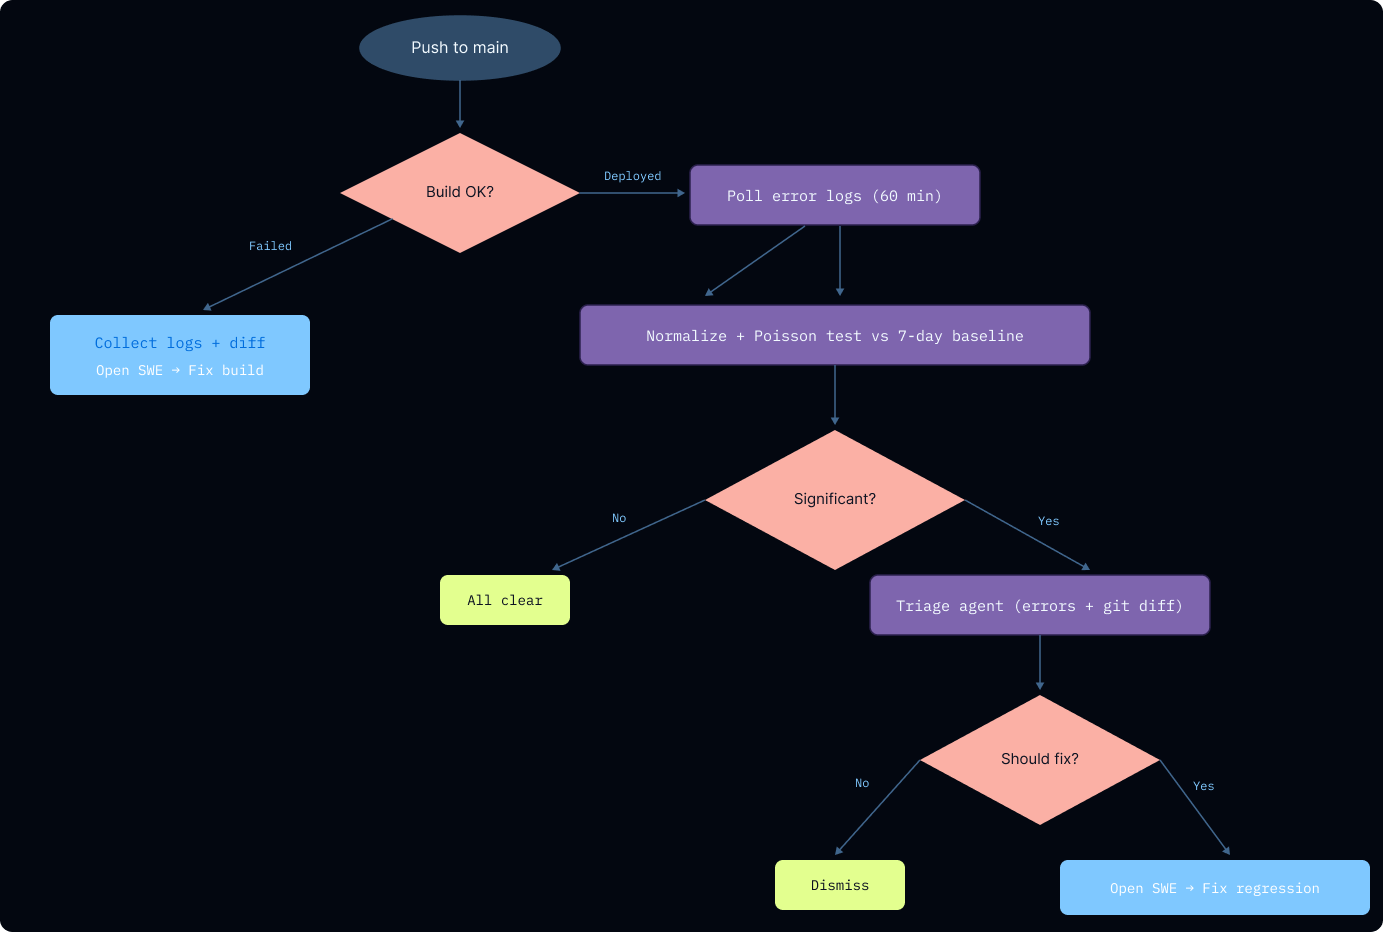
在代码部署到 main 分支后,一个用于自我修复的 GitHub Action 会被触发,捕获构建和服务器日志。该流程分为两条路径:立即捕获构建失败,以及在监控窗口内检测服务端回退问题。如果任何一条路径发现真实存在的问题,就会启动 Open SWE 去修复它并提交 PR。
捕获 Docker 构建失败
首先,我们会检查构建日志,确保 Docker 镜像能正常构建。如果镜像构建失败,流水线会自动从命令行提取错误日志,获取最近一次提交的 Git Diff,并将其交给 Open SWE 处理——整个过程无需人工介入。构建失败几乎总是由最近的更改引起的,因此一个明确的 Diff 就能为 Open SWE 提供足够的修复上下文。
监控部署后的错误
服务端的异常问题往往比构建失败更加棘手。任何生产系统都会存在一定的背景错误率,包括网络超时、第三方 API 问题以及瞬时故障等。在理想的世界里,你希望能追踪并修复每一个错误;但当你想知道“我刚刚的部署是否弄坏了什么”时,你需要将代码更改引发的错误从本就存在的背景噪音中剥离出来。这一步的作用就在于此。
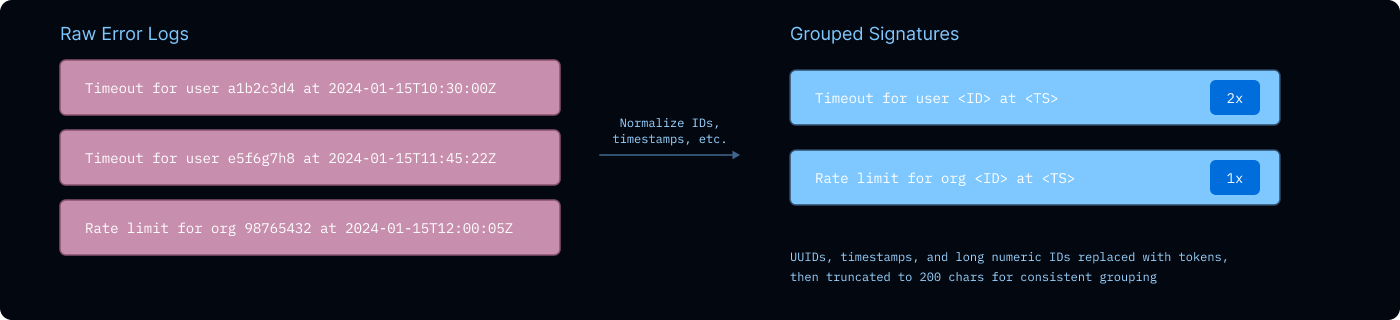
首先,我会收集过去 7 天内所有的错误日志作为基线(baseline)。将这些日志规范化成错误签名(error signatures):使用正则替换掉 UUID、时间戳和长数字符串,并将其截断为 200 个字符。这样,即使具体细节不同,逻辑上相同的错误也会被归类在一起。
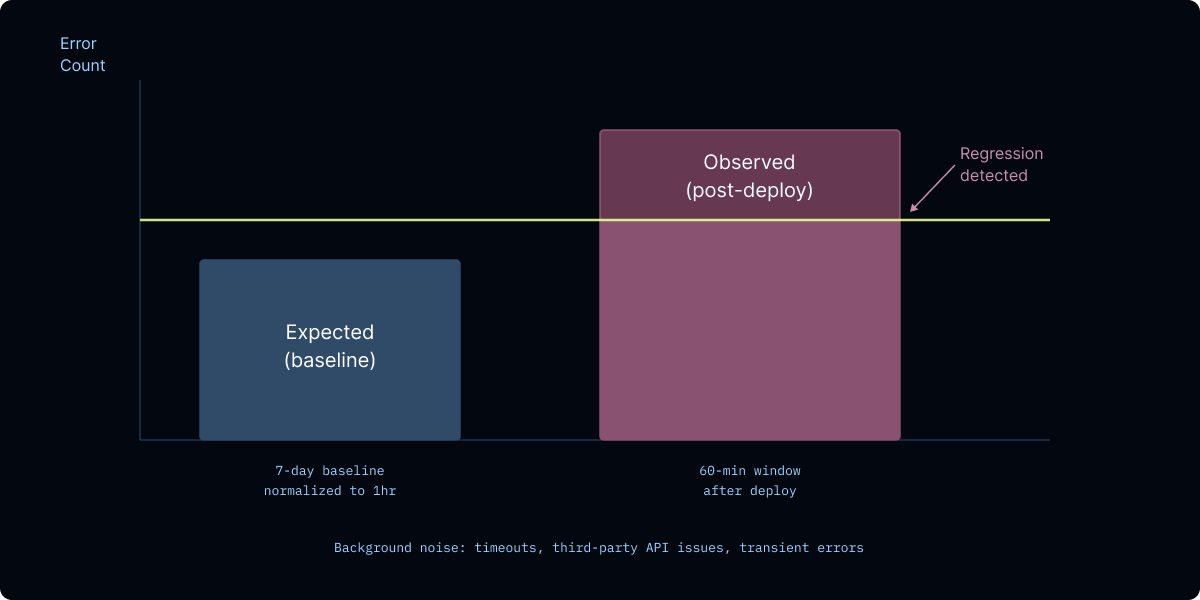
接下来,我在部署后的 60 分钟窗口内轮询当前版本的错误,并以相同的方式进行归一化。监控窗口结束后,我就有了两个完全不同时间尺度的错误数据:一周的基线数据和一个小时的部署后数据。
虽然我可以直接比较这两个数字来检测最新更改是否引起了错误,但我想要采用一种更科学的方法。
使用泊松检验(Poisson Test)进行拦截
泊松分布可用于模拟在已知平均发生率 (λ) 和假设事件相互独立的情况下,某一事件在固定时间间隔内发生的次数。
我认为任何生产系统都携带着一些背景错误,这些基线错误相当符合泊松模型。
利用 7 天的基线数据,我估算出每个错误签名每小时的预期错误率,然后将其缩放到 60 分钟的部署后窗口中。如果实际观察到的错误次数明显超过了分布预测值(p < 0.05),我就将其标记为潜在的问题回退(regression)。对于完全属于新增的错误签名(基线中根本不存在),如果它们在监控窗口内重复出现,我也会将其标记出来。
但服务器错误并不总是相互独立的。由流量激增或 API 宕机引起的相关性故障可能会打破独立性假设,单靠统计测试无法区分“错误激增是因为代码变更”还是“因为第三方 API 挂了”。因此,我们需要引入 Triage(分诊) Agent。
分诊 Agent(Triage Agent)
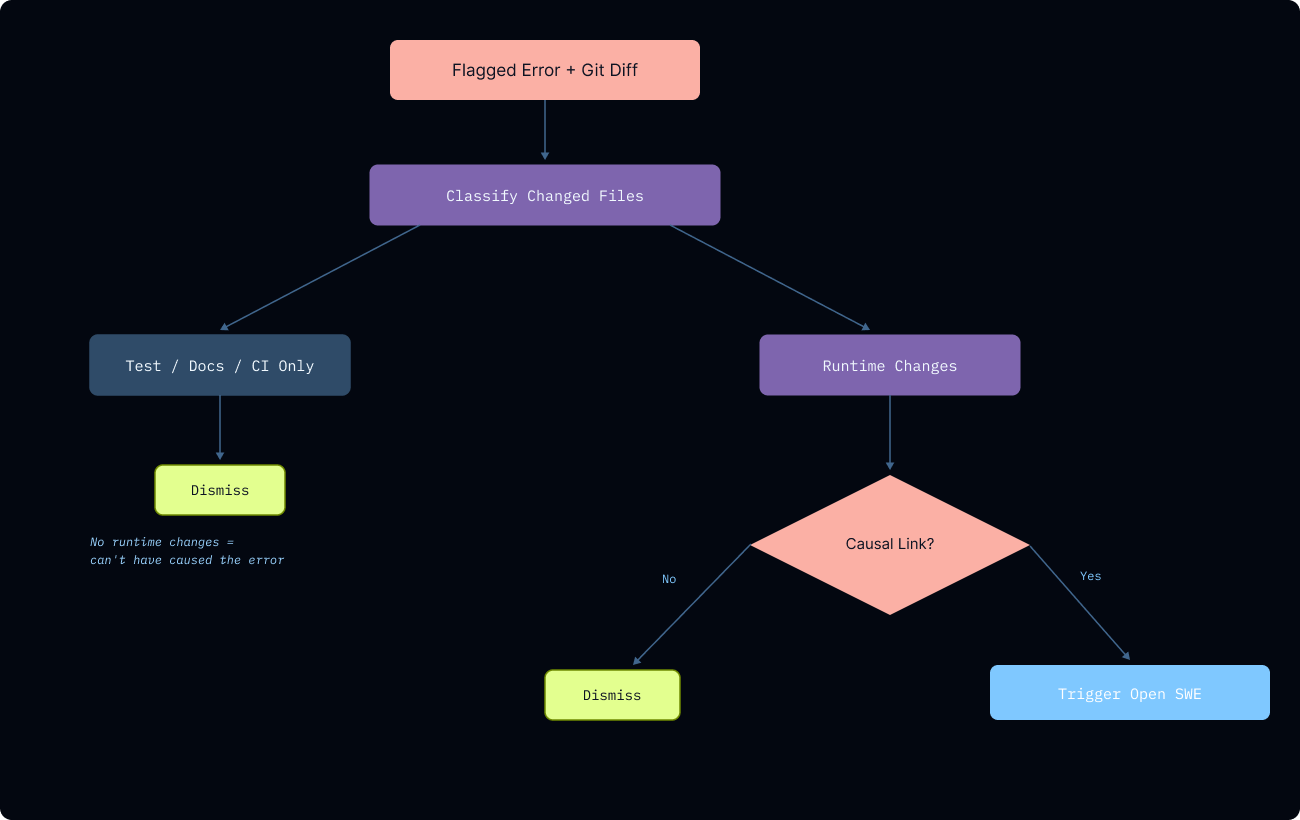
我们没有把错误直接喂给 Open SWE(它容易直接就去改代码),而是添加了另一个拦截机制。最近一次提交的 diff 和特定的报错信息会被传递给基于 Deep Agents 构建的 Triage Agent。
首先,Triage Agent 会对修改过的文件进行分类:运行时代码(runtime)、提示词/配置(prompt/config)、测试(test)、文档(docs)或 CI。如果某次部署仅触及了非运行时文件,那么它极大概率不是引发错误的原因。这能有效防止假阳性问题(即 Agent 产生幻觉,将测试文件的更改错误地与生产 Bug 关联起来)。
对于运行时的变更,Agent 必须在代码 Diff 中的特定代码行与观察到的报错之间建立起具体的因果联系。
最终,该 Agent 返回一个结构化的裁决,包含其决策、置信度、推理过程以及它归咎于变更的错误签名。这种聚焦机制意味着 Open SWE 收到的是一个具有明确调查方向的提示词,而不是一大堆激增错误数据的垃圾场。
与 Open SWE 闭环修复
一旦 Triage Agent 给调查开了绿灯,Open SWE 就会接管流程,解决该 Bug 并提交 PR。当它准备好进行 review 时,我会收到通知。所以从发现错误到提出修复方案的整个流程完全不需要人工干预。
到目前为止,它在捕获那些“不会大声崩溃”的 Bug 时最为有用:比如返回错误默认值的静默故障、代码与部署环境的配置不匹配,以及修复一个 Bug 后会在下次部署中暴露下一个 Bug 的级联问题。
未来的改进方向
更长的回溯窗口
目前的 Triage Agent 仅仅查看当前版本和上一个已部署版本之间的 Diff。在更早的部署中引入、但后来才暴露的 Bug 将无法自动归因。显而易见的解决方法是加宽回溯窗口,但送入 Triage 的 Diff 越多,信号就越嘈杂,确定因果联系就越困难。我目前还没找到最完美的平衡点。
更智能的错误分组
当前的方法是通过正则去除非法 ID 和时间戳来进行模糊匹配。这花了我一些时间来调整,而且由于清理逻辑的局限性,肯定还是会有相关错误未能正确分组的情况。
我一直在考虑的一个想法是:将错误消息转化为向量并进行聚类,而不是依赖正则归一化。无论表面有什么差异,含义相同的错误自然会聚集在一起;我们可以通过监控新聚类的形成或部署后现有聚类的增长来检测问题回退。挑战在于如何调整距离阈值,以区分正常的随机波动与有意义的集群变化。
另一个选择是使用一个更小、更便宜的模型来对错误进行分类和分组,然后将这些结构化的集群直接传递给 Open SWE ——这能让它更全面地了解什么是失败的以及完整的错误情况。
向前修复 (Fix-Forward) vs 回滚 (Rollback)
现在系统总是选择“向前修复(Fix-Forward)”,Open SWE 会着手处理 PR,同时损坏的部署版本继续在运行。一个更智能的策略是基于严重性、错误率和归因置信度在两者之间做出选择。一个高严重性且归因置信度低的故障激增,可能需要立即执行回滚(Rollback);而一个能够明确归因且有清晰修复路径的 Bug,更适合通过向前推送补丁的方式来解决。
结论
我认为这种模式在未来的部署服务中将变得越来越普遍。当你的系统越能够自我检测、自动归因分析并修复它自身的退化问题时,你的发布速度就能越快,而工程师们就能省下盯着仪表盘的时间去创造更多功能。