LangChain 如何打造全自动 GTM(走向市场)AI 智能体
快速阅读
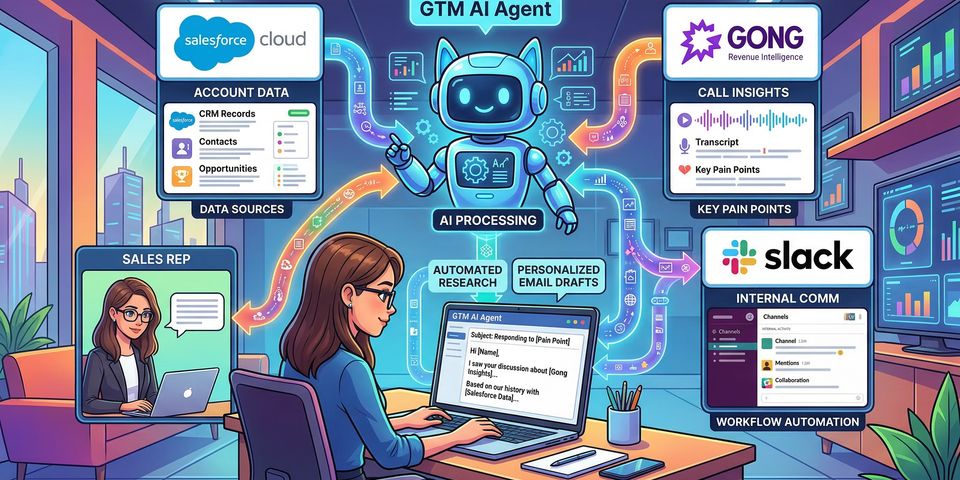
LangChain 的销售团队过去总是要在 Salesforce、Gong、LinkedIn 等多个标签页间来回切换,耗费大量时间进行线索背景调研。为了解决这个问题,他们构建了一个端到端的 GTM(Go-To-Market)智能体。该智能体可以自动根据新的 Salesforce 线索触发,收集跨平台上下文(包括会议记录和网络信息),并为销售代表生成带有推理依据的 Slack 邮件草稿。
核心成果:
- 销售线索到合格商机(Qualified Opportunity)的转化率从 2025 年 12 月到 2026 年 3 月飙升了 250%,带来了 3 倍的管道收入。
- 银牌线索的跟进率提升了 97%,金牌线索提升了 18%。
- 每位销售代表每月节省了 40 小时,整个团队共节省 1320 小时。
通过“人类在环(Human-in-the-loop)”审核、子智能体委派(Subagent delegation)和记忆机制(Memory),该系统不仅确保了对外沟通的安全,还能随着销售代表的修改不断学习进化。
开发初衷与核心目标
在开发任何代码之前,LangChain 团队就明确了智能体需要完成的任务。他们的目标有两个:减少销售代表在每个线索上花费的调研和起草时间,同时提高市场生成的入站(Inbound)线索转化率。对外拓展的调研和起草工作有足够的系统性可以被自动化,但前提是该系统必须安全、可审计,并且能随着使用不断改进。
不可妥协的原则(Non-negotiables):
- 人类在环(Human-in-the-loop):未经销售代表明确审核和批准,系统绝不能发送任何内容。一封不合时宜的邮件可能会毁掉几个月的关系建设。
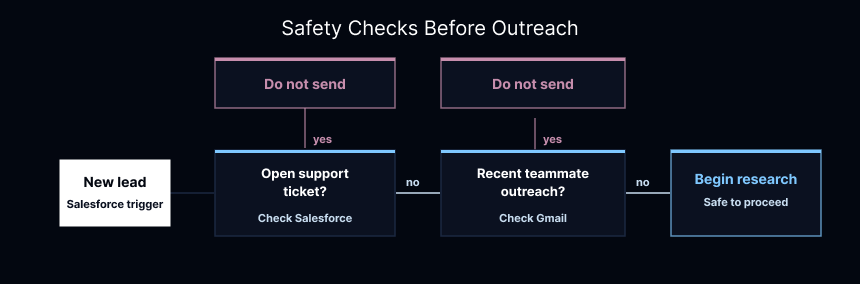
- 联系历史可见性:在起草任何内容之前,智能体必须检查团队中是否已经有人联系过该客户。
智能体核心能力:从线索处理到账户情报
GTM 智能体主要执行两项任务:(1)研究线索并撰写个性化邮件草稿;(2)汇总跨越网络活动、开发者生态、产品使用和营销触点的账户级别信号,告诉销售代表接下来该关注什么。
入站线索处理 (Inbound Lead Processing)
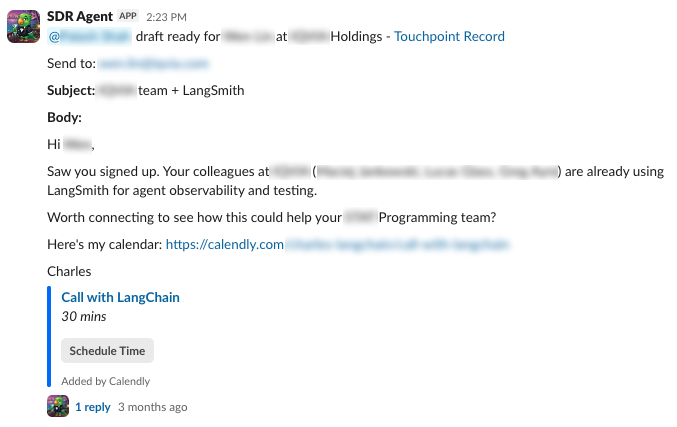
当 Salesforce 中出现新线索时,智能体立即接管。它做的第一件事是寻找不发送邮件的理由(例如该客户刚刚提交了支持工单,或者同事本周已经联系过)。
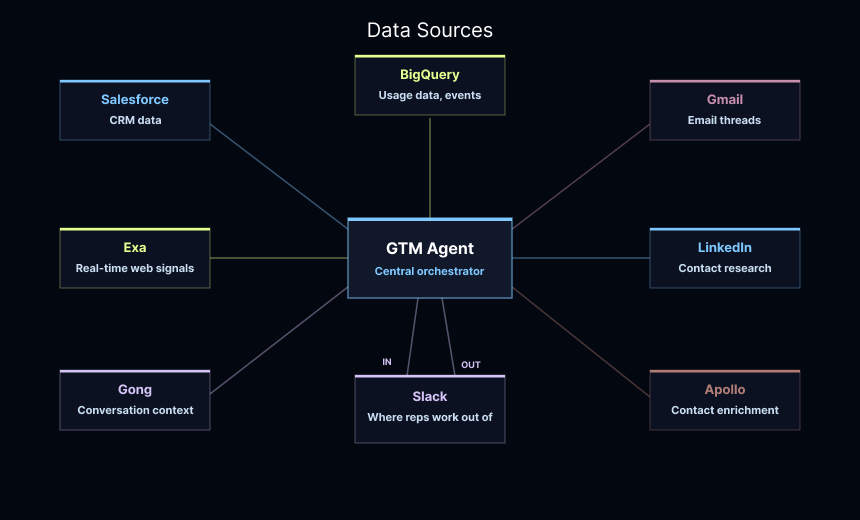
通过这些检查后,它会执行销售代表以前手动完成的研究:提取 Salesforce 完整记录、阅读 Gong 会议转录、查看 LinkedIn 个人资料。如果内部历史记录不多,它会使用 Exa 搜索引擎去网络上了解该公司在 AI 方面的最新动态。
邮件的起草方式取决于客户关系的当前状态,遵循预设的 “Outbound Skill” 剧本。完成的草稿会通过 Slack DM 发送给销售代表,包含发送、编辑或取消按钮,同时还会附上智能体的“推理过程”。
账户情报与扩展 (Account Intelligence)
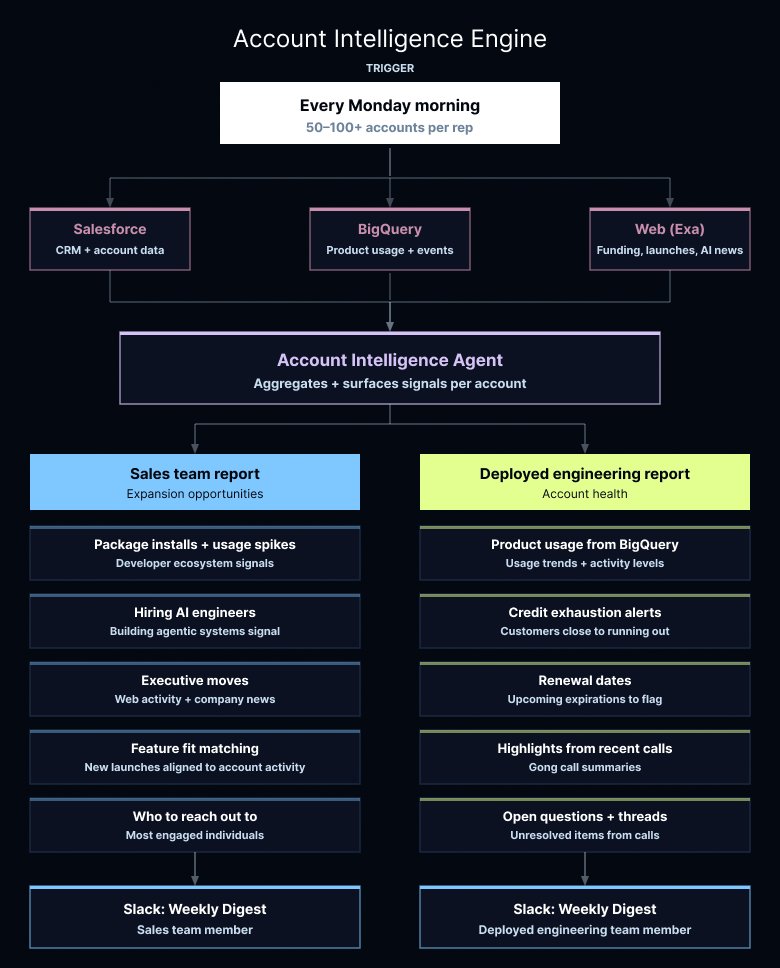
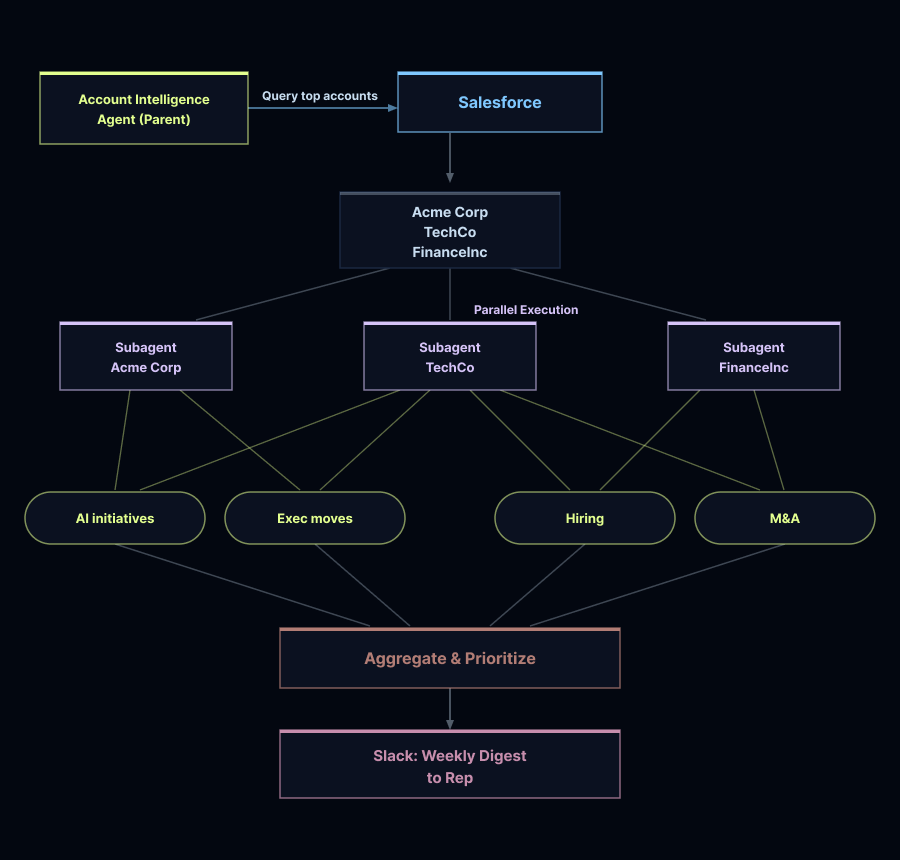
随着团队规模扩大,每个销售代表负责的账户多达 50 到 100 个。每周一早晨,智能体会从 Salesforce 和 BigQuery 中提取数据,并搜索外部的融资轮次、产品发布和新的 AI 计划。
对于销售团队,智能体会汇总信号以发现扩展机会(例如高管变动、软件包安装量激增,或公司正在积极招聘 AI 工程师)。对于部署工程师,关注点则转移到账户健康状况(如积分即将耗尽的客户、最近电话中的未解决问题)。
技术实现:深层编排与模式
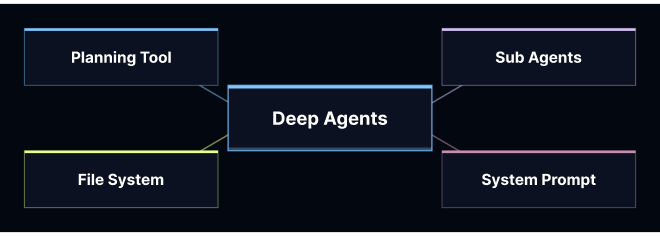
为了实现多数据源推理并产生个性化输出,LangChain 选择在 Deep Agents 架构上进行构建。因为输入数据(会议数据、CRM 历史、网络研究)在大小和结构上差异很大,Deep Agents 能将庞大的工具调用结果自动卸载到虚拟文件系统中。
将 GTM 智能体推向生产环境面临两个核心问题:如何让智能体从使用者身上学习,以及如何在大规模运行时保持高效?
记忆机制 (Memory)
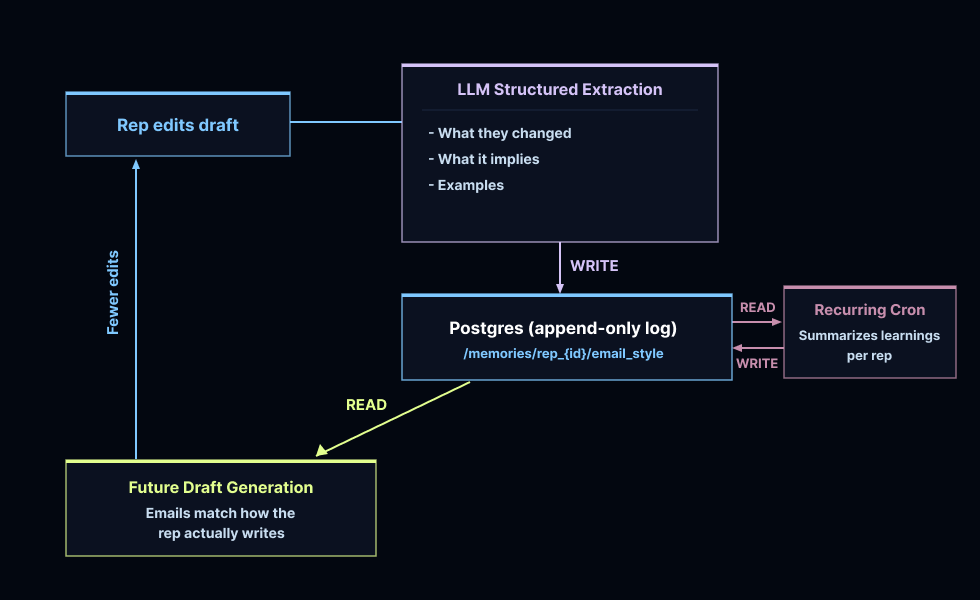
当销售代表在 Slack 中编辑草稿时,系统会将原版与修改版进行比较。如果变化很大,LLM 会分析差异并提取结构化的风格观察结果:修改了什么、这意味着什么偏好等。这些“记忆”以销售代表为维度存储在 PostgreSQL 中,未来的每一次运行都会先读取这些偏好。
子智能体委派 (Subagent Delegation)
账户情报通过编译的“子智能体”运行。这些轻量级智能体拥有受限的工具集和结构化的输出模式。例如,销售研究子智能体拥有 Apollo、Exa 和 BigQuery 的访问权限;部署工程师子智能体则使用 Salesforce 和 Gong。主智能体会为每个账户生成一个子智能体,通过并行执行来保证系统的可靠性和水平扩展。
评估与反馈 (Evals and Feedback)
在为新工作流编写任何生产代码之前,LangChain 首先在 LangSmith 中定义了“成功”的标准。一旦系统具备基本功能,他们就会在 LangSmith 中扩大评估集,以覆盖更困难的边缘情况(如深耕 Agentic AI 的研究员、医疗健康等垂直领域)。评估不仅包括基于规则的断言(是否使用了正确的工具),还引入了 LLM 评委对语气和格式进行打分。
真正的闭环在于实际使用:系统会跟踪每个 Slack 操作(发送、编辑、取消),并直接将其附加到 LangSmith 的追踪记录中,这成为了智能体不断改进的最强信号。
意外的跨团队采用
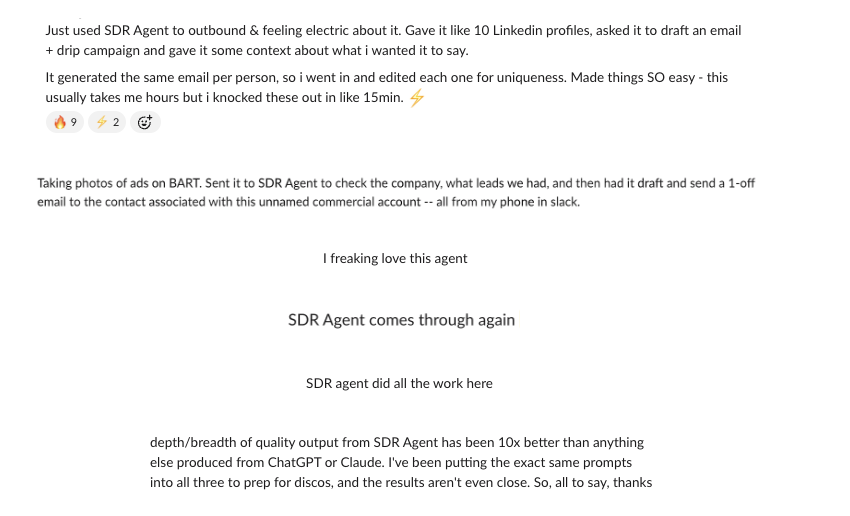
GTM 智能体最初只是作为一个在后台运行的“环境智能体(Ambient Agent)”。后来,LangChain 团队构建了一个对话式的 Slack 界面,原本只是想给 SDR(销售开发代表)一种直接交互的方式。
但令人意想不到的是,这种用法迅速蔓延到了公司的其他部门。工程师通过它查询产品使用情况而无需编写 SQL;客户成功团队在续约电话前提取支持历史记录;客户主管在会议前让它总结 Gong 的文字记录。人们自然而然地发现:与机器人交谈,远比打开六个不同的标签页要容易得多。
核心经验总结
- 从成功的定义开始,而不是代码:在写任何代码前,建立涵盖实际场景的评估库。
- “人类在环”不仅仅是安全网:它是一个极其有效的数据收集机制,每一次修改都是对模型的一次微调教学。
- 从一开始就连接核心记录系统:自然而然地跨团队采用,源于智能体已经获得了大家需要的数据权限。
- 长时间运行的工作流需要合适的基础设施:处理多数据源和并行子智能体,必须有合适的编排框架支撑。