通过 Harness 工程提升深度 AI Agent 性能
快速阅读
这篇文章分享了如何通过“Harness 工程”(Harness Engineering)将一个编码 Agent 在 Terminal Bench 2.0 排行榜上的成绩从前 30 名提升至前 5 名。作者团队没有改动底层大模型(始终使用 gpt-5.2-codex),而是通过优化包围大模型的系统架构(Harness),包括系统提示词、工具和中间件来实现性能的大幅跃升。核心的优化手段包括:引入自动化 Trace 分析(Trace Analyzer Skill)来调试和发现 Agent 的错误模式;强制 Agent 执行构建与自我验证(Build & Self-Verify)的循环以避免代码“写完就跑”的缺陷;为 Agent 注入环境上下文(如目录结构和时间预算);以及调整推理算力分配(例如在计划和验证阶段分配更多算力)。
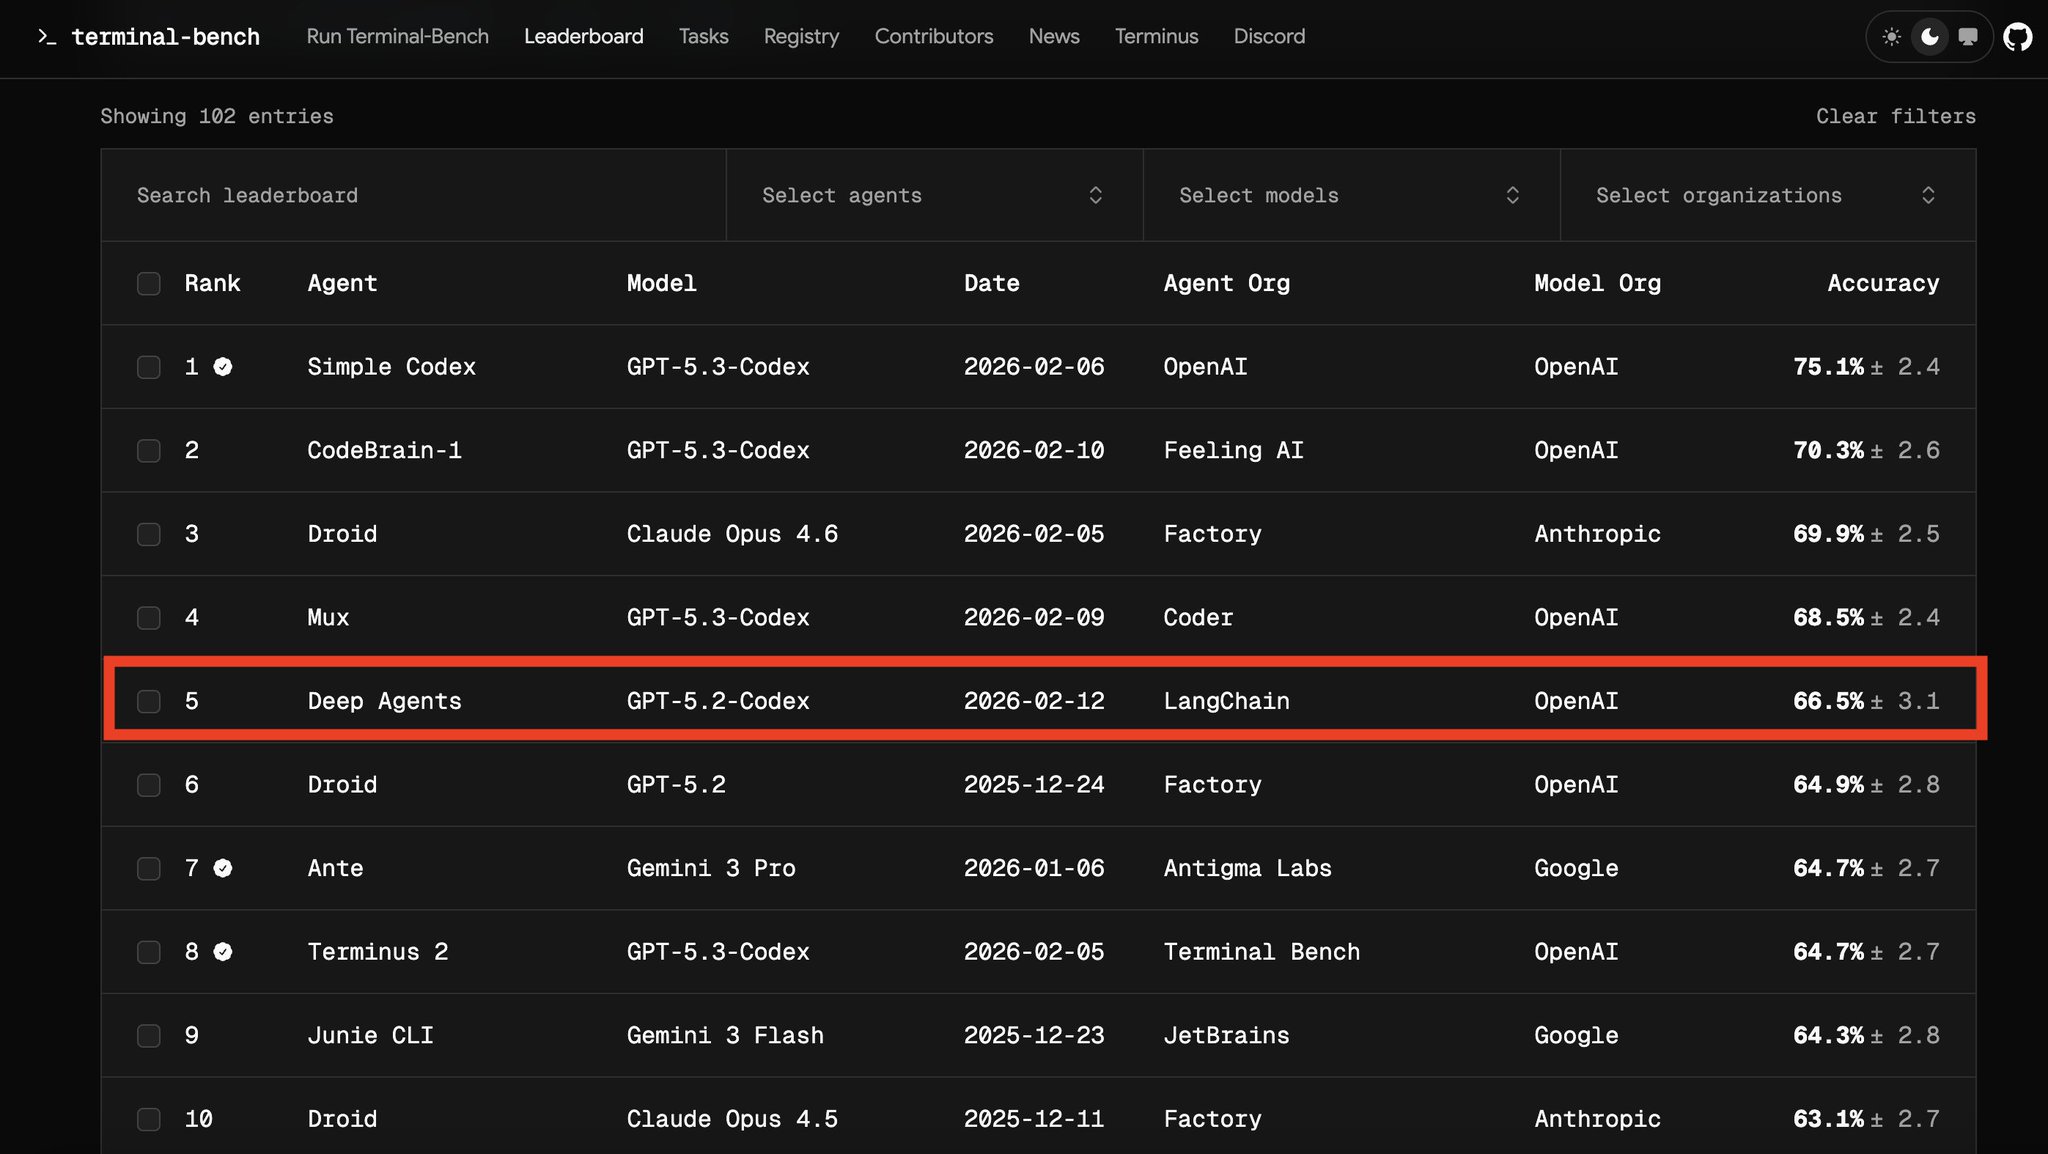
我们的编码 Agent 在 Terminal Bench 2.0 的排行榜上从前 30 名跃升至了前 5 名。在这个过程中,我们仅仅修改了它的“Harness(控制流架构)”。本文将分享我们的 Harness 工程方法(剧透:自我验证和 Trace 追踪在其中发挥了巨大作用)。
Harness 工程的目标
Harness 的目标是重塑模型固有的、有时不稳定的智能,使其更好地适应我们关心的特定任务。Harness 工程是一项系统工程,你需要围绕模型构建工具集,以优化任务表现、Token 效率、延迟等目标。这其中的设计决策包括:系统提示词、工具选择以及执行流程。
那么,究竟该如何修改 Harness 来改进你的 Agent 呢?
在 LangChain,我们使用 Traces(运行轨迹)来大规模理解 Agent 的失败模式。如今的模型在很大程度上是黑盒,其内部机制难以解释,但我们可以通过文本形式看到它们的输入和输出,并将其用于迭代改进的循环中。
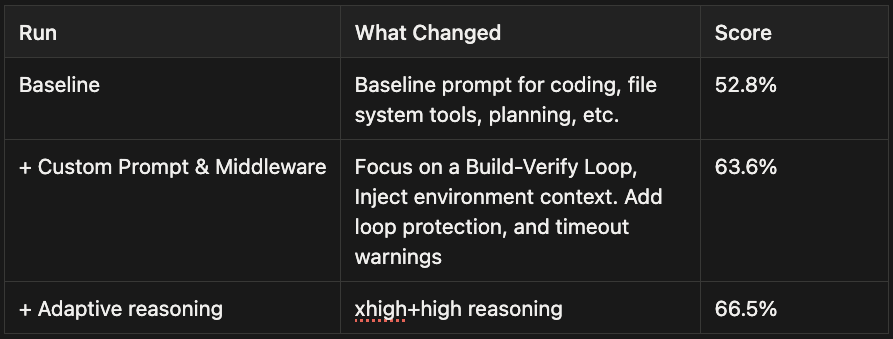
我们使用了一个简单的“秘方”,成功将 deepagents-cli(我们的编码 Agent)在 Terminal Bench 2.0 上的得分从 52.8 提升至 66.5(整整提高了 13.7 分)。在这整个过程中,我们保持了底层模型固定为 gpt-5.2-codex,只对 Harness 进行了微调。
实验设置与 Harness 的可调旋钮
我们使用了 Terminal Bench 2.0,这是一个现如今用于评估智能体编码能力的标准化基准测试。它包含了横跨机器学习、调试、生物学等多个领域的 89 项任务。
我们使用 Harbor 来编排整个运行过程:它会启动沙箱(Daytona),与我们的 Agent 循环进行交互,并执行验证和评分。Agent 的每一个动作都被存储在 LangSmith 中,其中还包含了延迟、Token 消耗和成本等指标数据。
我们可以调节的“旋钮”
一个 Agent Harness 拥有很多可调节的“旋钮”:系统提示词(System Prompts)、工具(Tools)、钩子/中间件(Hooks/Middleware)、技能(Skills)、子 Agent 委派(Sub-agent delegation)、记忆系统等等。
我们刻意压缩了优化空间,将重点放在了三个方面:系统提示词、工具 和 中间件(Middleware)(这是我们对包围模型和工具调用的钩子的术语)。
我们以默认提示词和标准的工具+中间件作为起点。在 GPT-5.2-Codex 下,这一基线得分为 52.8%。这是一个不错的分数,目前刚好在排行榜前 30 名之外,但还有很大的提升空间。
Trace 分析技能 (The Trace Analyzer Skill)
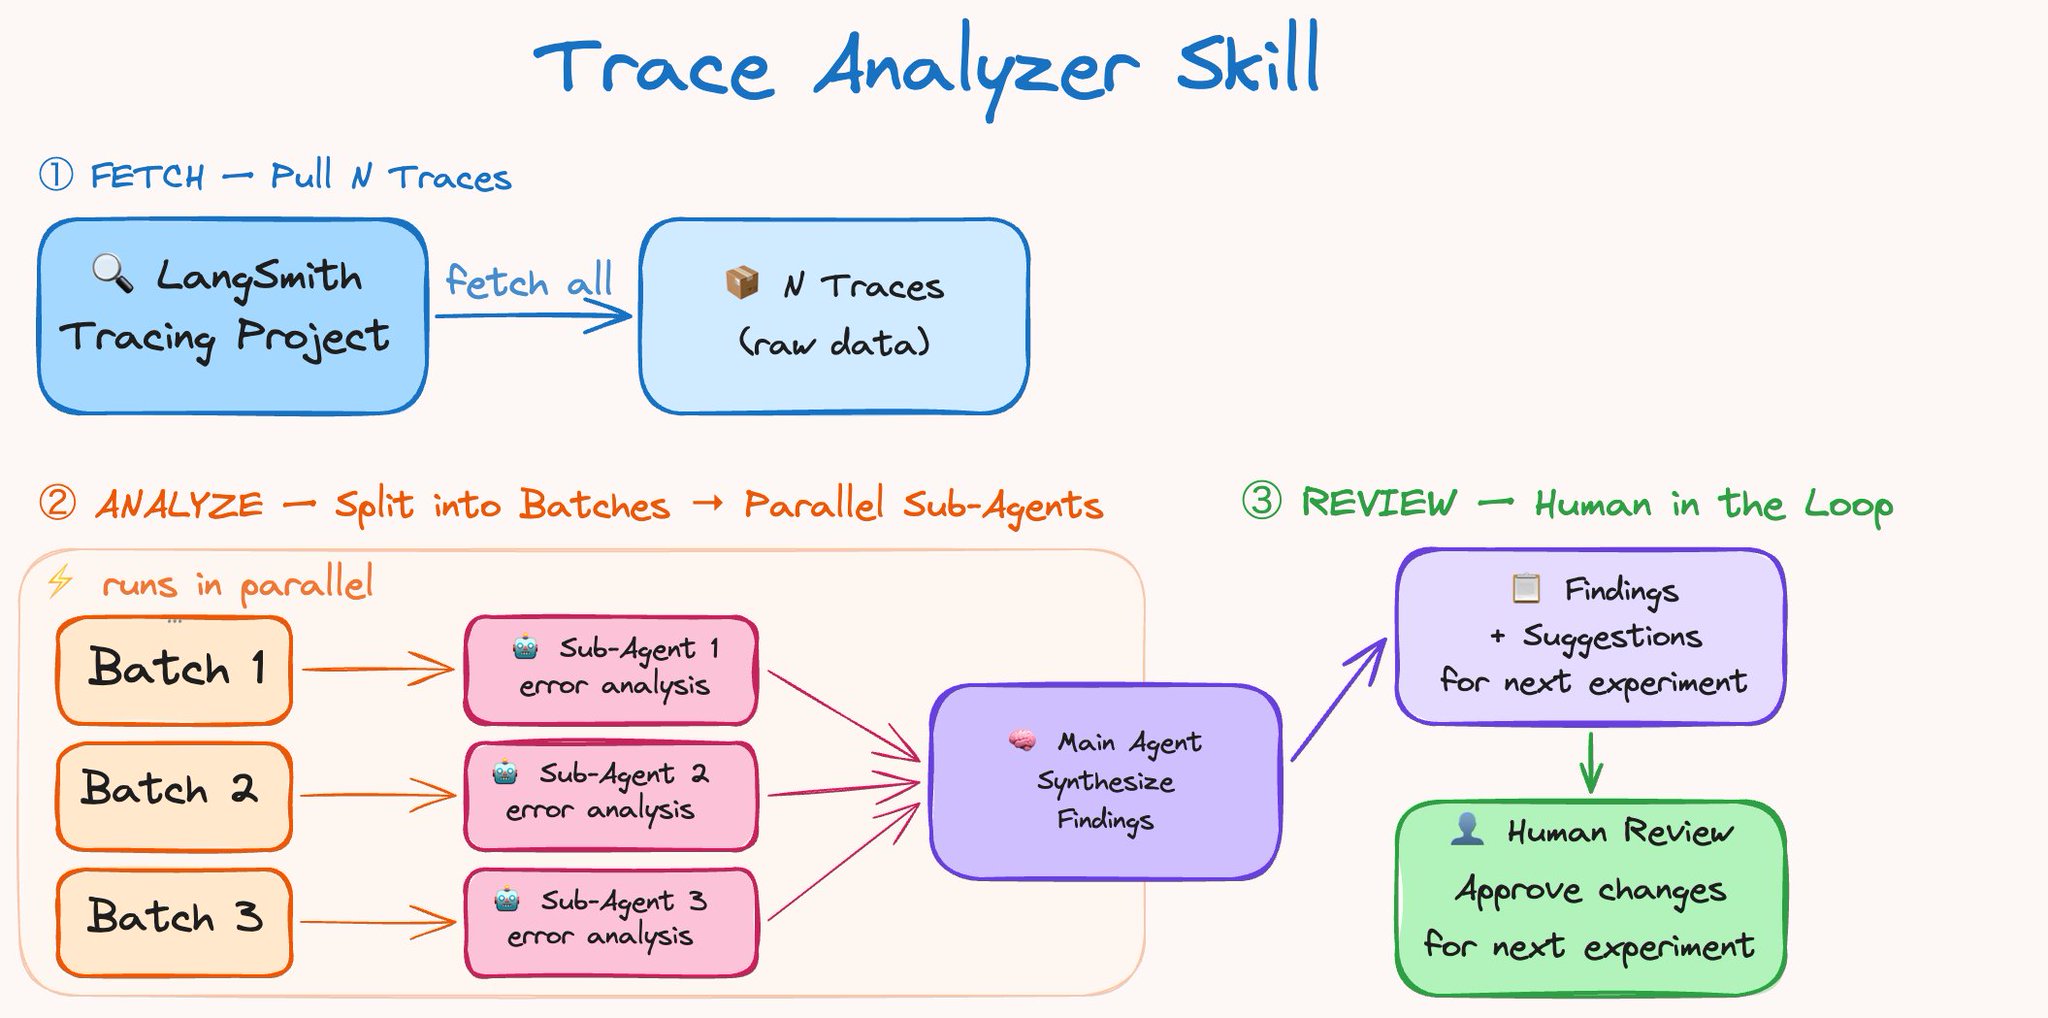
我们希望 Trace 分析的过程是可重复的,因此我们将其封装成了一个 Agent 技能。这也成为了我们分析历次运行中的错误、并对 Harness 进行改进的标准流程:
- 从 LangSmith 获取实验运行的 Traces(轨迹记录)。
- 启动并行的错误分析 Agent → 主 Agent 负责综合调查结果并提出建议。
- 汇总反馈,并对 Harness 进行针对性的修改。
这个过程类似于机器学习中的 Boosting(提升算法),其核心逻辑就是专注于前序运行中犯下的错误。人类可以在第 3 步发挥很大作用(虽然不是必需的),去验证和讨论 Agent 提出的修改建议。
那些针对单一任务“过拟合”的修改对于通用性是有害的,可能会导致其他任务出现性能倒退。自动化的 Trace 分析为我们节省了数小时的时间,让快速进行实验尝试变得非常容易。我们很快就会发布这个技能,目前正在测试它在通用提示词优化方面的表现。
实际提升性能的关键因素
自动化的 Trace 分析让我们得以诊断 Agent 到底在哪里出错了。暴露出的问题包括:推理错误、不遵循任务指令、缺乏测试和验证、超时等。
构建与自我验证 (Build & Self-Verify)
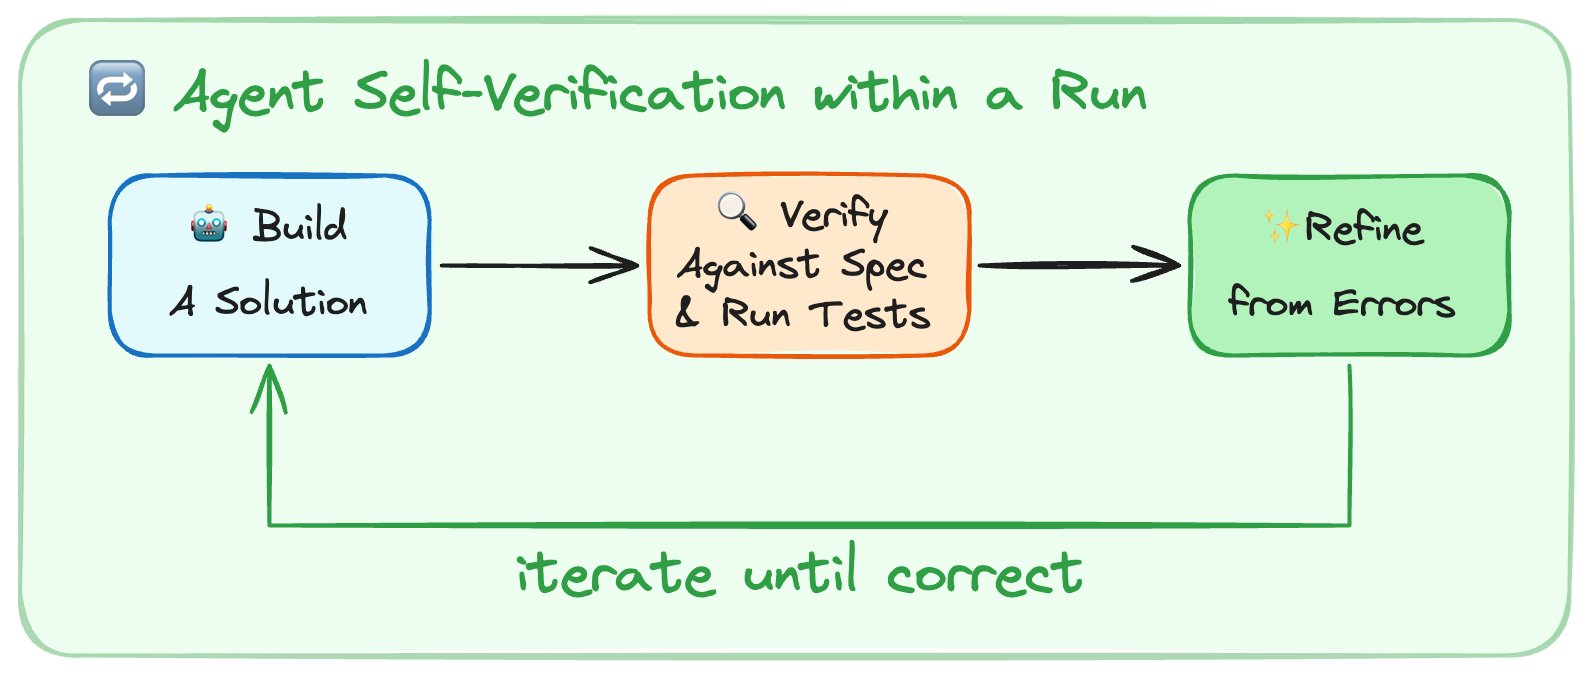
现如今的模型是出色的“自我改进机器”。自我验证机制让 Agent 能够在一次运行中通过反馈进行自我完善。然而,它们并没有天生的倾向去进入这种“构建-验证”循环。
最常见的失败模式是:Agent 写了一段解决方案,重读了自己的代码,确认看起来没问题,然后就停止了工作。
测试 是自治编码 Agent 的关键环节。它有助于测试整体的正确性,并同时为 Agent 提供可以进行“爬山优化”的信号。我们在系统提示词中加入了关于如何解决问题的方法指导:
- 规划与发现:阅读任务、扫描代码库,并根据任务规范以及如何验证解决方案来制定初步计划。
- 构建:在将验证纳入考量的前提下执行计划。如果缺乏测试则构建测试,并且要同时测试正常路径(Happy paths)和边界情况。
- 验证:运行测试,阅读完整输出,并将其与原始要求进行对比(而不是仅仅对比自己写的代码)。
- 修复:分析所有错误,重新审视原始规范,修复问题。
我们极其重视测试,因为它驱动着每一次迭代的修改。我们发现,除了提示词之外,确定性的上下文注入也能极大地帮助 Agent 验证工作。
我们使用了一个 PreCompletionChecklistMiddleware(完成前检查清单中间件),它会在 Agent 退出前进行拦截,提醒它对照任务规范运行一次验证。这类似于一个强迫 Agent 在退出前继续执行测试的钩子机制。
为 Agent 提供环境上下文
Harness 工程的一部分工作是建立一个良好的机制来进行“上下文工程”。Terminal Bench 的任务带有目录结构、内置工具以及严格的超时限制。
- 目录上下文与工具:我们使用
LocalContextMiddleware在 Agent 启动时映射当前工作目录(cwd)以及相关的父子目录。我们会运行 Bash 命令来寻找像 Python 安装路径这样的工具。 - 教导 Agent 编写可测试的代码:Agent 并不知道它们的代码需要被自动测试。我们通过提示词告知它们,其工作将受到程序化测试的衡量(类似于提交代码时的 CI 检查)。例如,强烈要求严格遵守任务规范中提到的文件路径。
- 时间预算:我们注入了时间预算警告,以此来督促 Agent 完成工作并转向验证阶段。Agent 以缺乏时间预估能力而闻名,因此这种启发式方法在测试环境中非常有帮助。
Agent 对其所在环境、约束条件和评估标准了解得越多,它们就越能自主地引导自己的工作。Harness 工程师的目的就在于:准备并交付这些上下文,以便 Agent 能够自主地完成工作。
鼓励 Agent 退一步重新考虑计划
Agent 一旦决定了某个计划,有时会变得非常“近视”,这会导致它们陷入“末日循环(Doom loops)”——针对同一个错误的方法进行微小的、无效的改动(在某些 Trace 中甚至重复了 10 次以上)。
我们使用了一个 LoopDetectionMiddleware(循环检测中间件),它通过工具调用钩子来追踪每个文件的编辑次数。如果对同一个文件的编辑次数达到 N 次,它就会向上下文注入诸如“……请考虑重新审视你的方法”这样的提示。
这能帮助 Agent 从死胡同中恢复过来。这是一项针对目前大模型缺陷而设计的工程策略。随着模型的改进,这些护栏可能将不再必要。
分配推理算力
推理模型(Reasoning models)可以自主运行数小时,因此我们必须决定在每个子任务上花费多少算力。你可以把最大推理预算用在每一个任务上,但在大多数情况下,优化推理算力的支出会带来更好的整体效益。
Terminal Bench 的超时限制带来了一个权衡:更多的推理思考有助于 Agent 评估每一步,但这可能会消耗两倍以上的 Token 和时间。
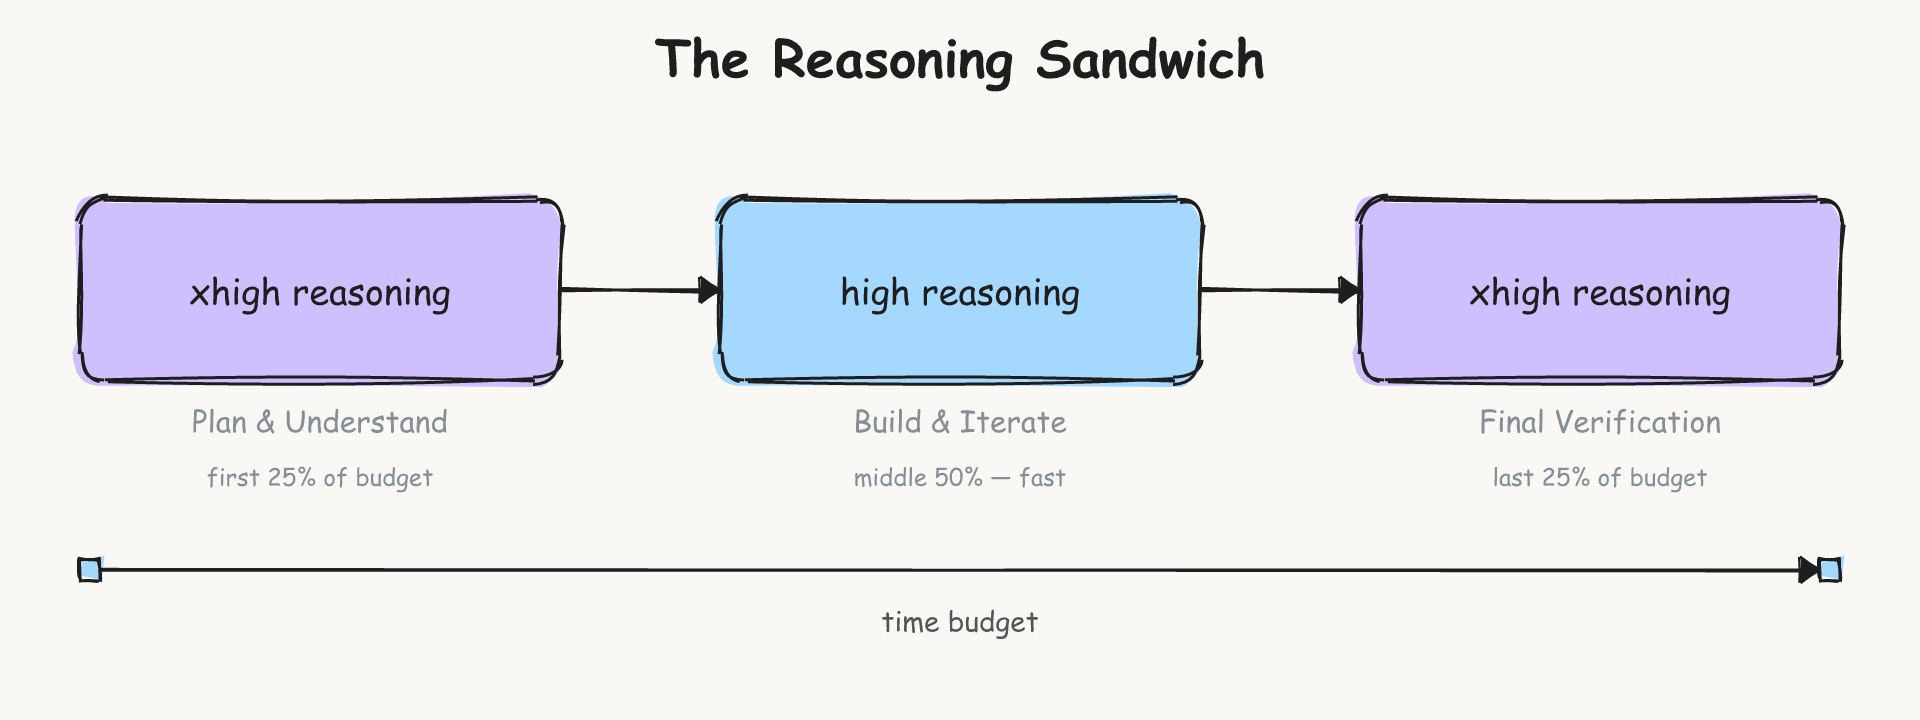
gpt-5.2-codex 具有四种推理模式:low(低)、medium(中)、high(高)和 xhigh(极高)。我们发现,增加推理算力对于规划阶段(帮助充分理解问题)和后期的验证阶段(捕捉错误并提交方案)非常有帮助。
作为一种启发式策略,我们选择了一种 xhigh-high-xhigh 的“推理三明治”基线。在规划和验证阶段投入更多算力。相比之下,如果全局只使用 xhigh,由于超时问题,得分仅为 53.9%;而这种策略最终将成绩推高至了 66.5%。
未来的自然演进方向是模型自主的自适应推理(如 Claude 和 Gemini 模型正在展示的那样)。在多模型 Harness 中,可能会演变成:使用大模型进行规划,然后移交给较小的模型去执行实现。
构建 Agent Harness 的实用经验
Agent 的设计空间非常广阔。以下是我们从实验和构建 deepagents 的过程中得出的一些通用原则:
- 替 Agent 做好上下文工程:在陌生的环境中,如今的 Agent 自己收集上下文仍然很困难。把目录结构、可用工具、编码最佳实践和问题解决策略等上下文直接提供给模型,可以减少因搜索不力或规划失误而导致的低级错误。
- 帮助 Agent 自我验证:模型往往偏向于自己想出的第一个看似合理的解决方案。强烈地通过提示词要求它们运行测试并完善方案,这对缺乏人类介入的自治编码系统尤为重要。
- 将 Traces 作为反馈信号:运行轨迹(Traces)让 Agent 能够自我评估并进行自我调试。
- 短期内主动检测并修复糟糕的模式:今天的模型并不完美(比如盲目重试和不验证工作)。Harness 设计者的职责就是围绕目前的短板进行设计,使用护栏(Guardrails)机制来保障运行。这些护栏最终可能会消失,但在当下构建稳健的 Agent 应用,它们是非常实用的工具。
- 为不同的模型量身定制 Harness:不同的模型需要不同的提示策略。我们曾用早期版本的 Harness 在 Claude Opus 4.6 上测试,得分 59.6%(稍逊于 Codex,因为我们没有针对 Claude 运行同样的改进循环)。通用的原则是一致的,但对针对特定任务进行几轮 Harness 迭代,有助于最大化 Agent 的性能。