Anthropic 长运行应用开发的脚手架(Harness)设计
快速阅读
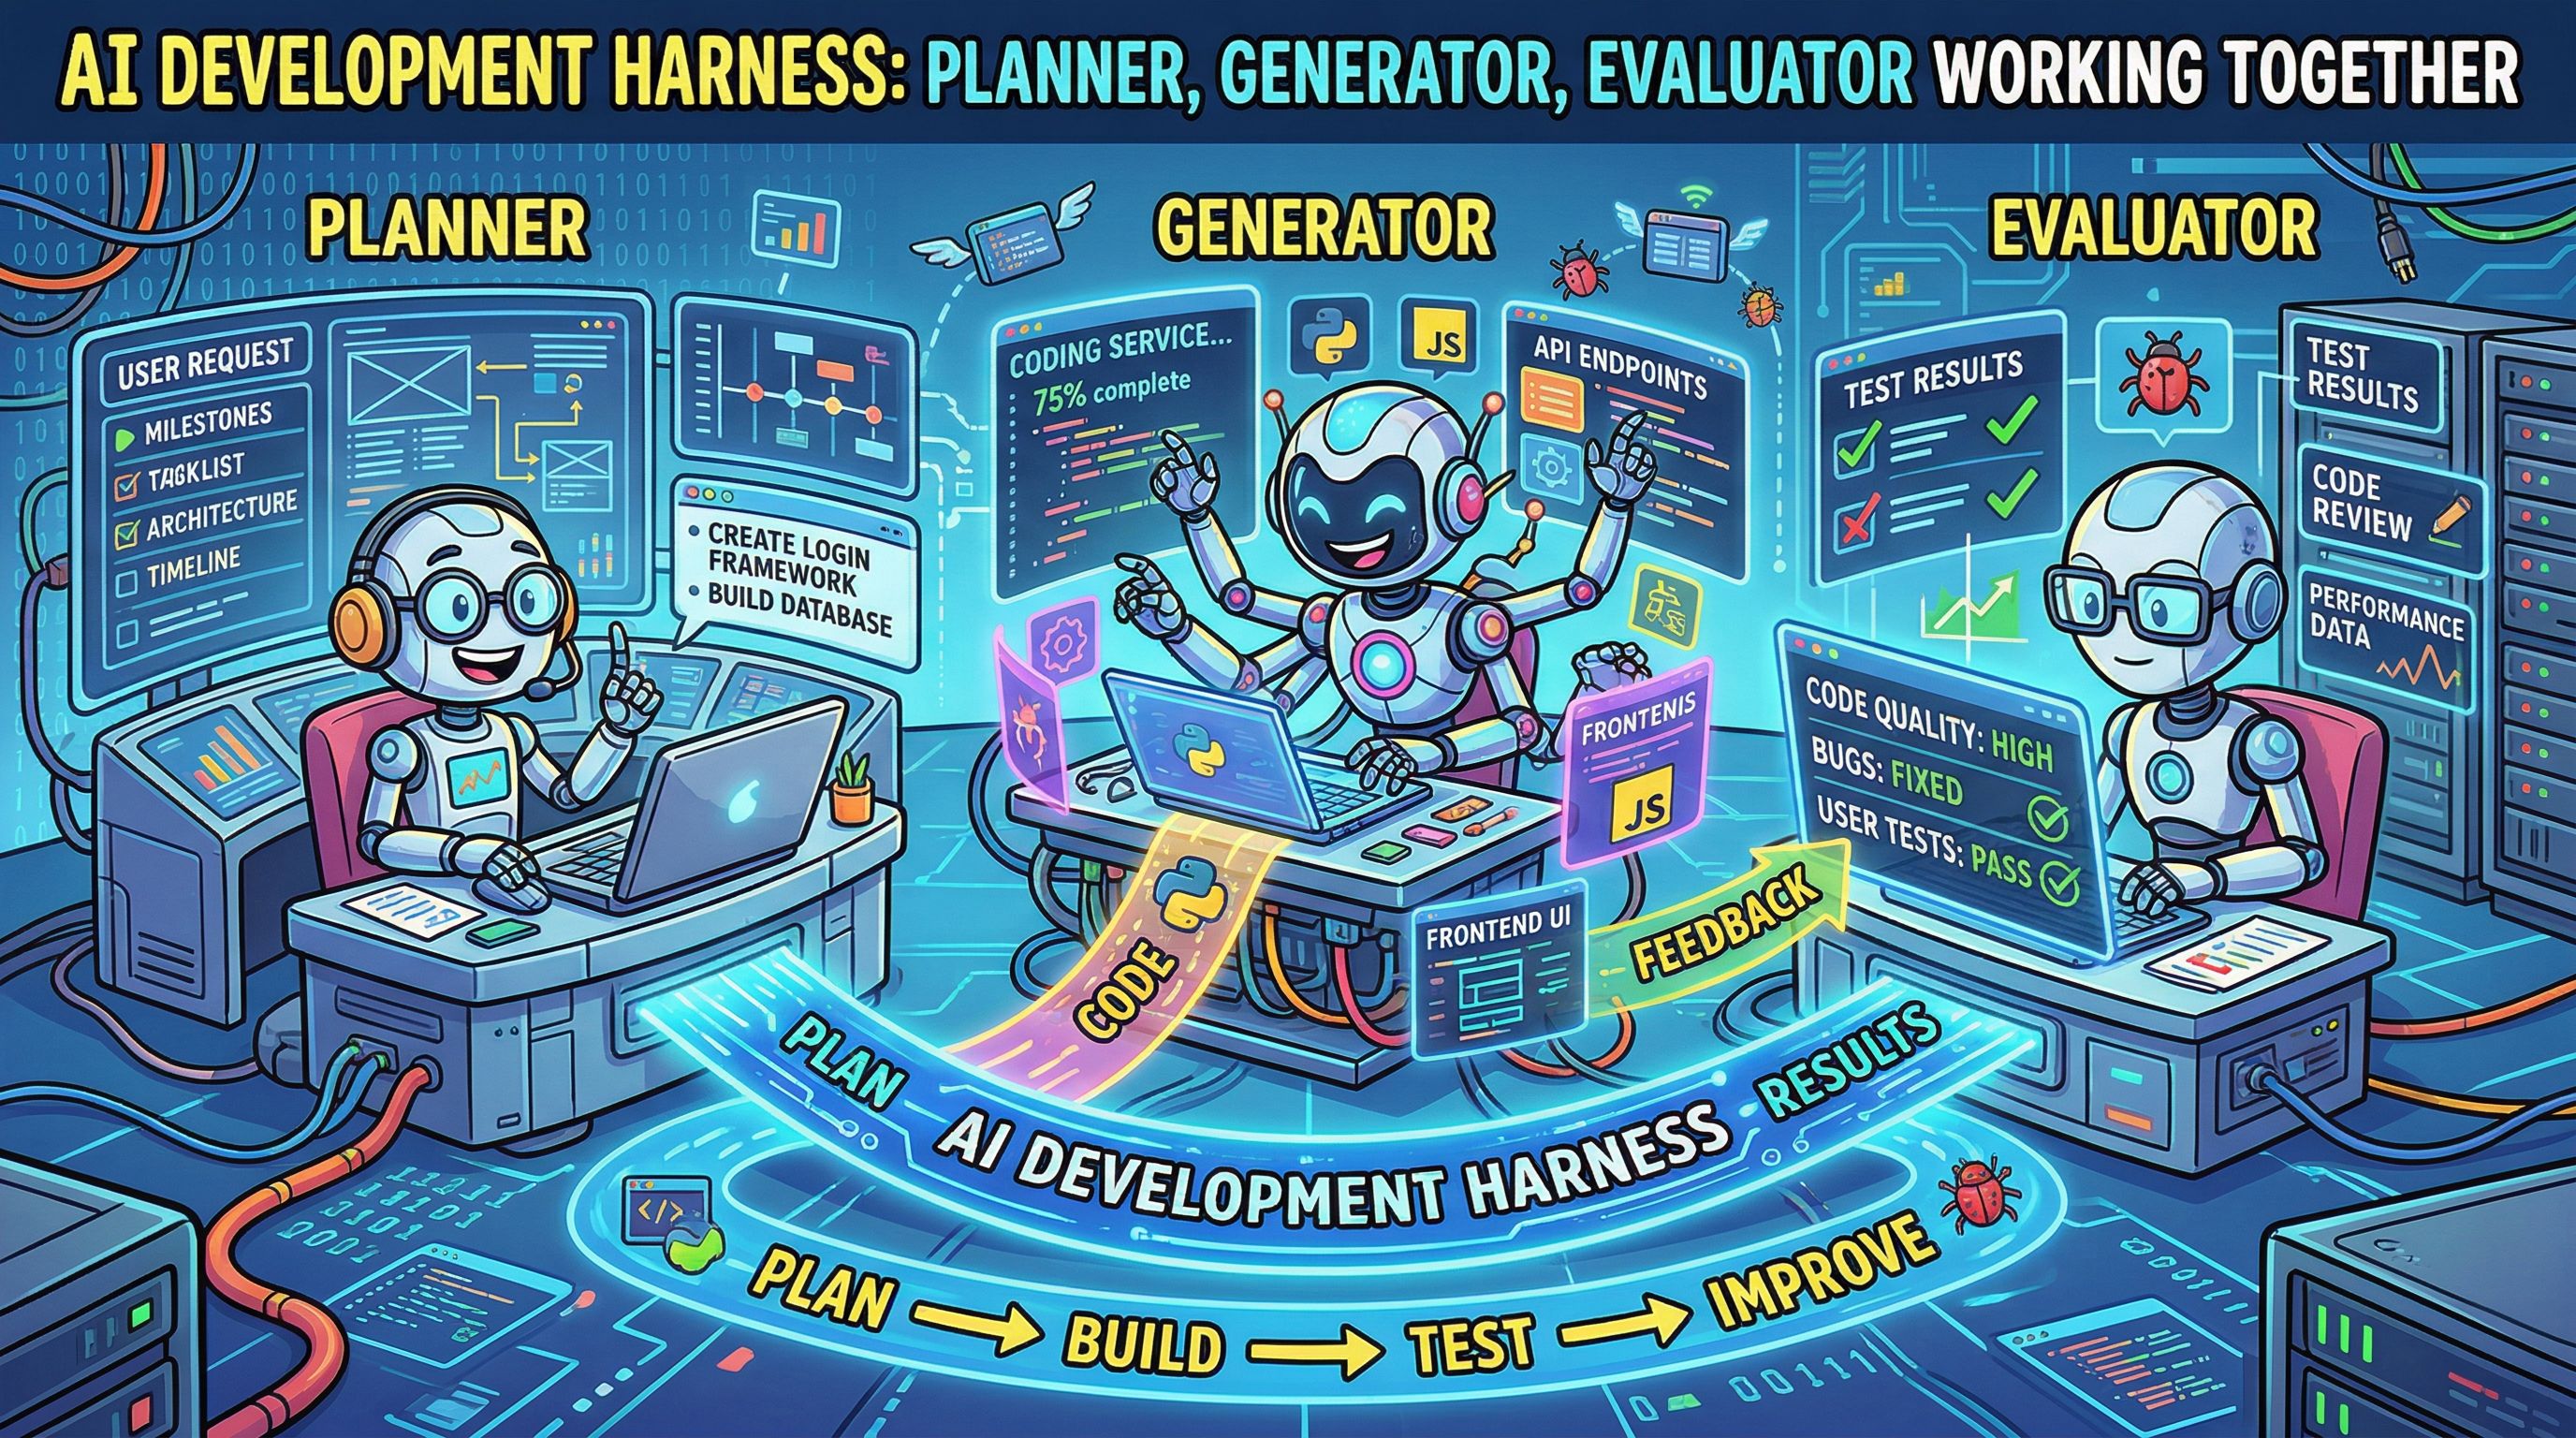
在长期运行的 AI 编码任务中,大模型经常会面临两个核心挑战:“上下文焦虑”(由于上下文窗口快满而提前结束任务)和“缺乏自我评估能力”(模型倾向于盲目称赞自己生成的平庸代码或设计)。为了突破这个瓶颈,Anthropic 团队设计了一种受生成对抗网络 (GAN) 启发的多 Agent 架构。通过分离“生成”与“评估”职责,引入包括规划器 (Planner)、生成器 (Generator) 和评估器 (Evaluator) 的三智能体系统。
该脚手架 (Harness) 被应用于前端设计与全栈开发。前端通过客观标准让“主观美感”变得可评分;而全栈开发中,评估器更是通过 Playwright 亲自点击测试应用并反馈 Bug。尽管完整运行的成本与耗时远高于单 Agent,但它成功构建出了复杂且真正可运行的应用(如复古游戏引擎和网页端音乐制作软件)。此外,随着 Claude 3.5 Sonnet 和 Opus 等基础模型能力的提升,脚手架的结构还可以不断精简,开发者应当持续寻找最能发挥模型潜力的新型组合。
为什么传统的实现方式会失败?
在构建长期运行的 Agent 任务时,开发者往往会遇到模型偏离正轨的情况。经过剖析,Anthropic 发现了这类任务执行中的两个常见失败模式:
- 上下文丢失与“上下文焦虑” (Context Anxiety): 当任务变长、上下文窗口填满时,模型不仅会丧失连贯性,还会表现出“上下文焦虑”——它们会在认为自己接近上下文极限时过早地结束工作。单纯的上下文“压缩”无法解决焦虑问题,因为模型没有得到真正的“白板”。引入上下文重置 (Context resets),配合携带先前状态和后续步骤的结构化交接,可以从根本上解决这个问题。
- 糟糕的自我评估 (Self-evaluation leniency): 让 Agent 评估自己产出的工作时,它们倾向于自信地赞美自己——即使在人类看来质量很平庸。在“设计”这种缺乏明确代码测试的客观主观领域,这一问题尤为突出。将“执行工作”的 Agent 和“评判工作”的 Agent 分离开来是解决这个问题的有效手段。相比于让生成器自我批评,调优一个独立的评估器要容易得多。
前端设计:让主观质量变得可评分
为了解决自我评估的问题,作者在前端设计中测试了这一思路。如果不加干预,Claude 通常会倾向于安全、可预测但视觉平庸的布局。
作者制定了四个评分标准,并在 Prompt 中同时提供给生成器和评估器:
- 设计质量 (Design quality):设计是否感觉像一个连贯的整体?颜色、排版、布局是否营造了独特的视觉身份。
- 原创性 (Originality):是否有定制决策的证据?拒绝模板、组件库默认样式或“AI 生成的标志性紫色渐变”。
- 工艺 (Craft):技术执行力。排版层次、间距、对比度等(Claude 默认在这方面表现不错)。
- 功能性 (Functionality):独立于美学的可用性。用户能否理解界面的功能并完成任务?
通过增加“设计质量”和“原创性”的权重,模型被推向了更具美学风险的方向。系统基于 Claude Agent SDK 构建:生成器编写 HTML/CSS/JS,评估器通过 Playwright 直接与实时页面交互,浏览、截图并打分,将批判性反馈送回给生成器进行下一轮迭代。在这个过程中,AI 甚至在第 10 次迭代时创造性地将一个荷兰艺术博物馆网页重构成了一个 3D 空间漫游体验。
扩展至全栈编码
基于前端的成功经验,作者将这种类似 GAN 的模式应用于全栈开发。代码审查和 QA 在软件生命周期中正好扮演了“评估器”的角色。
架构设计
系统包含三种 Agent 角色:
- 规划器 (Planner):取代用户手写详细需求,它接收一句简短的 Prompt 并将其扩展为完整的产品规格说明书。重点放在产品上下文和高层设计上,并主动寻找融入 AI 功能的机会。
- 生成器 (Generator):以“冲刺 (Sprint)”的形式分步工作,每次从规格书中挑选一个功能进行开发(React, Vite, FastAPI, SQLite/PostgreSQL),并在提交 QA 前进行自我评估。
- 评估器 (Evaluator):使用 Playwright 像真实用户一样点击运行中的应用,测试 UI、API 和数据库状态。任何低于硬性标准的冲刺都会失败并打回重做。
在开始编写代码前,生成器和评估器还会协商一份冲刺契约 (Sprint contract),就“完成的标准”达成一致,以确保没有过度规定底层实现。
运行脚手架的效果对比
作者使用了一个 Prompt 来生成一个 2D 复古游戏引擎(包含关卡编辑器、精灵编辑器等),在 Claude Opus 4.5 下进行了对比测试:
| 脚手架类型 | 耗时 | 成本 |
|---|---|---|
| 单个 Agent | 20 分钟 | $9 |
| 完整脚手架 | 6 小时 | $200 |
尽管成本高出 20 倍,但质量差异是决定性的。单 Agent 的应用不仅界面空间浪费,而且游戏核心的运行逻辑是完全断开的,实体无法响应输入。而完整脚手架生成的应用拥有极具一致性的视觉识别,编辑器功能丰富,甚至真正可玩(包含跳跃、碰撞等物理引擎核心逻辑)。
QA 评估器在保持开发不偏离规格方面发挥了巨大作用。例如,它能准确揪出“矩形填充工具仅在鼠标起始和结束点放置区块,而没有填满整个区域”这样具体的逻辑 Bug。
迭代脚手架
随着 Opus 4.6 这种原生具备更强规划、更长上下文和更强自纠错能力的模型发布,旧的脚手架显得过于臃肿。作者开始精简系统:
- 移除“冲刺 (Sprint)”结构:因为更强的模型能够一次性处理更长的开发流程。
- 保留规划器和评估器:没有规划器,生成器依然会“范围缩水”。评估器被移动到运行的最后进行单次测试。对于处于模型能力边缘的任务,评估器仍然不可或缺。
使用更新后的 V2 脚手架(耗时 3 小时 50 分钟,花费 $124.70),作者成功生成了一个浏览器端数字音频工作站 (DAW)。它拥有完整的编曲视图、混音器,甚至集成了一个可以帮你打鼓点、调混响的内置 AI。评估器在后期成功指出了“音频录制只是个摆设按钮”、“缺乏拖拽边缘调整音频片段长度”等最后一公里的致命缺失,促使生成器修复。
结语
随着基础模型的不断进步,它们处理复杂任务的能力会越来越强。对 AI 工程师而言,这意味着:
- 原本的脚手架中某些组件可能不再是承重墙,可以被移除。
- 基础能力的提升,反而为我们腾出了空间,去构建新的、能挑战更高难度任务的脚手架组合。
探索新型的脚手架组合空间,是 AI 工程化的下一个关键议题。
🔗 原文链接:Harness design for long-running application development