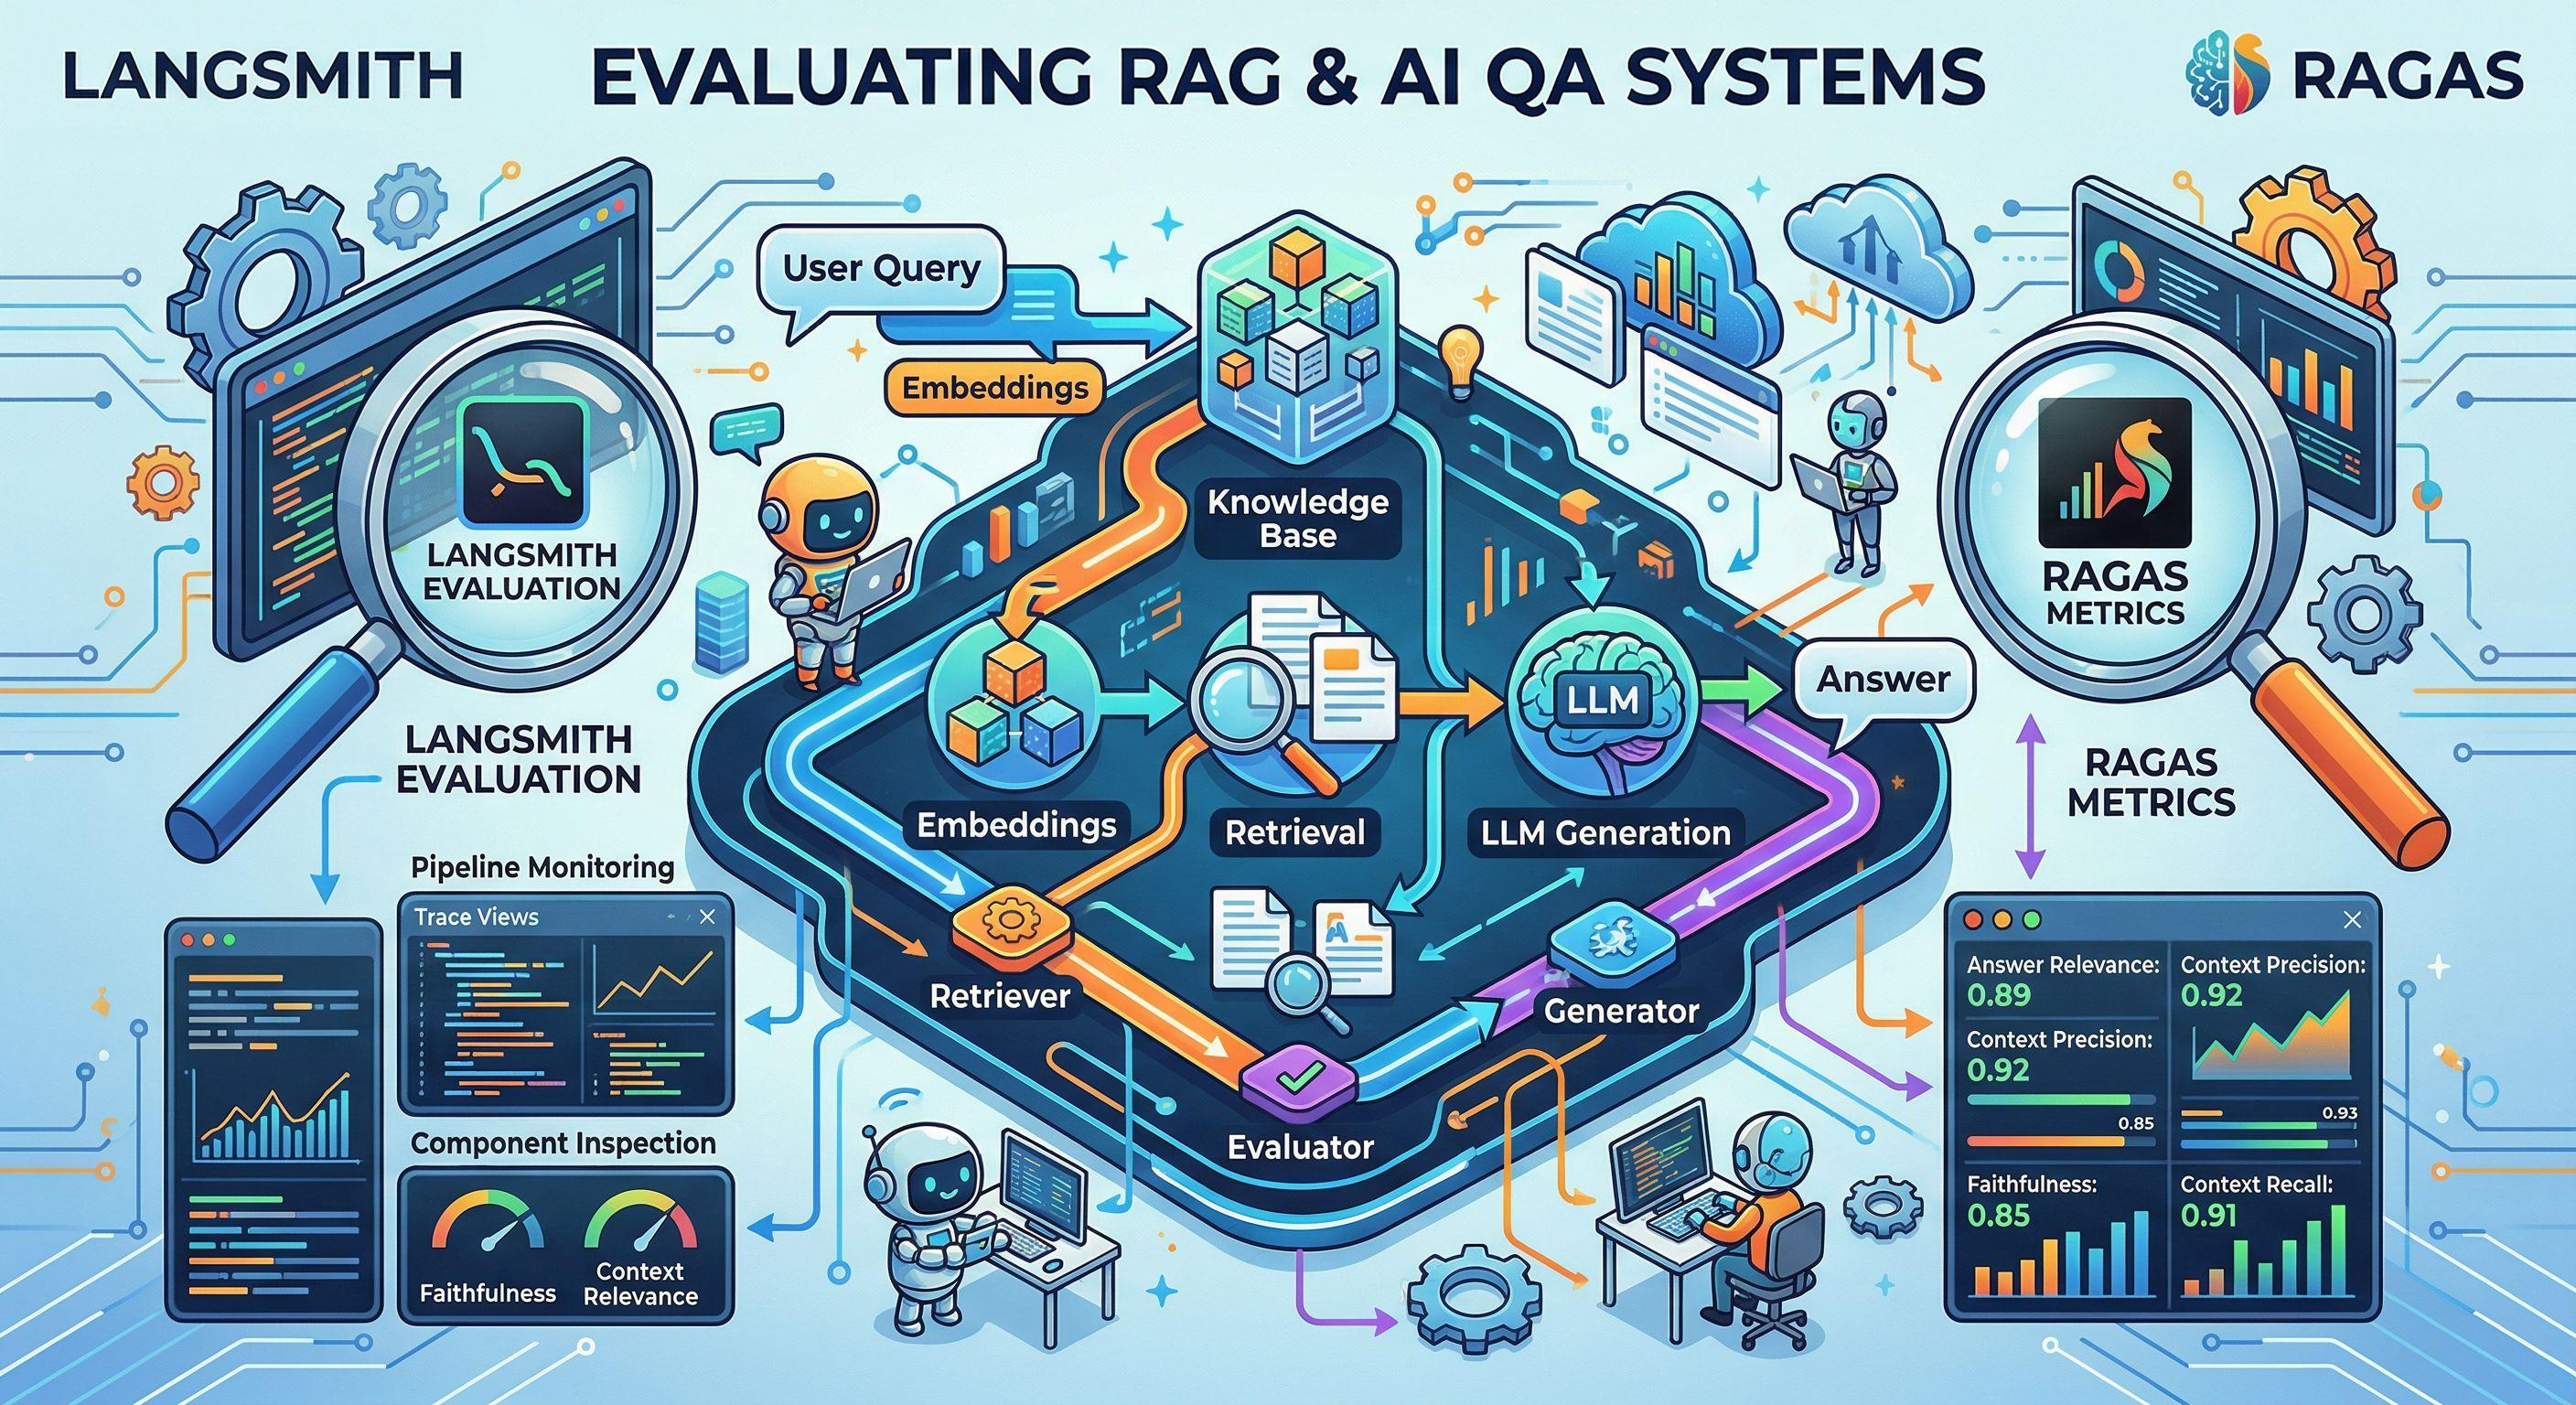
使用 Ragas 与 LangSmith 评估 RAG 流水线
快速阅读
在构建大语言模型(LLM)应用时,如何评估模型的表现是区分优秀产品与普通 Demo 的关键。针对问答(QA)或 RAG 系统,评估必须覆盖“检索器(Retriever)”和“生成器(Generator)”两部分。传统的如 ROUGE 和 BLUE 指标难以与人类判断对齐,而基于强 LLM 的评估框架越来越受欢迎。 本文介绍了开源评估框架 Ragas,它能够在无需大量标注数据的情况下,从四个维度精准评估 RAG 管道:检索阶段的“上下文相关性”与“上下文召回率”,生成阶段的“忠实度(消除幻觉)”与“答案相关性”。结合 LangSmith 平台提供的可视化、测试调试和持续监控功能,开发者可以高效构建稳健可靠的生产级 RAG 系统。
随着大语言模型(LLM)的快速发展,评估策略(evals)变得前所未有的重要。能够持续地评估和监控 LLM 管道,是决定一款应用能否从“酷炫的演示”走向“真正可靠的生产级产品”的核心差异所在。
由于模型内在的随机性,仅凭少数几个测试用例是不够的。你需要在一个与生产环境分布相匹配的测试集上进行验证。本文将重点讨论如何对问答系统(或 RAG 系统)进行深度评估。
每个 QA 流水线通常包含两个核心组件:
- 检索器(Retriever):提取回答用户查询所需的最相关的上下文信息。
- 生成器(Generator):根据提取到的上下文,生成最终的答案。
在评估 QA 系统时,我们必须单独以及综合评估这两个组件。例如,改进切块策略或 Embedding 模型可能会提升检索器;而更换底层模型或修改 Prompt 则可能改善生成器。但问题是,传统的评价指标(如 ROUGE 和 BLUE)与人类的主观判断相关性极差,而构建完美的黄金测试集又非常昂贵且耗时。
借助 LLM 进行无参考评估
目前一种非常前沿的解决方案是“让更强的 LLM 担任评委(LLM-as-a-judge)”。这种方式不仅与人类判断的相关性更好,还大大减少了人工标注成本。
当然,这种方式也有一定局限性,比如大模型往往会偏好自己的输出,或者对长回答有倾向性(即“字数多即正义”)。为了解决这些偏见,Ragas 框架应运而生。它旨在利用大模型的优势,同时绕开其局限性,从而以更低成本、更快的速度提供具有行动指导意义的指标。
认识 Ragas 框架
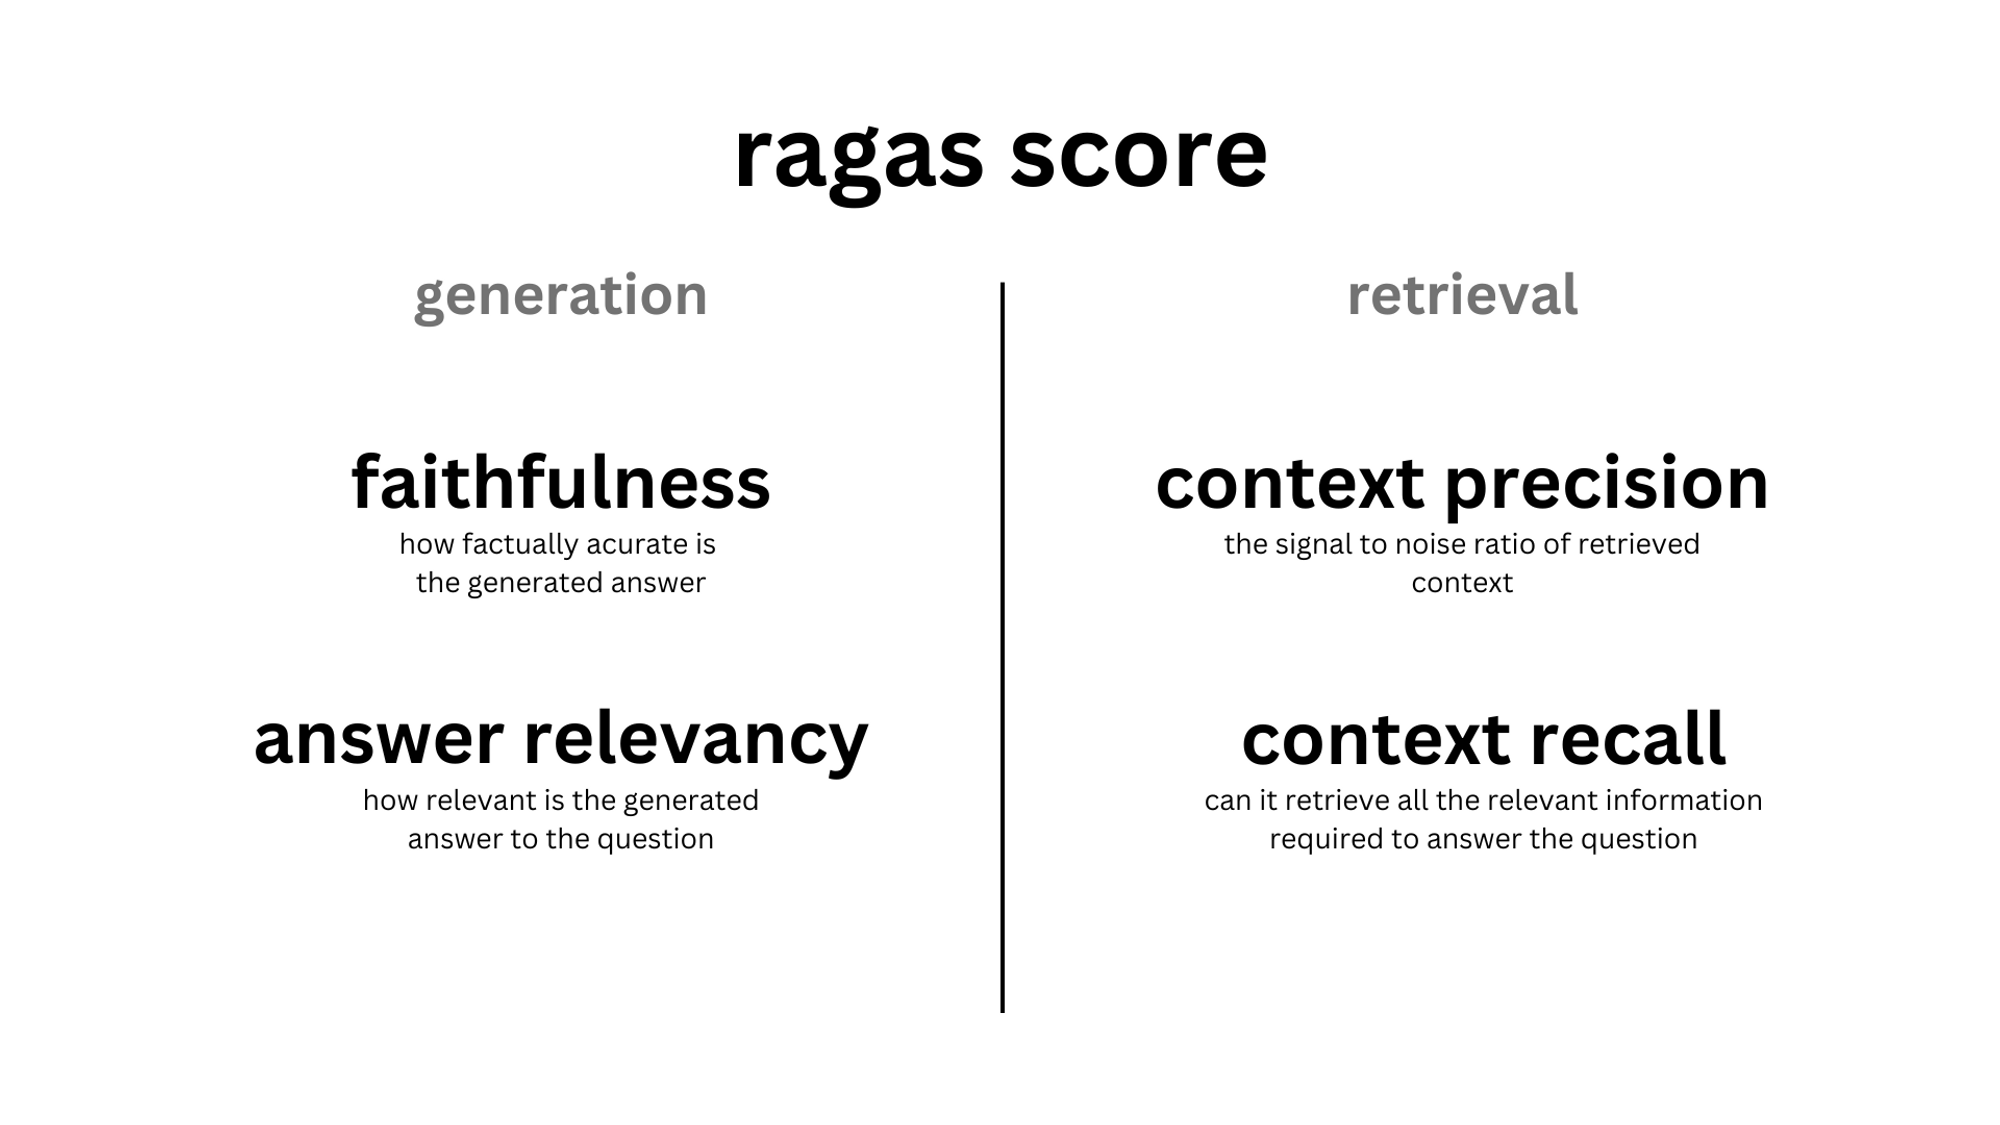
Ragas 是一个能帮你全方位评估 QA 流水线的开源框架,它提供了多个专门的评价指标:
- 评估检索(Retrieval):包含
context_relevancy(上下文相关性,信噪比)和context_recall(上下文召回率,是否召回了全部必要信息)。 - 评估生成(Generation):包含
faithfulness(忠实度,用于衡量是否出现幻觉)和answer_relevancy(答案相关性,衡量回答是否直击要害)。
这四项指标的调和平均值就是最终的 Ragas 分数(Ragas score),它代表了你的 QA 系统整体的性能表现。
令人惊喜的是,绝大多数 Ragas 测量指标不需要人工预先标注的数据。你只要准备几个问题即可跑通测试(如果是 context_recall 则额外需要一个参考答案)。
动手评估一个 QA 链
在具体操作层面,你可以使用 LangChain 对纽约市的维基百科页面构建一个标准的 QA 查询链,然后利用 Ragas 里的各种指标(faithfulness, answer_relevancy 等)转化为 LangChain 能够理解的 RagasEvaluatorChain:
from ragas.metrics import faithfulness, answer_relevancy, context_relevancy, context_recall
from ragas.langchain import RagasEvaluatorChain

# 生成评估链
eval_chains = {
    m.name: RagasEvaluatorChain(metric=m)
    for m in [faithfulness, answer_relevancy, context_relevancy, context_recall]
}
Ragas 在后台虽然也是调用 LLM 进行打分,但它巧妙地进行了拆解和交叉验证。例如:
- 忠实度(Faithfulness):它会先让 LLM 把生成的答案拆解成一句句声明,然后再用 LLM 检查这些声明是否在检索到的上下文中能找到支撑依据。
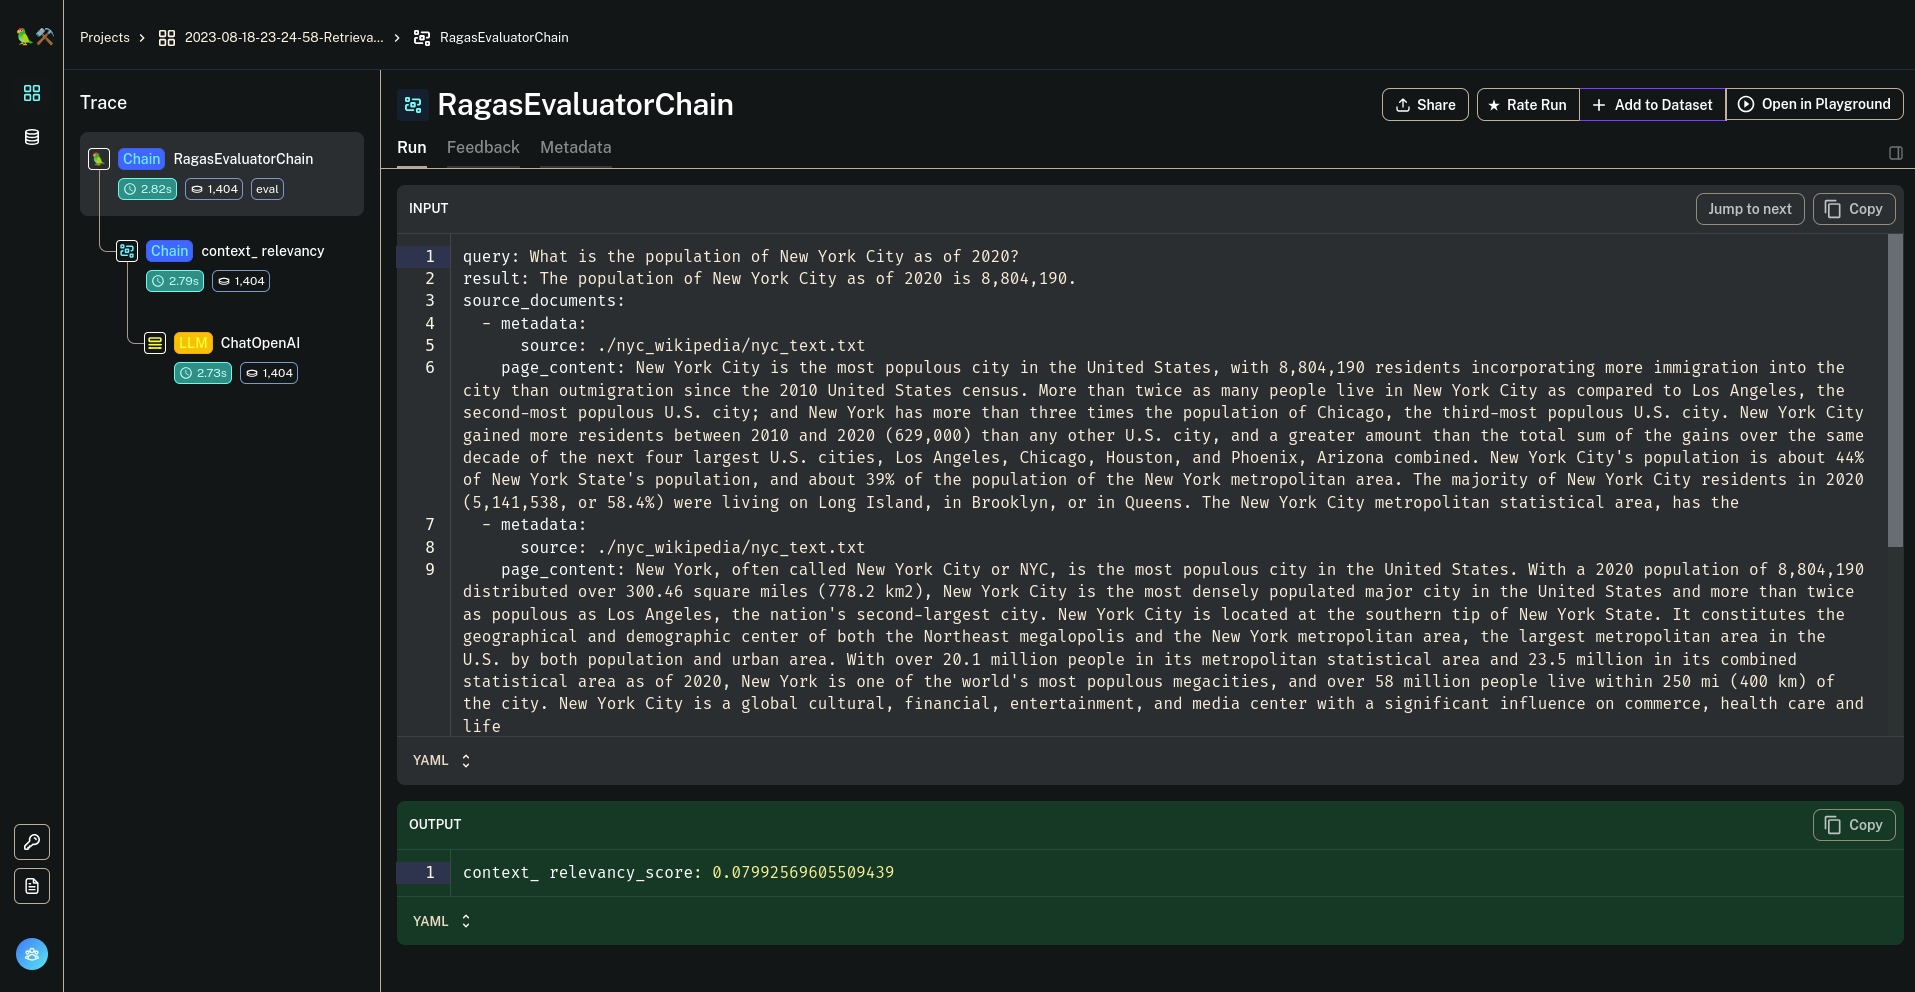
- 上下文相关性(Context Relevancy):它让 LLM 在检索出的上下文中挑出实际用于回答问题的句子,通过计算这个比例来判断检索出的“噪音”有多少。
通过了解这些底层机制,你的评估分数就变得具有可解释性了。
使用 LangSmith 可视化评估结果
Ragas 提供了深度指标,但在生产环境中进行持续追踪和测试管理,需要更专业的平台支持——这就轮到 LangSmith 登场了。
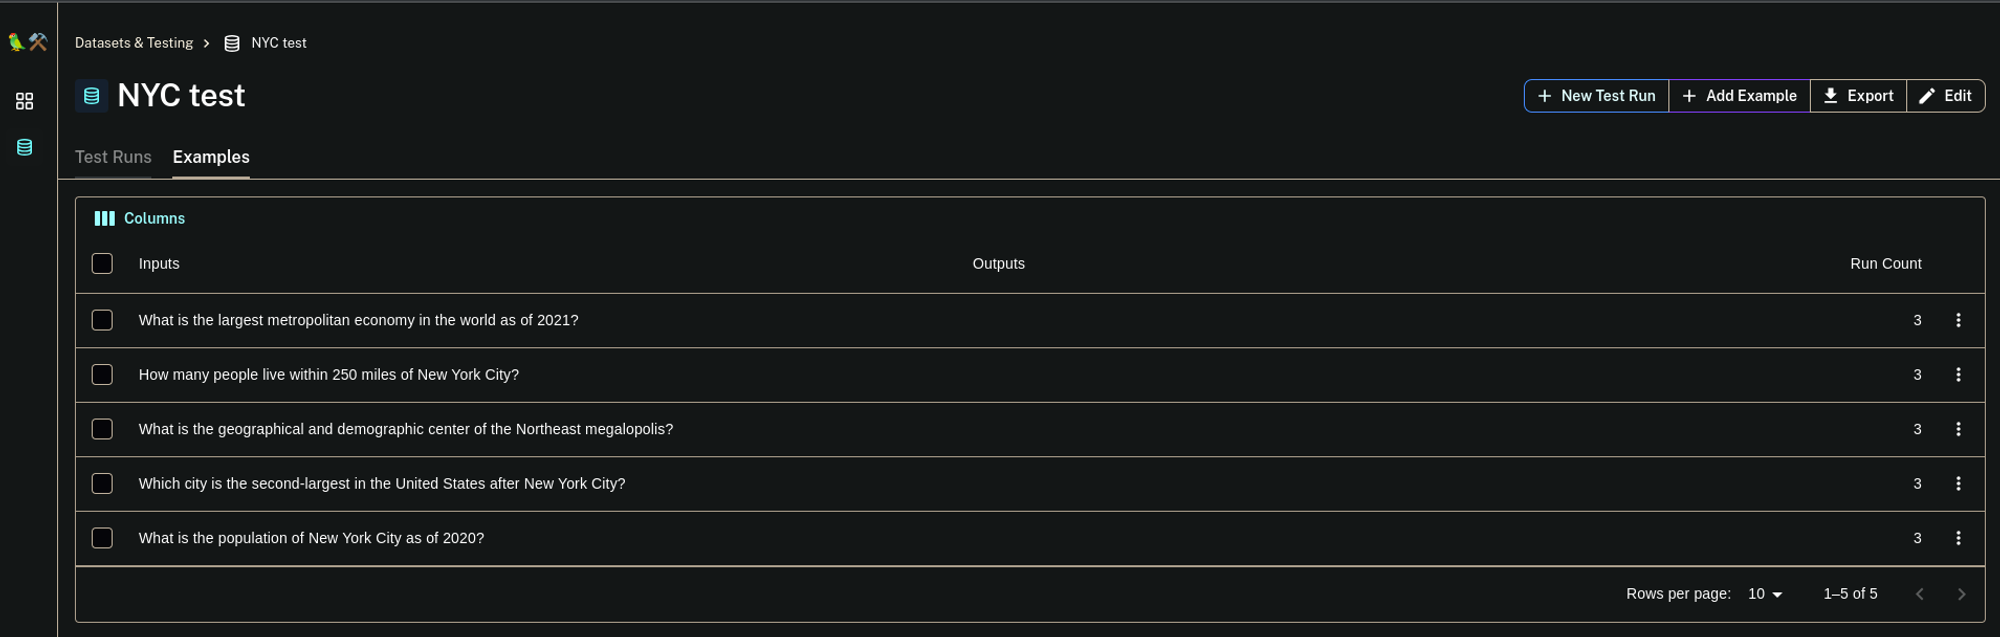
LangSmith 是一个平台,专门用于调试、测试、评估和监控各种 LLM 链和智能体。 第一步是在 LangSmith 中创建一个你的测试集。比如,我们可以创建一个只有5个问题的“NYC test”测试集:
接着调用 LangSmith SDK 的 run_on_dataset() 并配置我们之前构建的 RagasEvaluatorChain 评估指标:
from langchain.smith import RunEvalConfig, run_on_dataset

evaluation_config = RunEvalConfig(
    custom_evaluators=[eval_chains.values()],
    prediction_key="result",
)

result = run_on_dataset(
    client,
    dataset_name,
    create_qa_chain,
    evaluation=evaluation_config,
)
执行后,你将在 LangSmith 看板里看到详细的评估反馈列表(Feedback 列)。
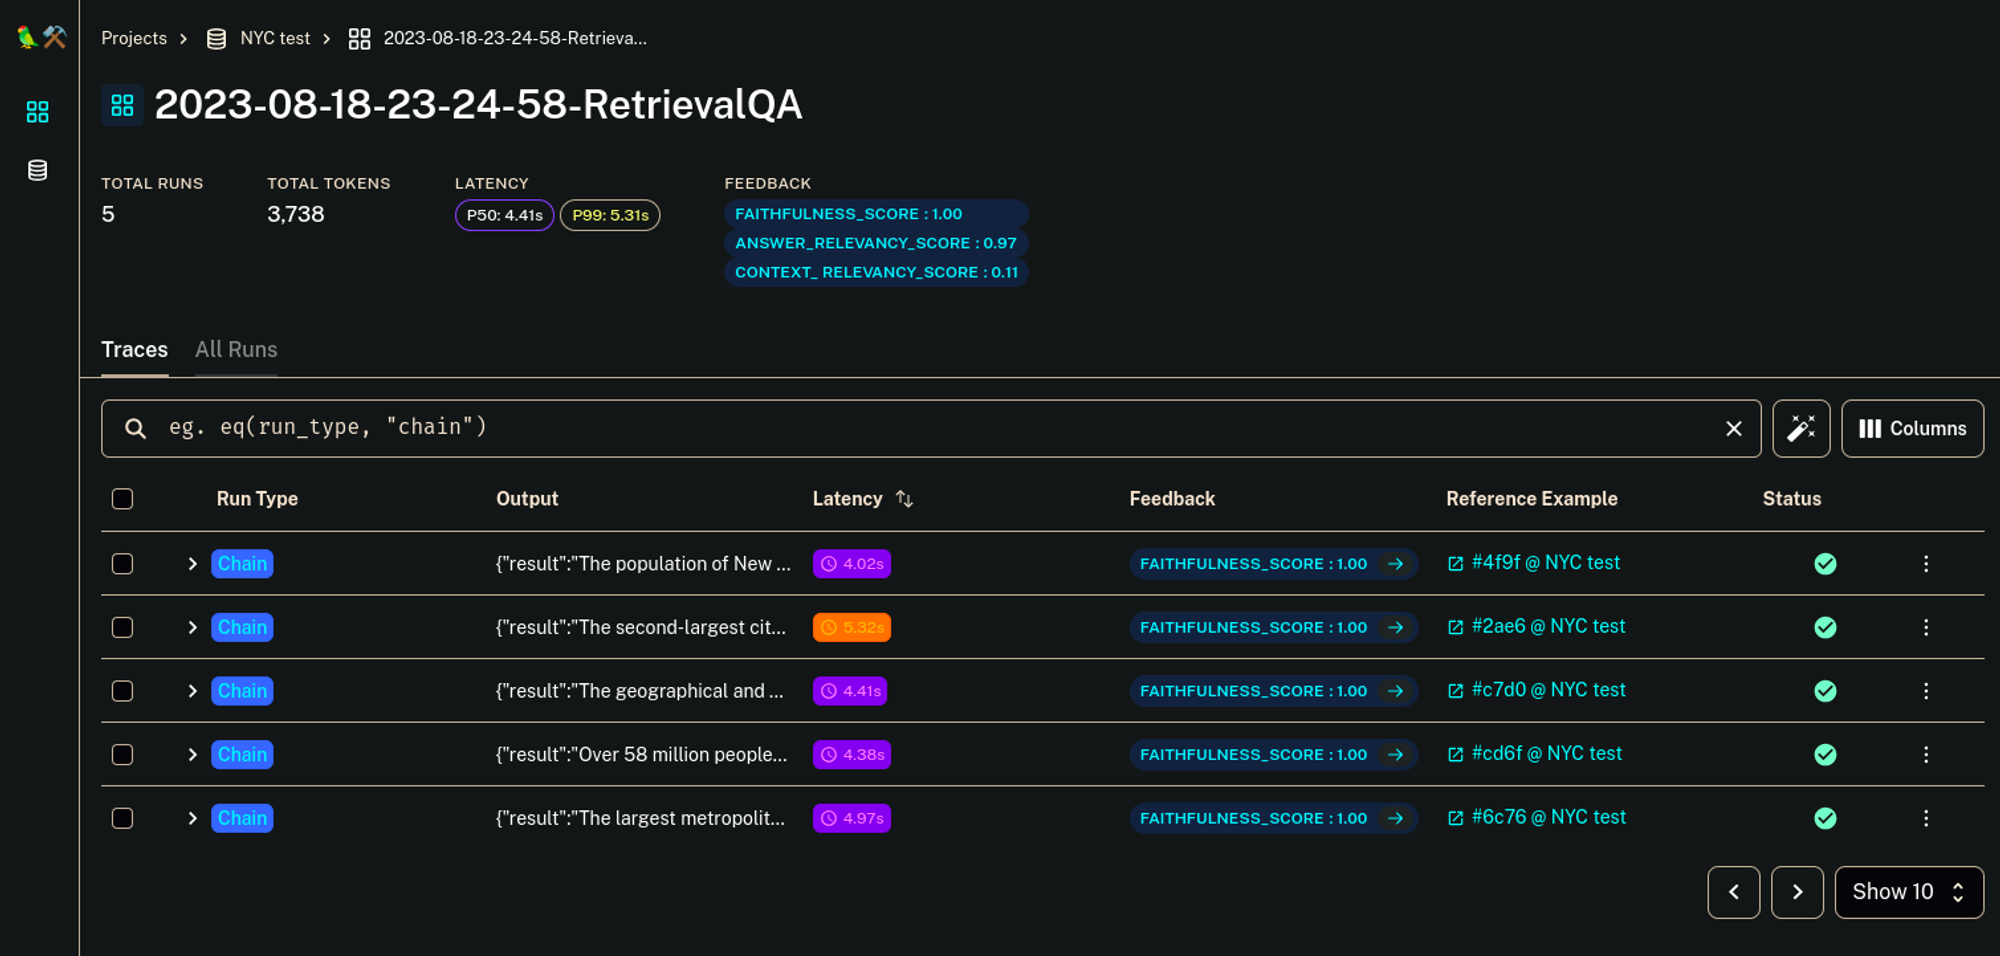
想要深究为什么得到了某个低分?直接点击某条记录并展开 Feedback 标签页。
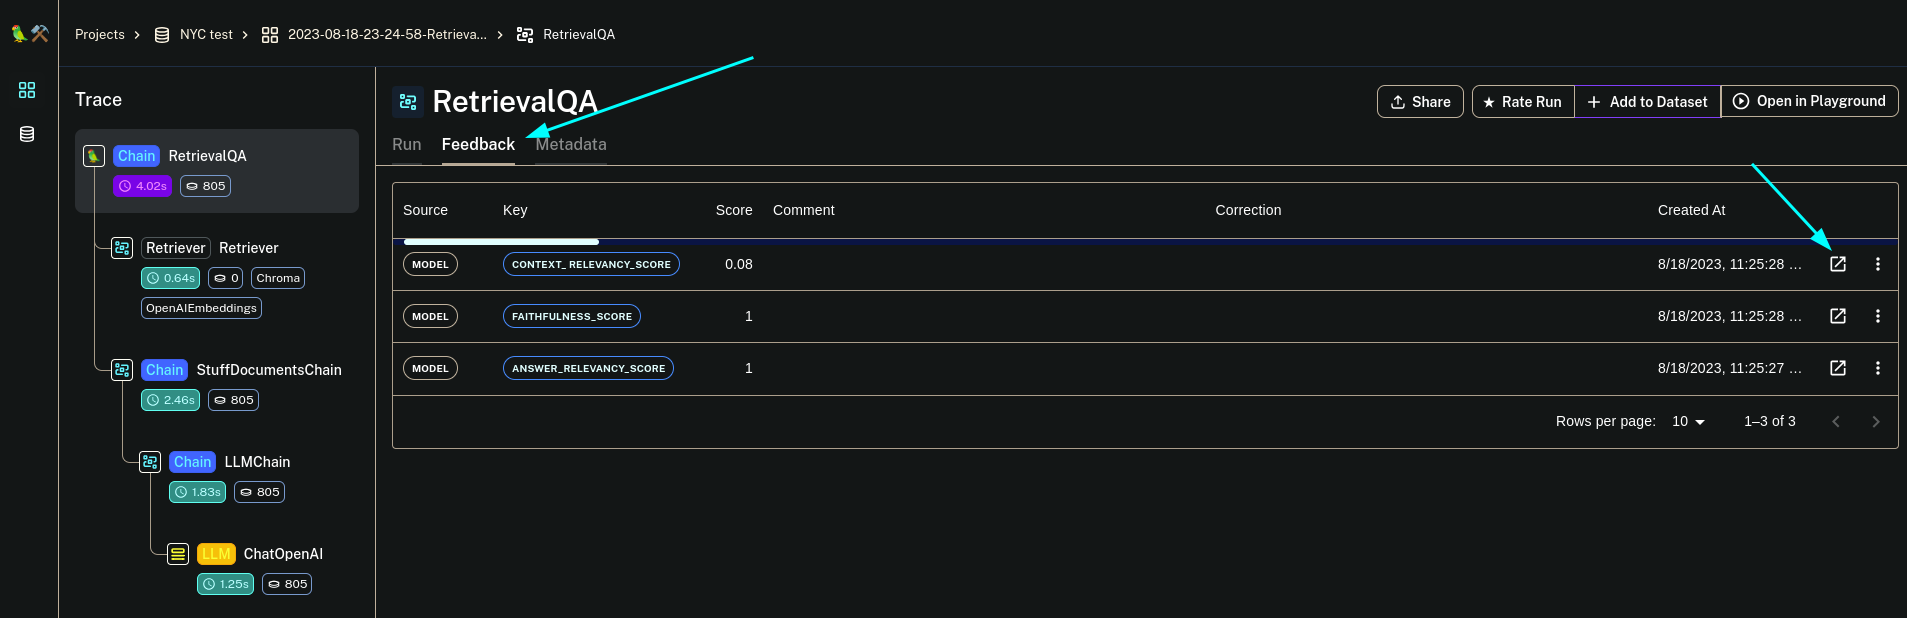
这里不仅会显示各项具体得分,点击弹窗图标还能直接看到 RagasEvaluatorChain 的完整评估链路和推理过程,帮助你迅速定位是因为检索出错,还是模型出现了幻觉!
如果你的 QA 系统本身就接入了 LangSmith 进行日志追踪,你还可以很轻松地基于用户的反馈或生产环境记录,把值得关注的真实问题直接归档入测试集。这种闭环流程将使你的测试数据集随着时间的推移不断优化,变得越来越完备。
总结
在传统的问答系统测试中,死板的字符比对不仅耗时,还往往失真。利用基于 LLM 加持的 Ragas 框架,我们大幅提升了测量准确性并克服了模型偏见;而结合 LangSmith 平台进行管理与可视化,使得这些数字变成了真正具有行动指导价值的洞察。
拥抱这两个工具,将使你的 RAG 开发流程更加透明、高效,让你的大模型应用真正经得起真实世界的考验。