针对长时间运行 AI 智能体的有效管理策略
快速阅读
随着 AI 智能体能力的提升,它们开始处理需要数小时甚至数天的复杂任务。然而,受限于上下文窗口大小,智能体必须在离散的会话中工作,且每个新会话都没有之前的记忆。为了解决这个问题,Anthropic 为 Claude Agent SDK 开发了双层架构:
- 初始化智能体 (Initializer agent):在首次运行时搭建基础环境,包括初始化脚本、进度日志和 Git 记录,并详细列出所有功能的 JSON 测试清单。
- 编码智能体 (Coding agent):在后续会话中接手工作,每次只专注实现一个功能。它会先通过读取日志和自动化测试了解现状,完成开发后提交 Git 并在日志中留下清晰的开发工件。 这种方法有效防止了智能体试图“一口气完成所有事”、产生未记录的 Bug 或过早宣布任务完成的问题。
长时间运行智能体面临的挑战
Claude Agent SDK 是一个强大的通用智能体框架,擅长编码及其他需要模型使用工具收集上下文、规划和执行的任务。它具备上下文管理功能(如压缩),理论上可以让智能体无限期地进行有用的工作。
但仅有压缩功能是不够的。如果只是给出一个高层次的提示词(比如“克隆一个 claude.ai”),即使是最前沿的编码模型,在跨越多个上下文窗口的循环中也会失败。主要有两种失败模式:
- 眼高手低:智能体试图一口气完成应用,导致在实现一半时耗尽上下文,留下未完成且无文档记录的代码。下一个会话的智能体只能靠猜,浪费大量时间修复基础应用。
- 浅尝辄止:在完成部分功能后,后续的智能体看到已有的进展,就会过早地宣布任务已经全部完成。
为了解决这个问题,Anthropic 提出了由“初始化智能体”和“编码智能体”组成的双层解决方案。
环境管理的核心要素
为了让后续的智能体能够高效工作,初始环境必须包含所需的所有上下文。
详细的功能清单
为了防止智能体试图一口气完成所有功能或过早宣布完成,初始化智能体会根据用户的初始提示,编写一个全面的功能需求文件(通常是 JSON 格式,因为模型不容易误改 JSON)。在 claude.ai 克隆示例中,这意味着超过 200 个详细功能。所有功能初始都被标记为“失败(failing)”,以便后续的编码智能体有明确的工作大纲。
增量式进展
有了初步的环境脚手架后,接下来的编码智能体被要求每次只开发一个功能。这种增量方法对于解决智能体“贪多嚼不烂”的倾向至关重要。 同时,模型在做出代码更改后必须让环境保持干净状态:提交详细的 Git commit,并在进度文件中写下摘要。这样智能体就能使用 Git 恢复错误代码。
自动化端到端测试
Claude 经常在没有进行适当测试的情况下就将功能标记为完成。当明确提示其使用浏览器自动化工具(如 Puppeteer MCP 服务器)并像人类用户一样进行端到端测试时,表现会有极大提升。
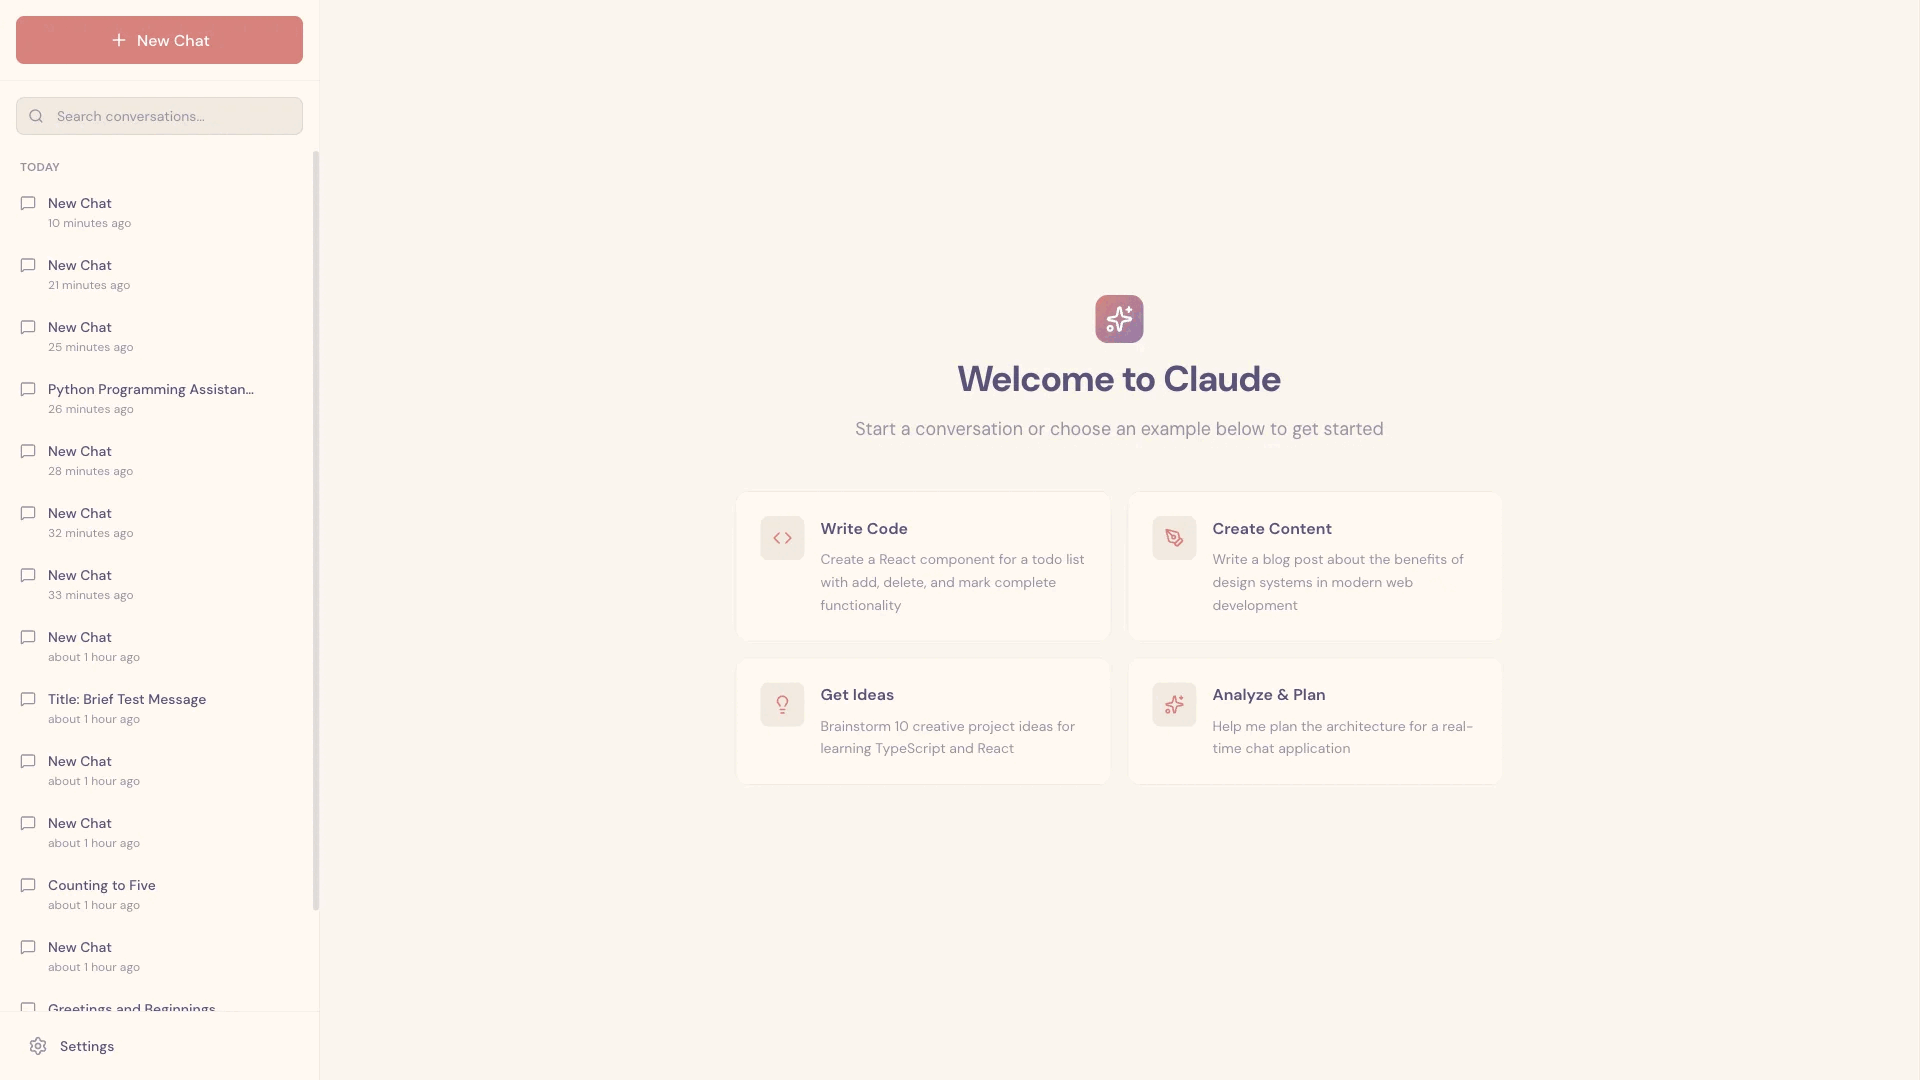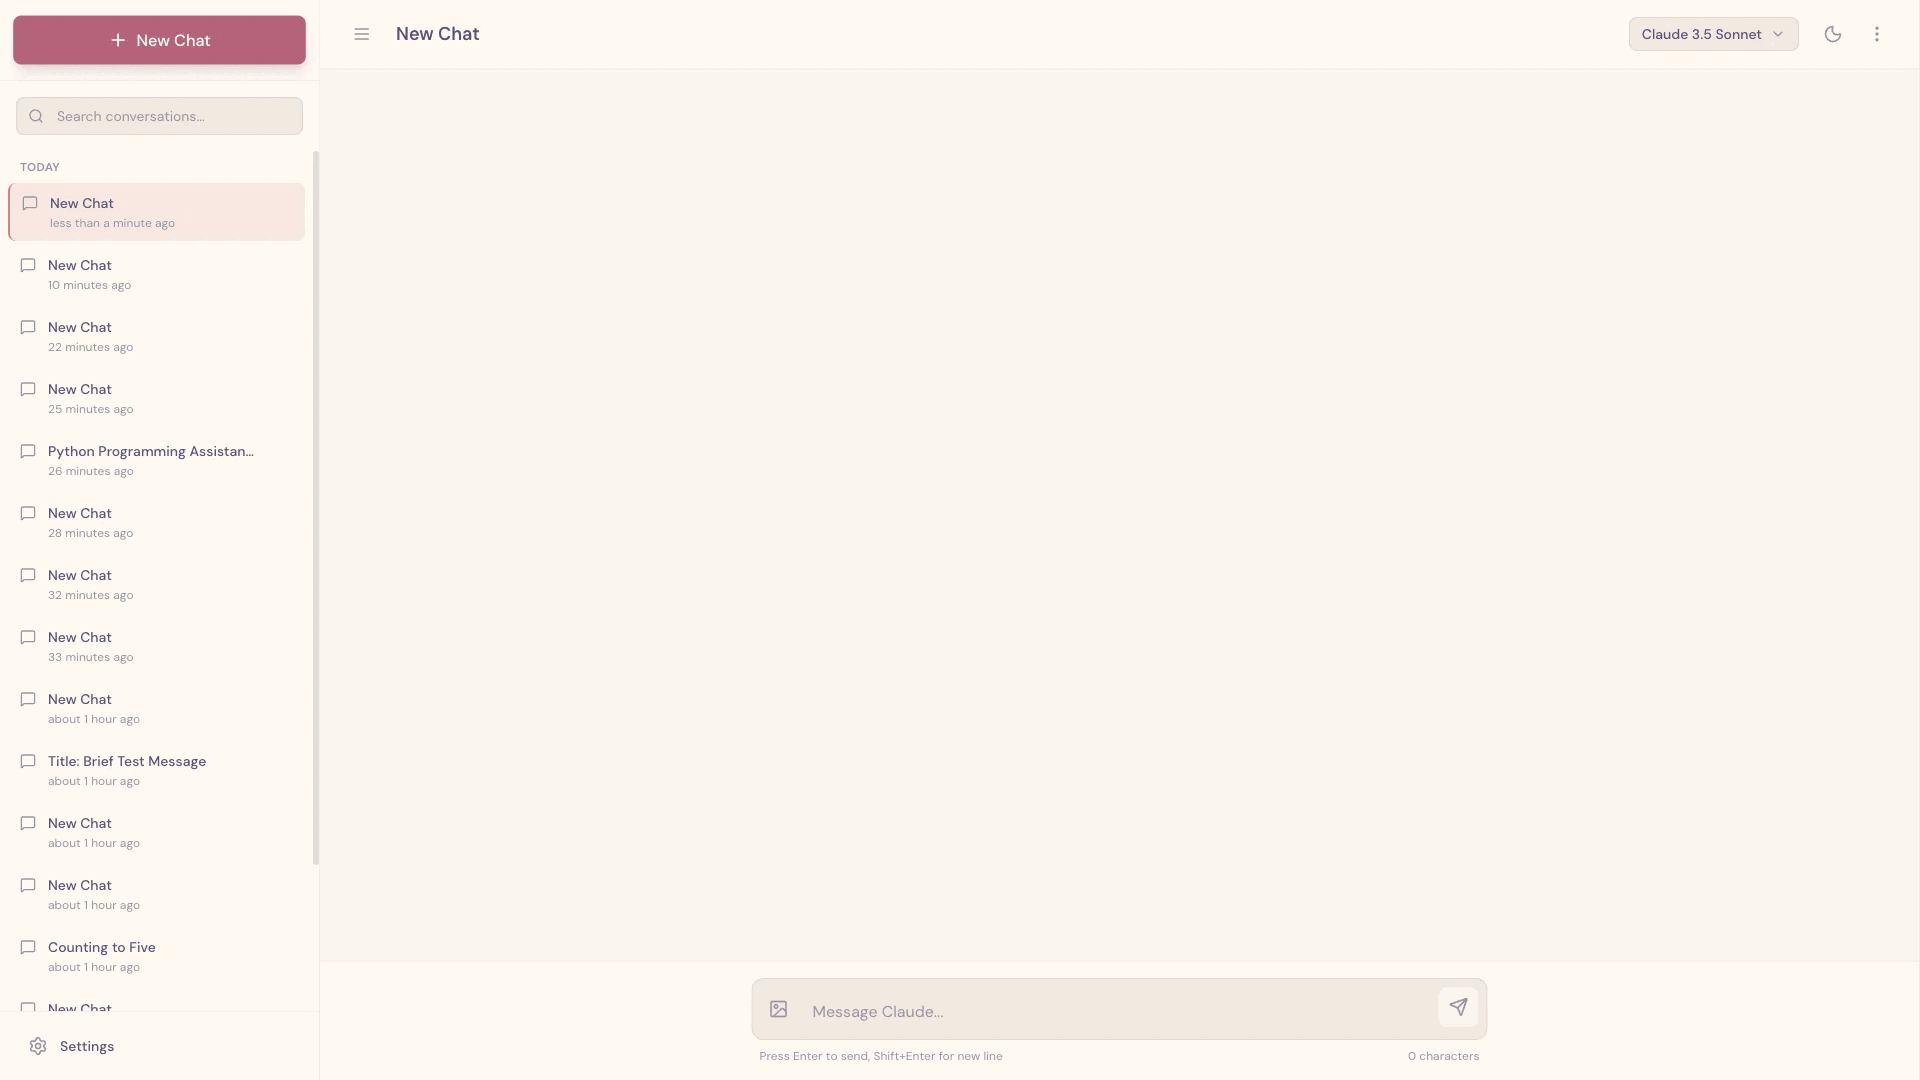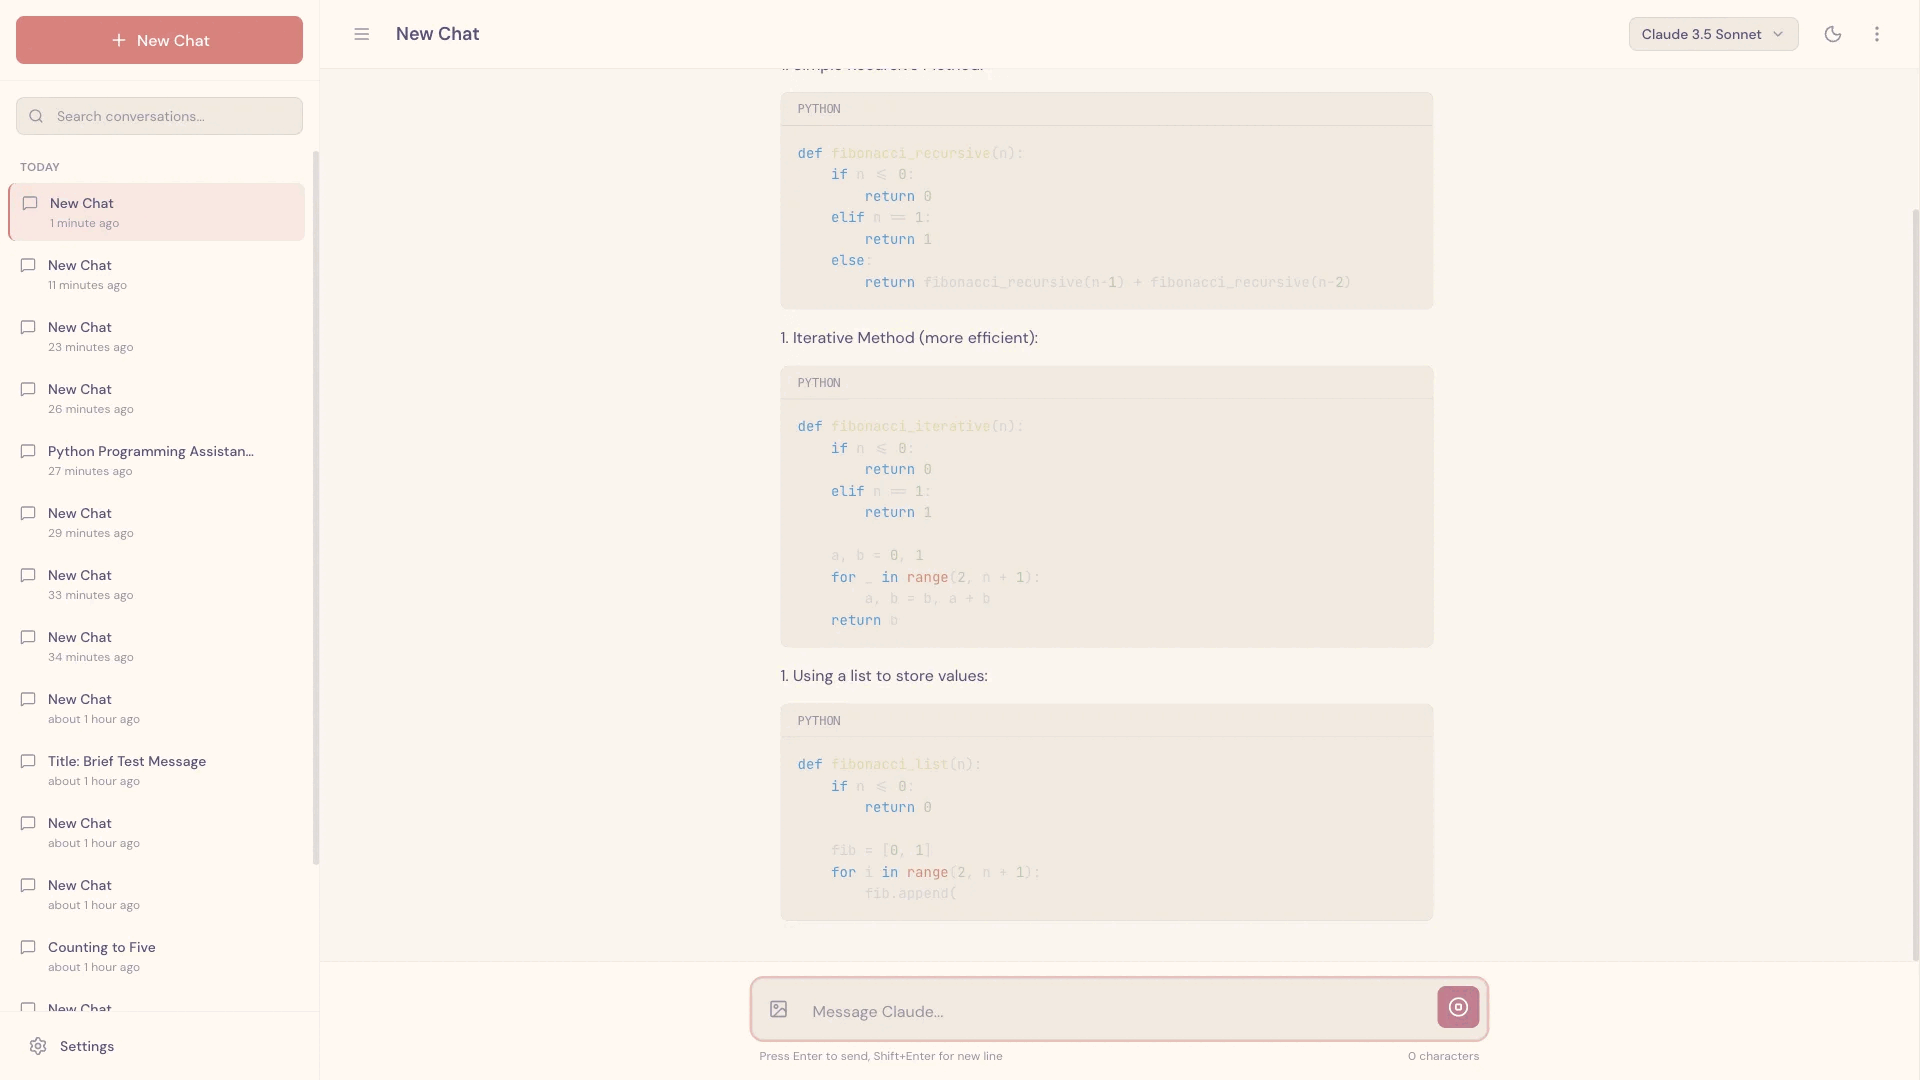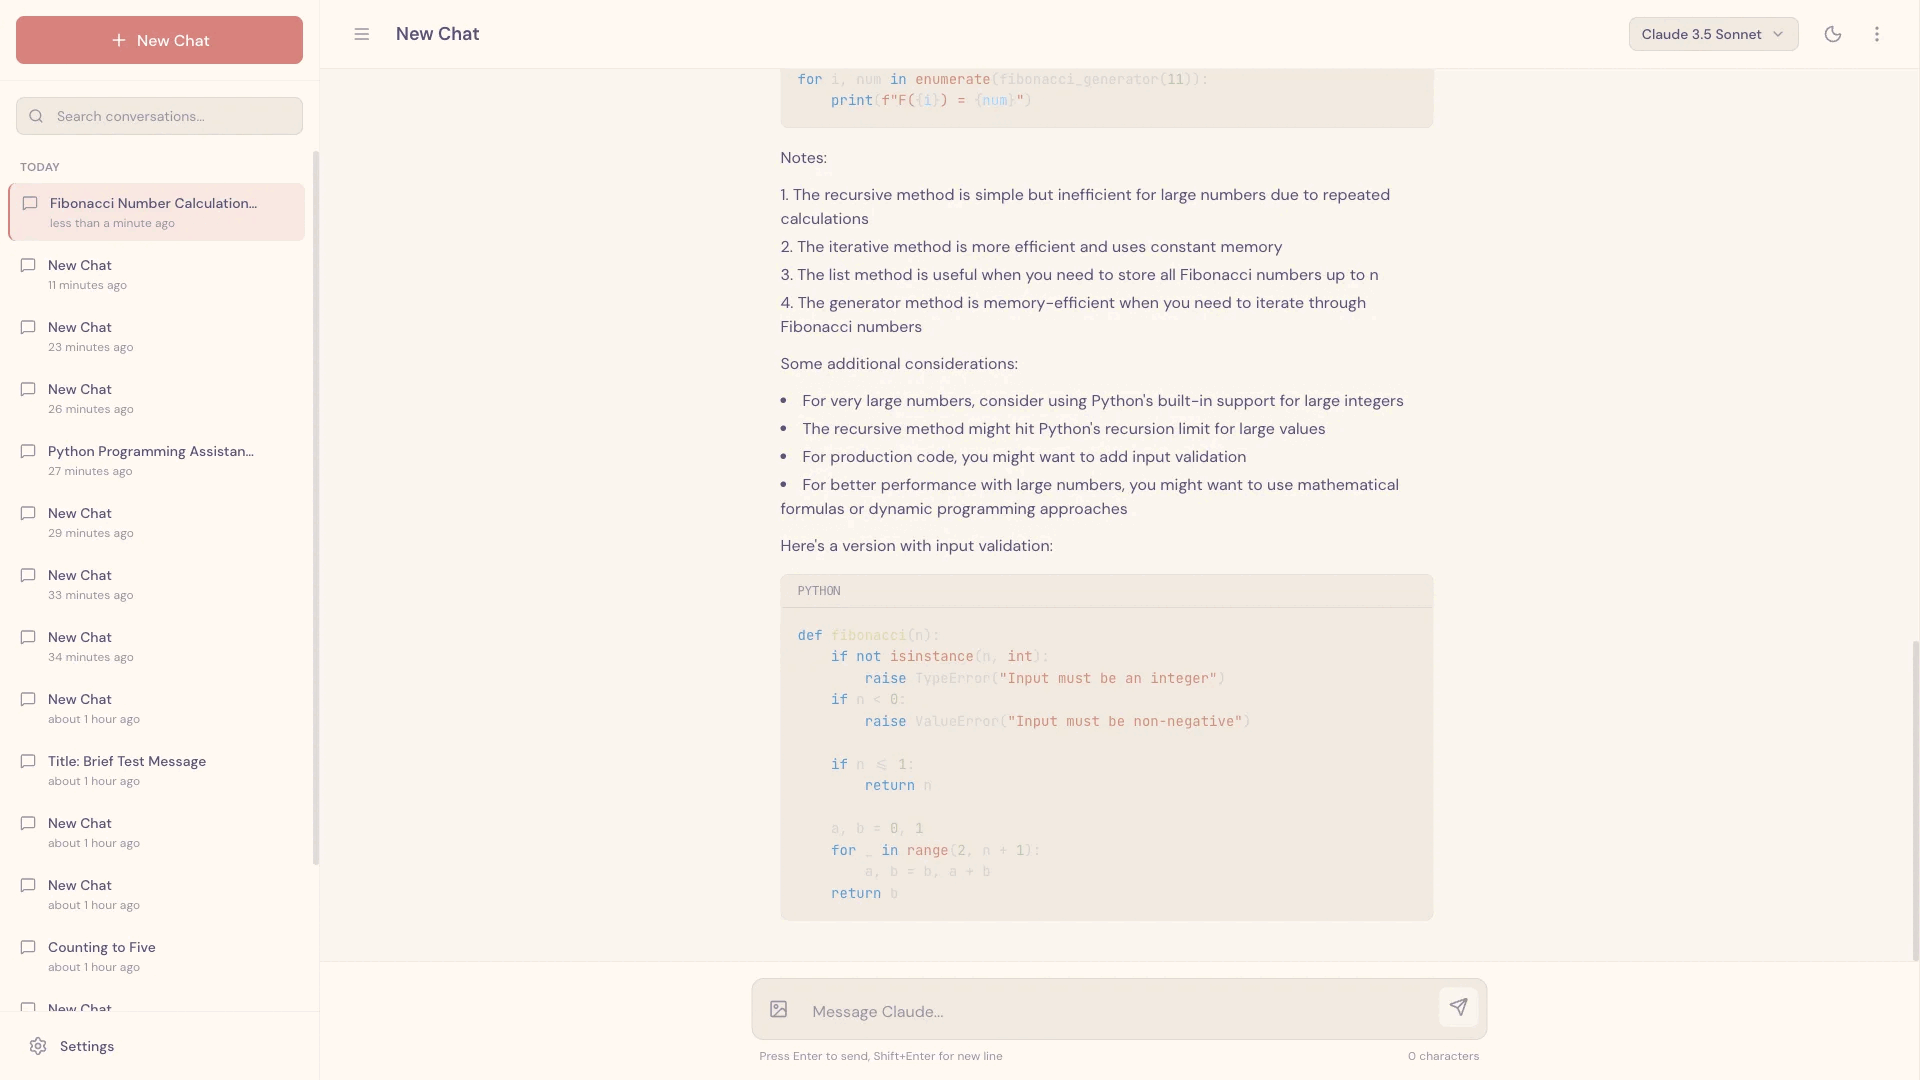
提供这类测试工具可以让智能体发现仅从代码中无法看出的 Bug。
快速进入工作状态
在上述准备工作就绪后,每个编码智能体在开始会话时都会执行一系列步骤来确定方向:
- 运行
pwd查看当前目录。 - 阅读 Git 日志和进度文件,了解最近的开发动态。
- 阅读功能清单文件,选择优先级最高且未完成的功能开始工作。
- 运行
init.sh启动开发服务器,并进行基础的端到端测试,确保应用没有处于损坏状态。
这些步骤不仅节省了 Token,还避免了智能体在代码基础已经损坏的情况下盲目添加新功能,从而导致问题恶化。
未来展望
虽然这一方案使模型能够在多个上下文窗口中取得渐进式进展,但仍有一些悬而未决的问题。例如,是由单个通用编码智能体表现更好,还是多智能体架构(如专门的测试智能体、QA 智能体或代码清理智能体协作)更为优越。此外,这些经验未来也有望推广到科学研究或财务建模等其他领域的长时间运行智能体任务中。