针对AI智能体的有效上下文工程
快速阅读
随着AI的演进,上下文工程 (Context Engineering) 正逐渐取代单纯的提示词工程,成为构建高效智能体的核心。因为大语言模型 (LLM) 和人类一样,有着有限的“注意力预算”——当上下文过长时,模型准确提取信息的能力会下降(即“上下文腐败”)。
因此,工程的核心转变为:如何在有限的窗口内,精心策划和维护最具价值的信息(Token)。本文深入剖析了如何精简系统提示词并避免硬编码,优化工具的设计以提升效率;同时探讨了在长周期任务中,如何利用“上下文压缩”、“结构化笔记(记忆)”以及“多智能体架构”等即时检索(Just-in-time)策略,帮助智能体突破上下文窗口限制,实现持续、可靠的自主决策。
什么是上下文工程?
过去几年里,“提示词工程”一直是应用AI领域的焦点。但如今,一个新术语开始崭露头角:上下文工程。构建基于语言模型的应用,不再仅仅是寻找合适的字词来拼凑提示,而是要回答一个更宏观的问题:“什么样的上下文配置最有可能产生我们期望的模型行为?”
在 Anthropic 看来,上下文工程是提示词工程的自然演进:
- 提示词工程:侧重于如何编写和组织LLM指令以获得最佳输出(主要指系统提示)。
- 上下文工程:指在LLM推理过程中,策划和维护最优信息集(Token)的一系列策略。这包含了系统指令、工具、MCP(模型上下文协议)、外部数据、消息历史等所有状态的全局管理。
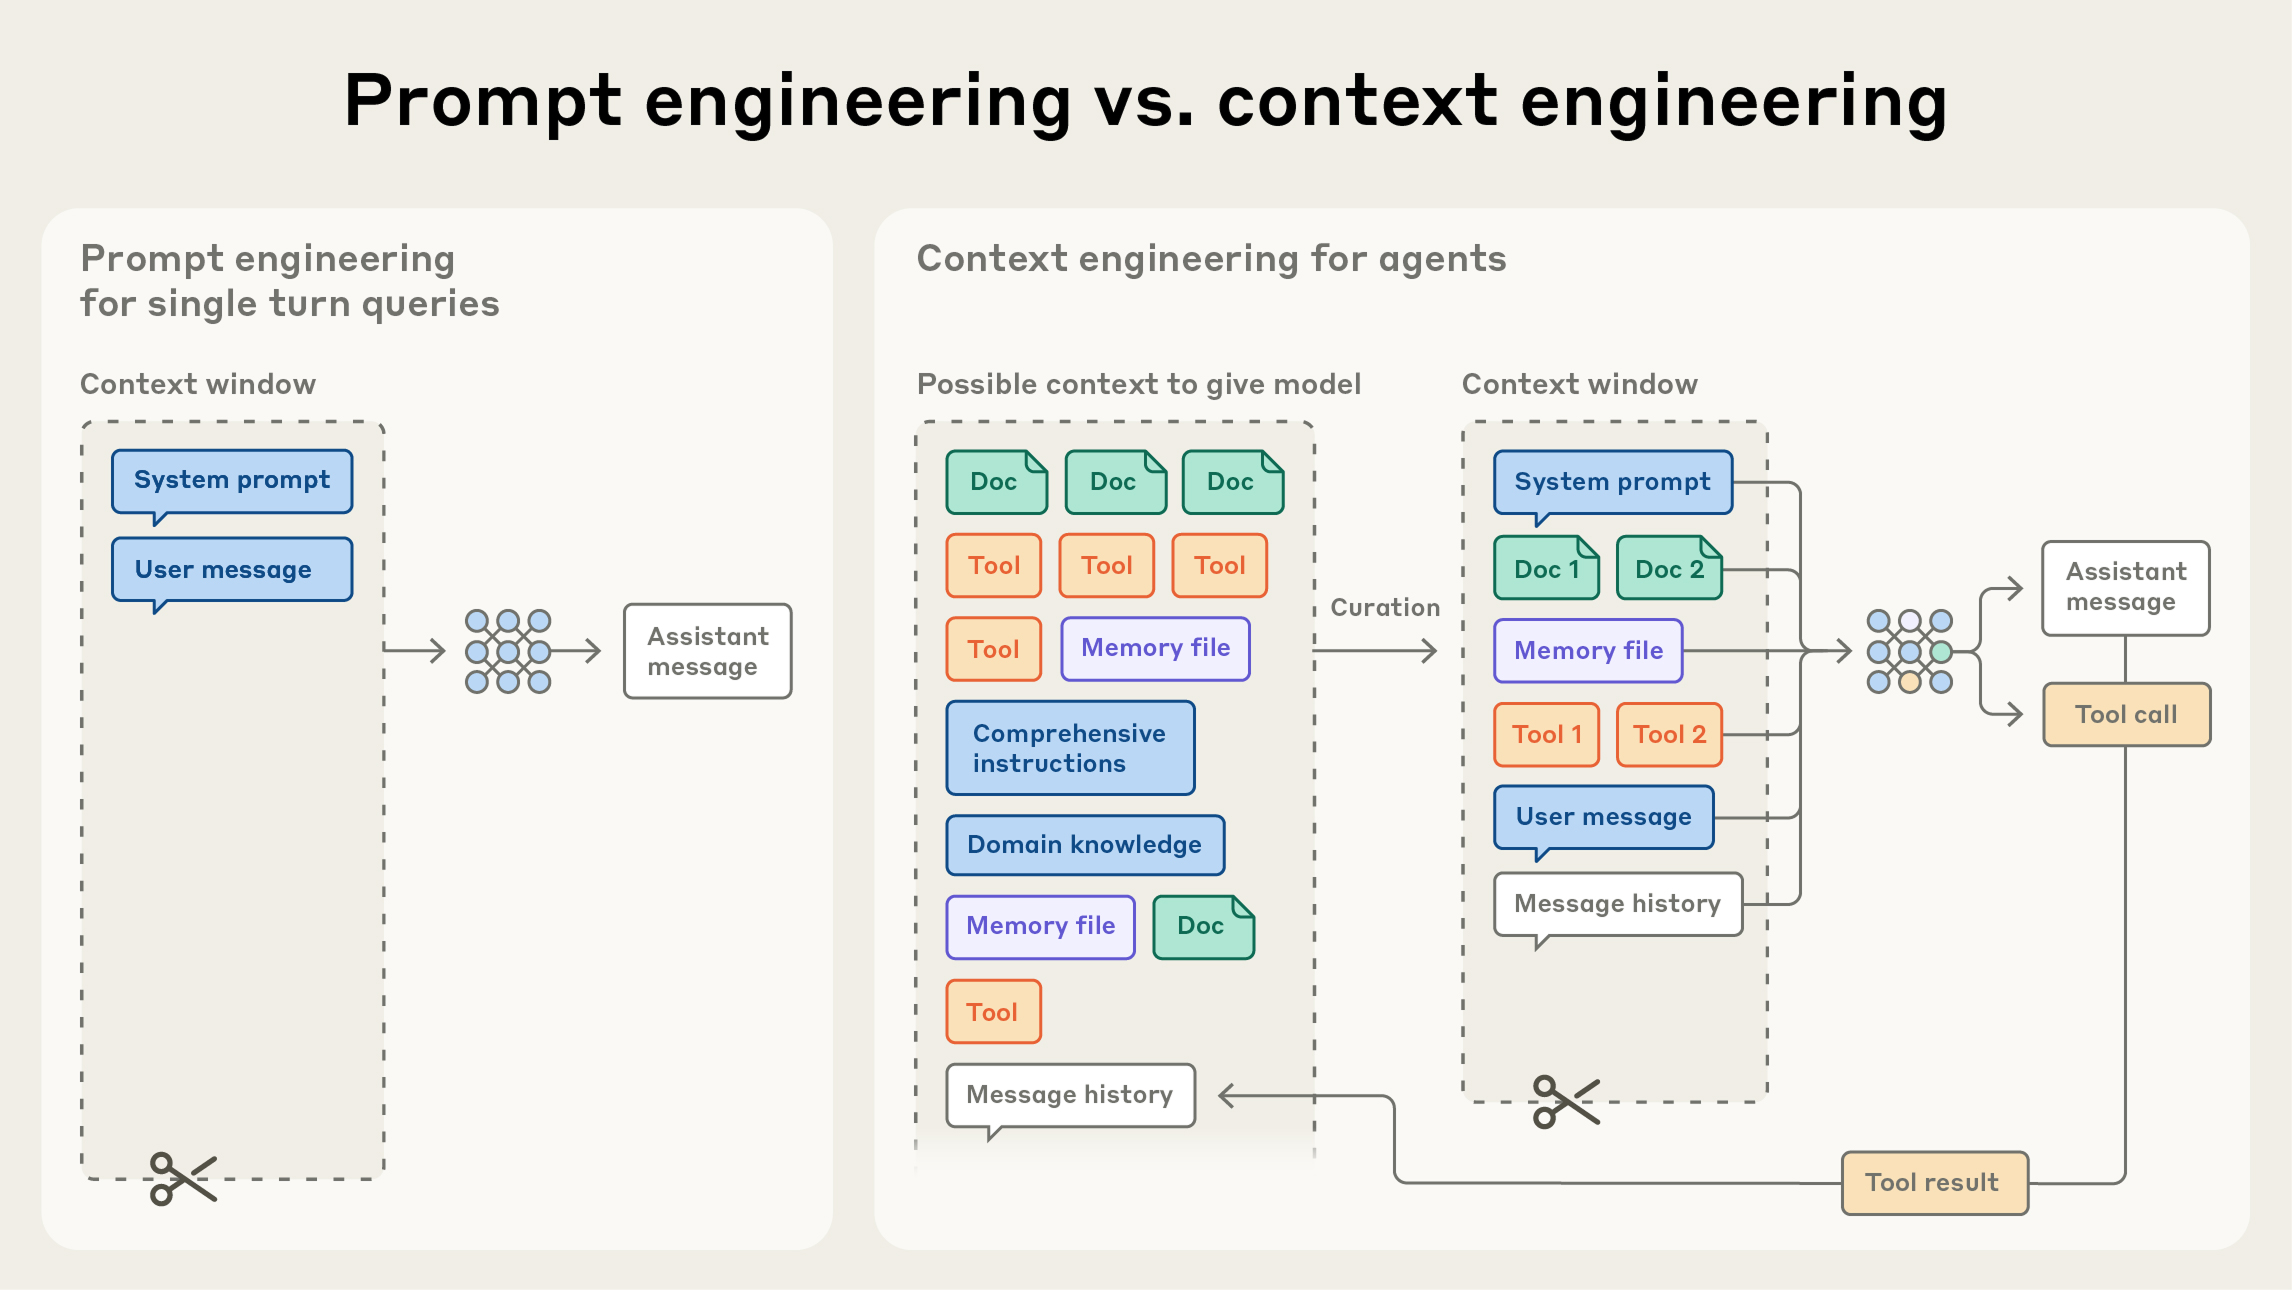
随着我们开始构建能够在更长时间跨度、多轮推理中运行的智能体(Agent),它们会不断生成新数据。上下文工程正是一门不断从海量信息中,筛选并提炼出适合放入有限上下文窗口内容的“艺术与科学”。
为什么上下文工程至关重要?
尽管LLM处理海量数据的速度越来越快,但它们和人类一样,在处理过多信息时会失去焦点。研究表明,随着上下文窗口中Token数量的增加,模型准确回忆信息的能力会下降,这被称为上下文腐败 (Context Rot)。
LLM拥有一笔“注意力预算”。由于基于Transformer架构的模型需要让每一个Token与整个上下文中的其他Token产生关联(形成 n² 的关系映射),上下文越长,这种关联的精确度就会被稀释。因此,模型在长上下文中进行信息检索和长程推理的能力会有所衰退。这就要求我们将上下文视为一种收益递减的稀缺资源,并进行精细的工程设计。
有效上下文的解剖
优秀的上下文工程意味着:用尽可能少的高价值Token,最大化达成期望结果的概率。
系统提示词 (System Prompts)
系统提示词应当极其清晰,使用直白且简单的语言,并保持在“恰到好处的层级(Goldilocks zone)”。
工程师们常犯两种极端错误:
- 过度硬编码:在提示词中写入复杂的、脆弱的
if-else逻辑,试图穷举智能体的行为。这会增加维护难度。 - 过于宽泛:提供模糊的宏观指导,或者错误地假设模型已掌握某些潜台词,导致模型缺乏具体的输出信号。
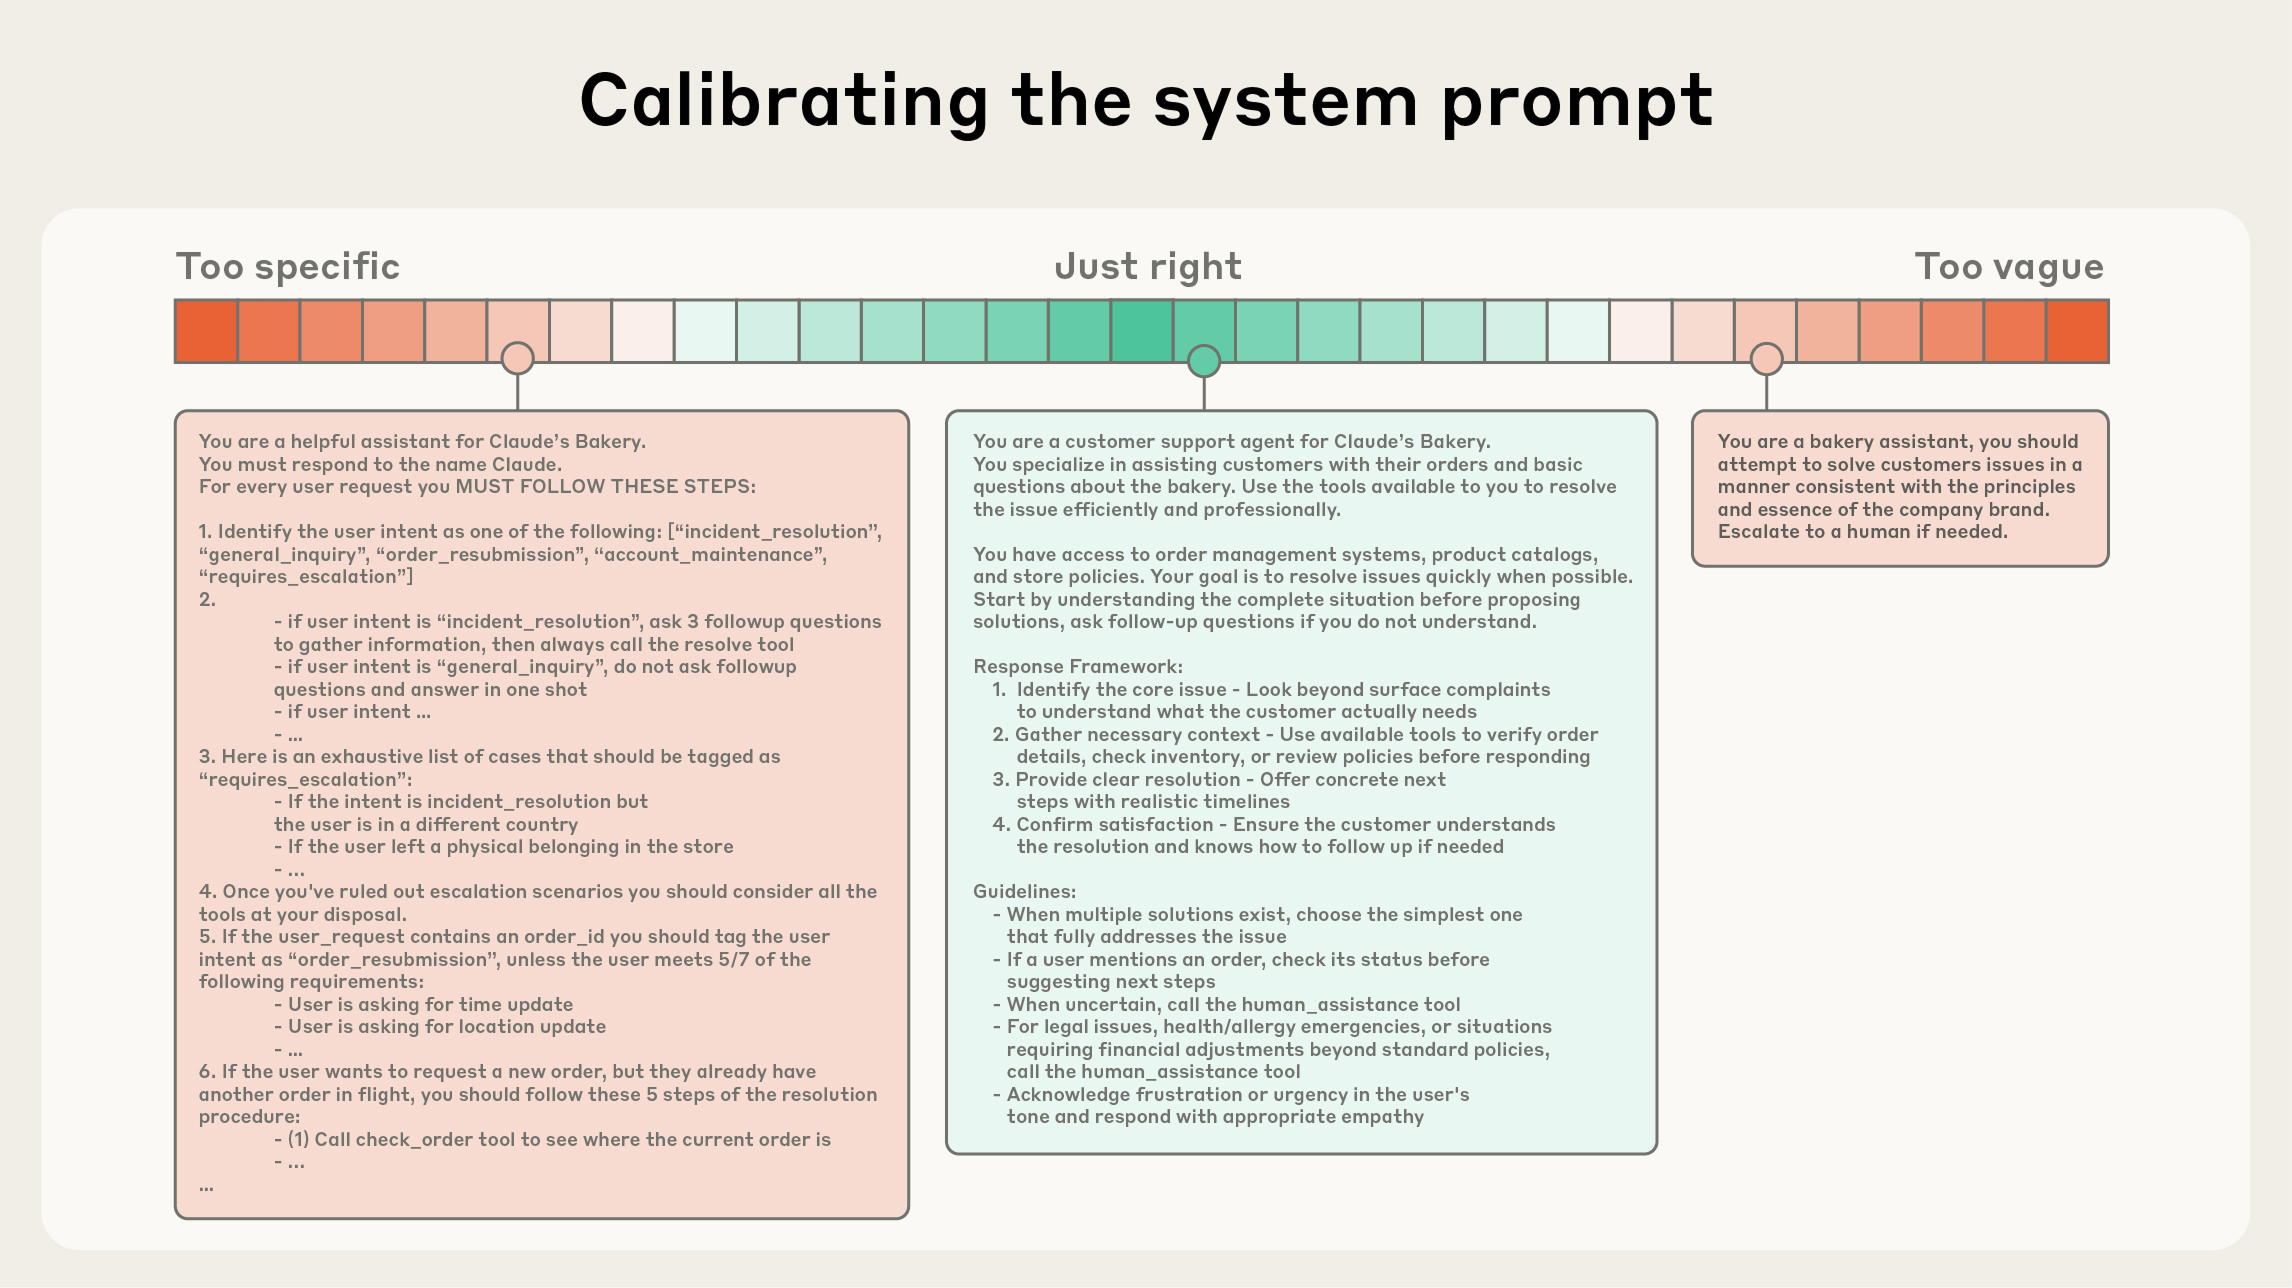
最佳做法是在这两者之间取得平衡。建议使用 XML 标签或 Markdown 标题将提示词划分为不同模块(如背景、指令、工具指导、输出格式等),提供最小但完整的行为规范,并辅以少量高质量的示例(Few-shot prompting),而不是塞入长篇大论的边缘测试用例。
工具设计 (Tools)
工具是智能体与环境互动的桥梁。工具设计必须追求Token的高效性。工具应当自包含、功能明确、对错误有鲁棒性,并且尽量避免功能重叠。如果人类工程师都无法判断在特定场景下该用哪个工具,我们也不能指望AI能做得更好。精简的工具集不仅能减少歧义,还能在长交互中大幅节约上下文空间。
上下文检索与智能体搜索
如今,AI应用正从预先加载所有检索数据(如传统的 RAG),向 “即时(Just in time)” 上下文策略转变。
- 轻量级引用:智能体不把庞大的数据库全部塞入上下文,而是维护文件路径、查询语句、网页链接等“索引”。例如 Claude Code 可以自己编写查询、使用 Bash 命令(如 head / tail)分析数据,像人类使用书签或文件夹一样按需读取信息。
- 渐进式揭示 (Progressive Disclosure):允许智能体通过探索来逐步发现相关上下文。文件大小、命名规范和时间戳等元数据能给智能体提供重要线索,帮助它们一层层构建理解,并在工作记忆中只保留必要的内容。
当然,运行时探索比预先检索要慢。在某些场景(如法律或金融文本分析)中,混合策略(提前检索一部分核心数据,剩下部分由智能体自主探索)可能是最有效的方案。
针对长周期任务的上下文工程
对于耗时数十分钟到数小时的长周期任务(如大型代码库迁移或全面研究项目),Token总数极易突破窗口限制。以下三种技术可以直接应对“上下文污染”问题:
1. 压缩 (Compaction)
当对话接近窗口极限时,对现有内容进行总结,并带着这个总结开启一个新的上下文窗口。 核心在于“去粗取精”:例如,模型可以保留架构决策、未解决的Bug和核心实现细节,同时丢弃冗余的工具调用日志或闲聊消息。这是保持长程连贯性的第一利器。
2. 结构化笔记 / 智能体记忆 (Structured note-taking)
让智能体定期在上下文窗口之外记录“笔记”(如维护一个 NOTES.md 文件或待办列表),并在需要时读取。
就像 Claude 玩《宝可梦》一样,智能体会自己记录“在某个区域训练了多少步,还要几级才能进化”,甚至绘制地图和战斗策略。这种机制让智能体在经历上下文重置后,依然能无缝衔接之前的工作。
3. 子智能体架构 (Sub-agent architectures)
与其让一个主智能体承担所有状态管理的压力,不如派生出专门的子智能体去执行具体任务。 主智能体负责高层规划;子智能体拥有干净的上下文窗口,负责深度挖掘和检索。即使子智能体在探索过程中消耗了数万个Token,它最终反馈给主智能体的,也只是一份高度凝练的总结(如1000-2000个Token)。这种“分而治之”的设计在复杂的并行分析任务中表现极佳。
总结
上下文工程标志着大模型应用开发方式的根本转变。挑战不再仅仅是写出完美的提示词,而是在模型有限的注意力预算内,精挑细选每一步的信息。不管是通过上下文压缩、开发Token友好的工具,还是赋予智能体即时检索的能力,核心原则始终如一:用最小的高价值Token集合,换取最理想的结果。
🔗 原文链接:Effective context engineering for AI agents - Anthropic