AI Agents 的持续学习 (Continual Learning for AI Agents)
快速阅读
多数关于 AI 持续学习的讨论只关注模型权重的更新。但在 AI Agents 领域,学习实际上可以发生在三个截然不同的层级:模型层 (Model)、脚手架层 (Harness) 和上下文层 (Context)。理解这些区别将彻底改变你对构建随时间进化的 AI 系统的思考方式。本文详细解析了这三个维度的持续学习机制,并提供了具体的框架比对。
大多数关于 AI 持续学习的讨论都聚焦在一件事上:更新模型权重。但对于 AI Agents 来说,学习可以发生在三个不同的层级:模型层、脚手架层 (Harness) 和上下文层 (Context)。理解这些差异,会彻底改变你对“如何构建一个能够随时间推移不断自我改进的系统”的看法。
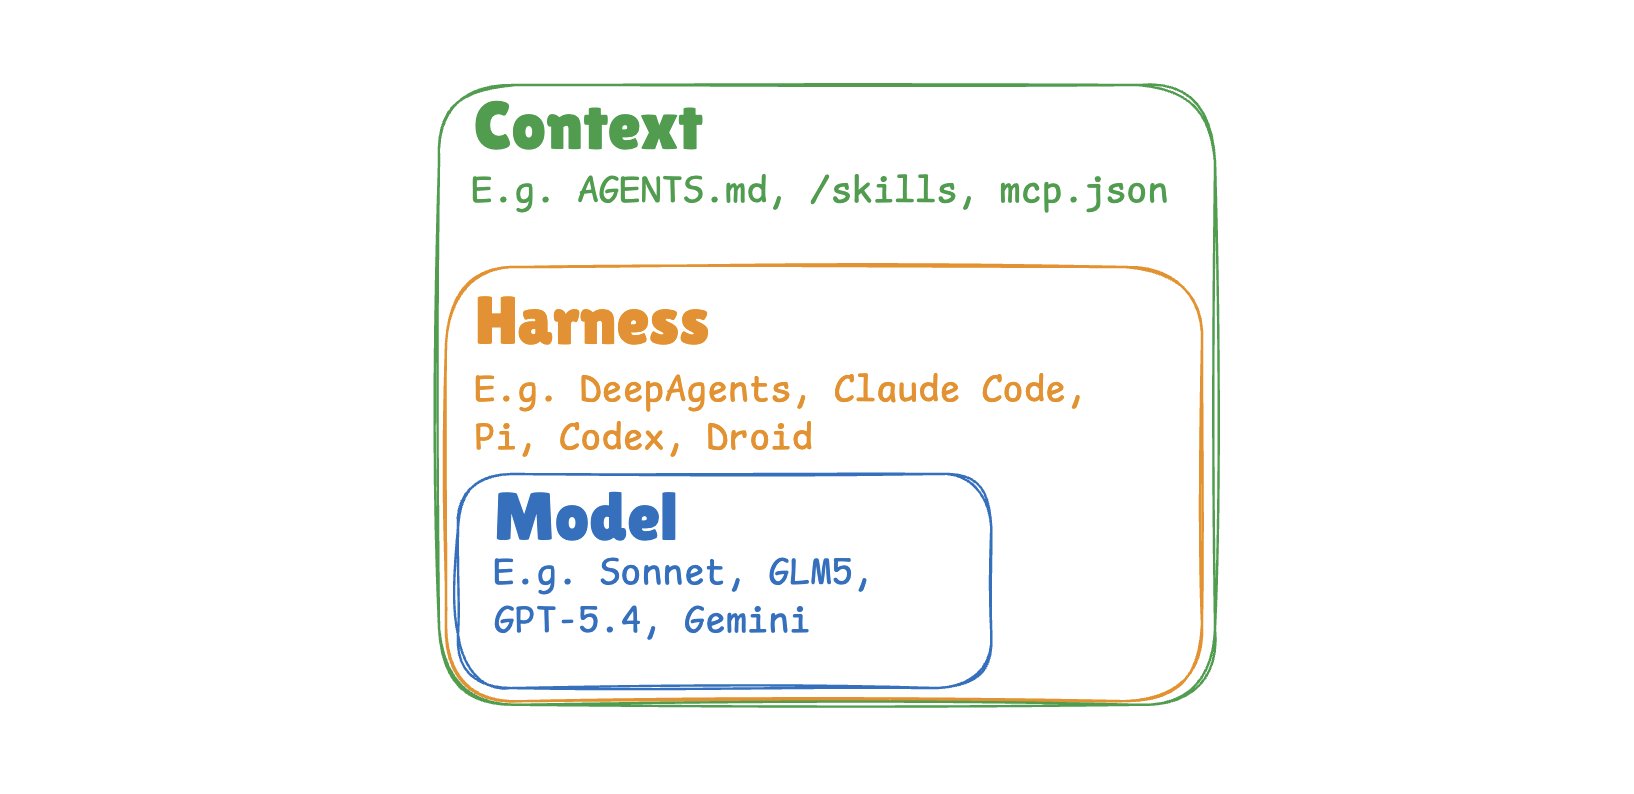
Agentic(代理式)系统的三个主要层级是:
- 模型 (Model):模型权重本身。
- 脚手架 (Harness):围绕模型构建、为所有 Agent 实例提供动力的外围代码结构。它不仅包含了驱动 Agent 的核心逻辑,还包括那些“始终作为脚手架一部分”的指令或工具。
- 上下文 (Context):存在于脚手架之外的额外上下文(如自定义指令、特定技能),可用于对脚手架进行配置和定制。
示例 #1:以 Claude Code 这类编程 Agent 为例
- 模型:claude-sonnet 等等
- 脚手架:Claude Code 本身的执行逻辑
- 用户上下文:
CLAUDE.md文件、/skills、mcp.json
示例 #2:以 OpenClaw 为例
- 模型:支持多种模型
- 脚手架:Pi 以及其他脚手架模块
- Agent 上下文:
SOUL.md以及来自 clawhub 的技能 (skills)
当我们谈论持续学习时,大多数人会立刻想到更新模型。但在现实中,一个 AI 系统完全可以在上述三个层面上同时进行学习和进化。
模型层 (Model) 的持续学习
当大多数人谈到“持续学习”时,最常指的就是更新模型权重。常见的更新技术包括 SFT(监督微调)、RL(强化学习,比如 GRPO)等。
这里的一个核心挑战是“灾难性遗忘 (catastrophic forgetting)”——当模型在新的数据或任务上更新时,它往往会遗忘之前学过的知识。目前这仍是一个开放的学术难题。当开发者为特定的 Agent 系统训练模型时(比如,你可以把 OpenAI 的 Codex 模型看作是专为他们的 Codex Agent 训练的),通常是在系统级别进行整体优化。理论上,你可以做到更细粒度的优化(比如为每个用户分配一个专属的 LORA),但在实际工程中,这种模型层的更新通常还是保持在通用 Agent 级别。
脚手架层 (Harness) 的持续学习
如前所述,脚手架指的是驱动 Agent 的代码,以及那些永久绑定的内置指令或工具。随着脚手架技术变得日益流行,开始出现一些研究探讨如何优化这些脚手架。
最近的一篇值得关注的论文是《Meta-Harness: End-to-End Optimization of Model Harnesses》。它的核心思想是:Agent 在一个闭环中运行。你先让它在大量任务上执行,然后评估结果,并将这些执行日志(logs)存储在文件系统中。接下来,你运行另一个编程 Agent 去审视这些运行轨迹(traces),并让它对现有的脚手架代码提出修改建议。
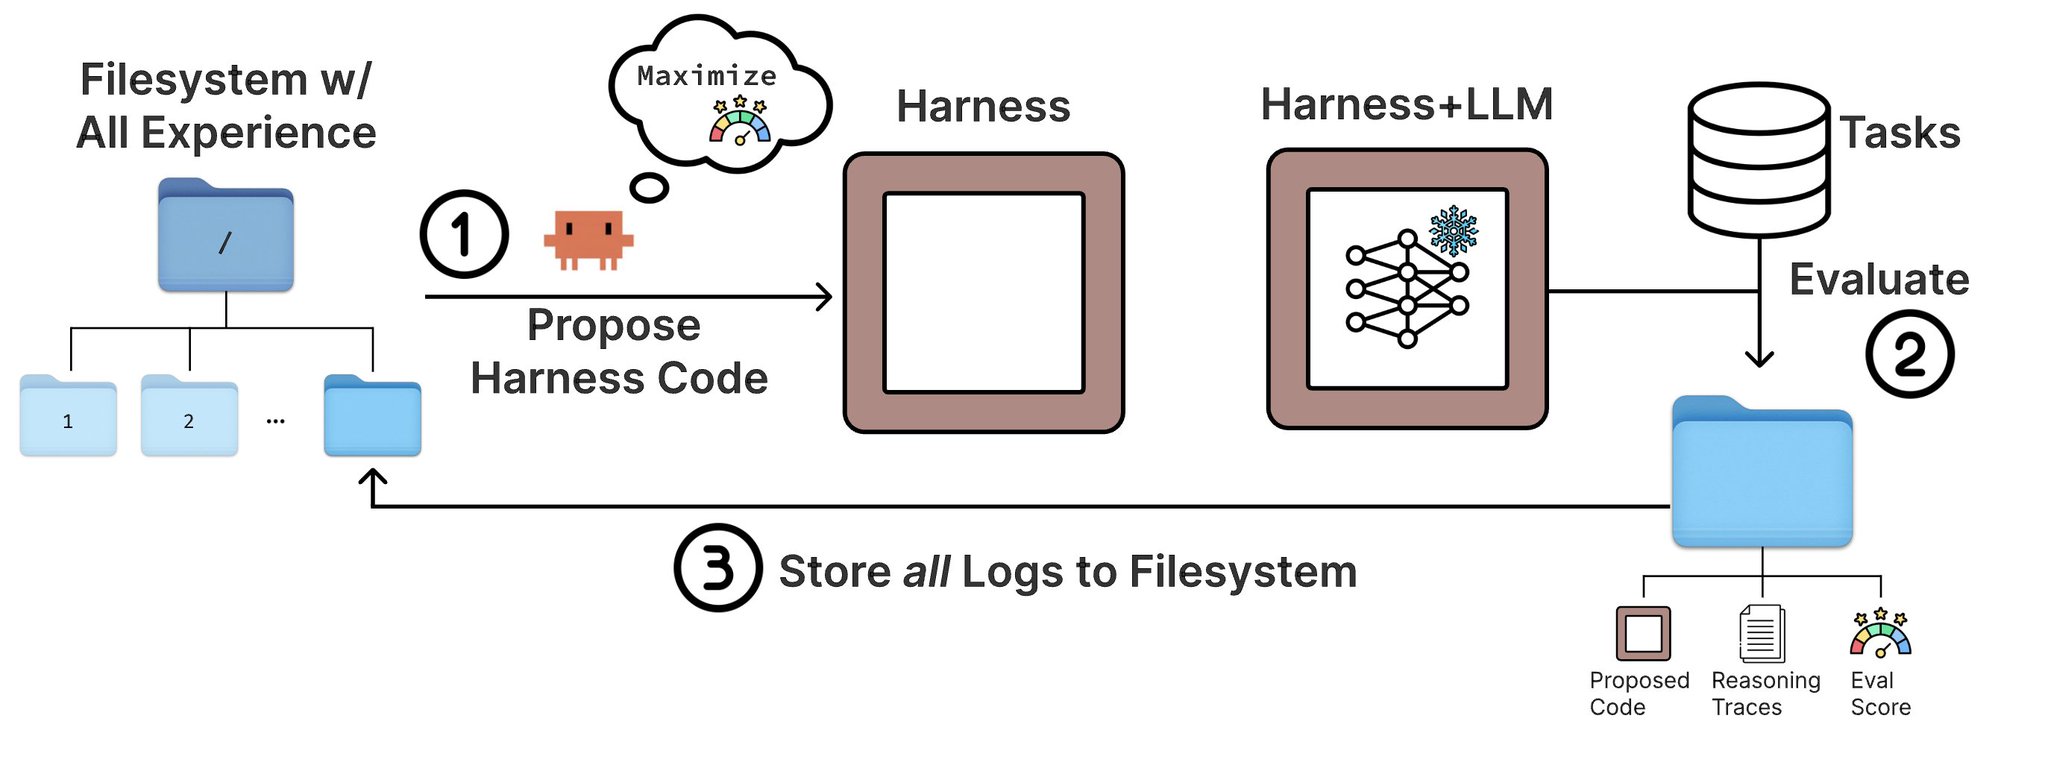
与模型的持续学习类似,脚手架的优化通常也是在系统/Agent 级别完成的。当然,理论上你也可以实现更细的粒度(比如为不同用户学习并演化出一套截然不同的脚手架代码)。
上下文层 (Context) 的持续学习
“上下文”位于脚手架之外,用于配置脚手架的行为。上下文包括指令、技能甚至特定工具。这通常也被称为“记忆 (Memory)”。
需要注意的是,类似的上下文在脚手架内部也存在(比如脚手架的硬编码 System Prompt 及其自带技能)。两者的区别主要在于:它到底是作为脚手架的底层代码存在,还是作为可配置项存在。
上下文学习可以在多个不同层级进行:
- Agent 级别:Agent 拥有持久的“记忆”,并随着时间的推移更新自身的配置。一个绝佳的例子就是 OpenClaw,它拥有自己的
SOUL.md,并在运行过程中不断自我更新。 - 租户/用户级别(最常见):比如个人用户、组织、团队等。在这种情况下,每个租户都有自己独立的上下文,并且独立进化。例如 Hex 的 Context Studio、Decagon 的 Duet 以及 Sierra 的 Explorer。
你甚至可以将这些维度混合搭配!例如,你可以拥有一个 Agent,它同时接收“Agent 级别”、“用户级别”以及“组织级别”的上下文更新。
这类更新可以通过以下两种方式完成:
- 离线异步任务 (Offline job):类似于脚手架的更新——在事后遍历一批最近的执行轨迹(traces),提取核心洞察,然后更新上下文。这也就是 OpenClaw 中所谓的“做梦机制 (Dreaming)”。
- 热路径实时更新 (In the hot path):在 Agent 运行任务的过程中实时更新。Agent 可以自行决定(或者由用户显式提示)在执行核心任务的同时,动态更新自己的记忆。
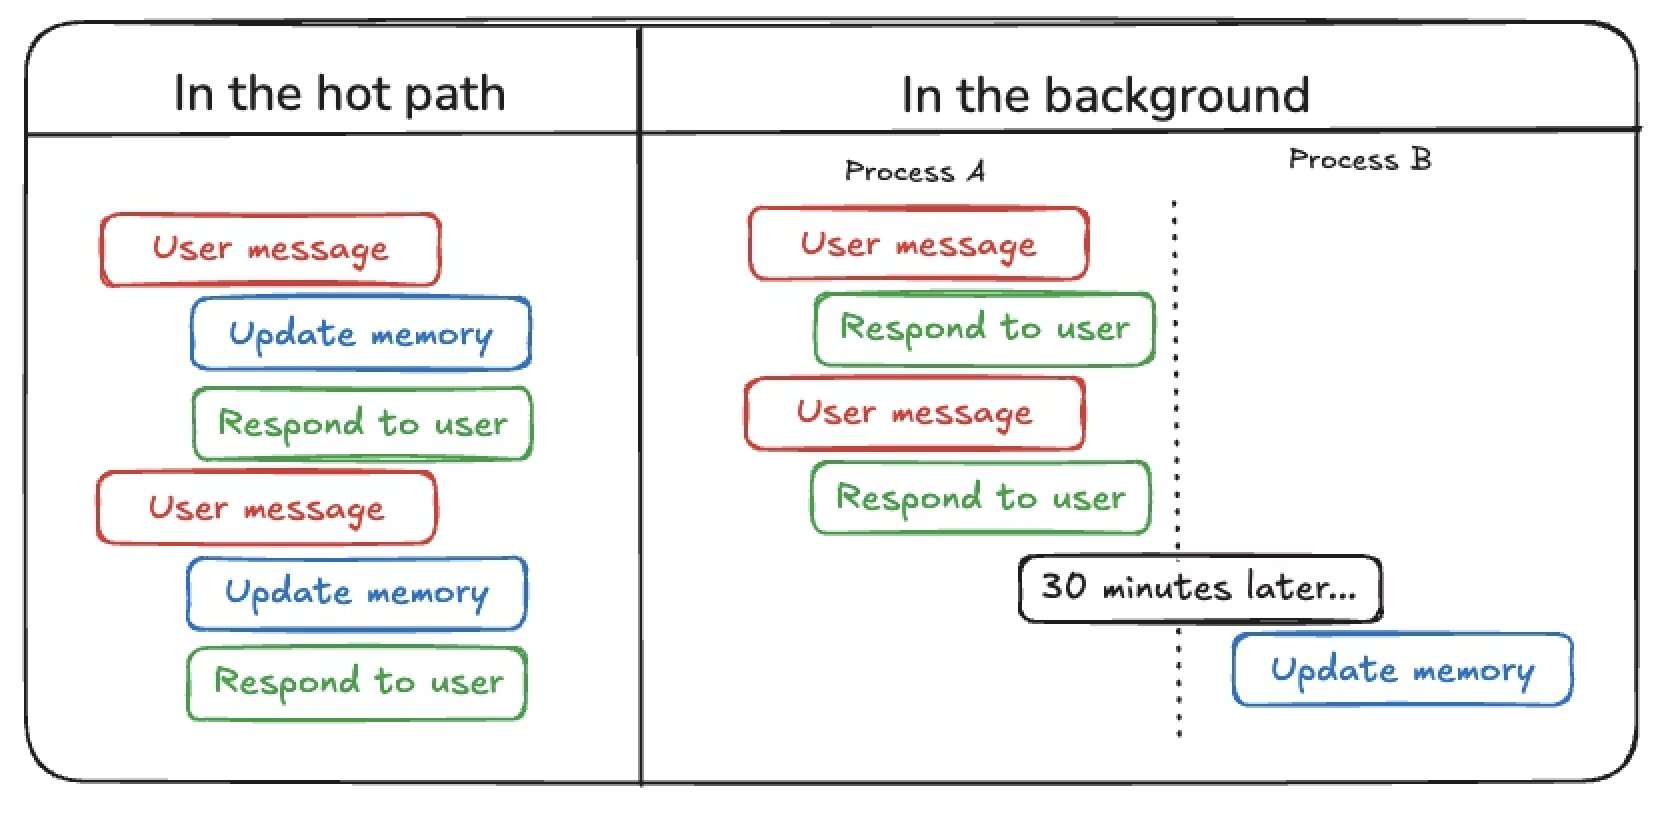
这里还需要考虑的另一个维度是记忆更新的显式程度:是用户明确地提示(prompt)Agent 必须去记住某件事,还是 Agent 根据脚手架里的核心指令自主决定进行记忆?
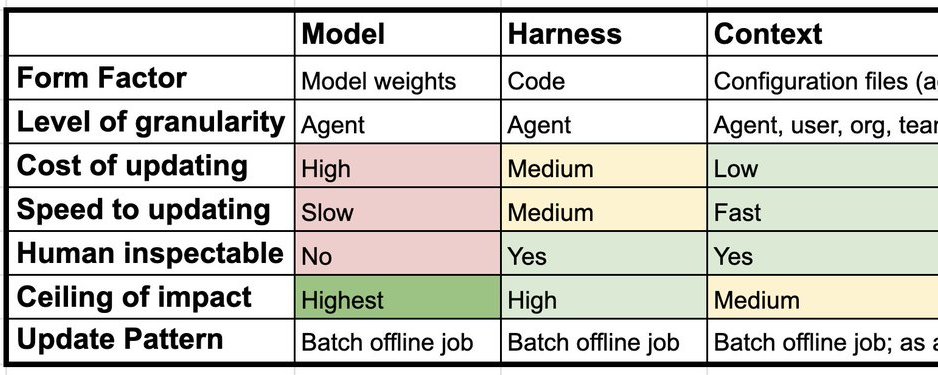
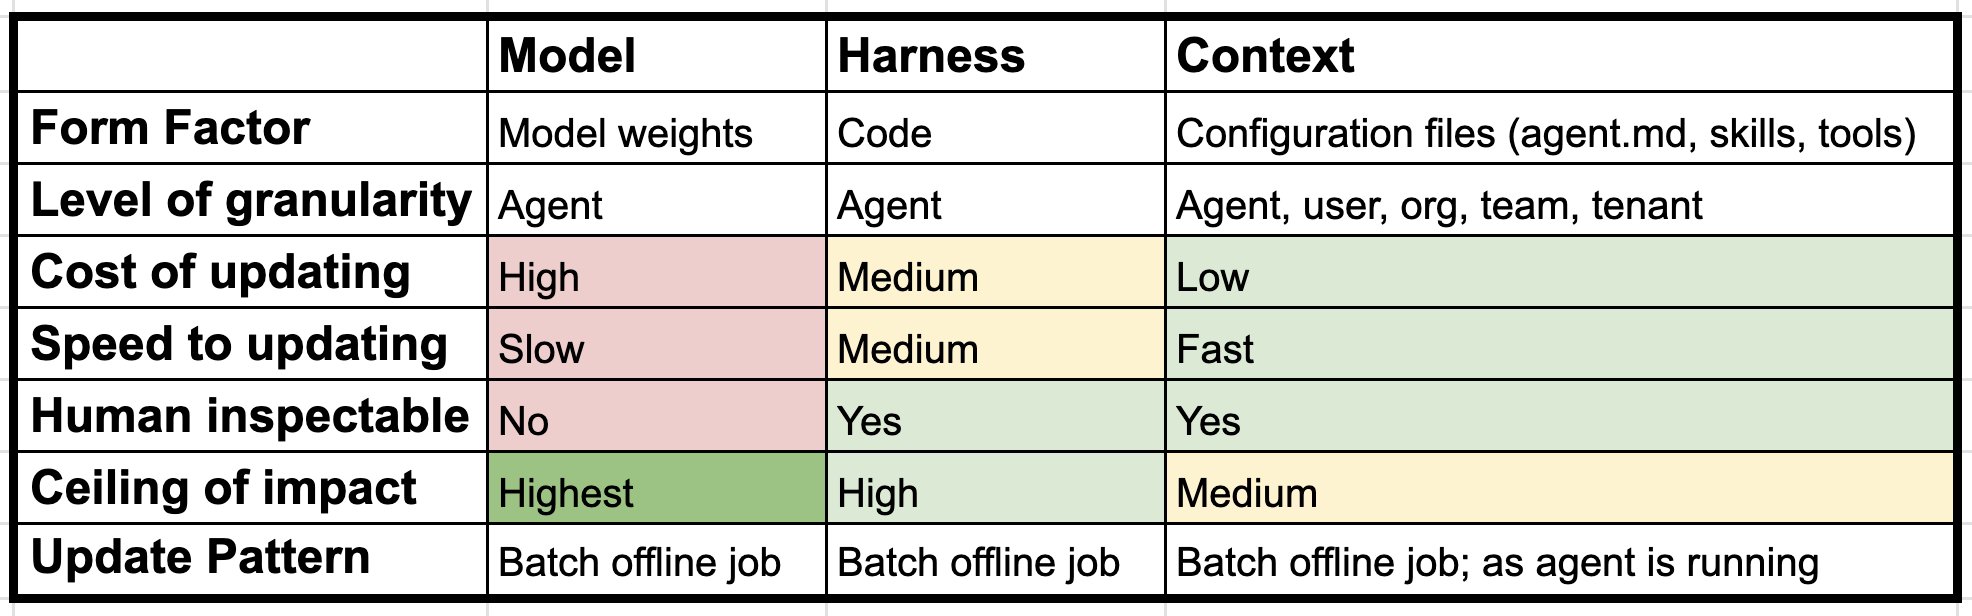
综合比对 (Comparison)
核心引擎:运行轨迹 (Traces)
所有这些持续学习流程的底层支撑都是运行轨迹 (Traces) —— 即 Agent 执行过程的完整路径记录。
LangSmith 是 LangChain 提供的平台,它(除其他功能外)能帮助收集这些 traces。随后你可以以多种方式利用它们:
- 如果你想更新模型,可以收集 traces 并与像 Prime Intellect 这样的平台合作来训练专属模型。
- 如果你想优化脚手架,可以使用 LangSmith CLI 和 LangSmith Skills 让编程 Agent 能够访问这些 traces。这也是团队在 terminal bench 上优化 Deep Agents(一款开源、与模型无关的通用基础脚手架)的工作模式。
- 如果你想在不同层级(Agent、用户或组织)进行持续的上下文学习,那么你的 Agent 脚手架必须原生支持这一点。Deep Agents 目前已经在生产级别的方案中支持了此功能。可以在官方文档中查看关于用户级记忆、后台学习(background learning)等高级用法的示例。
(特别感谢 @sydneyrunkle, @Vtrivedy10, @nfcampos 对本文提供的审阅与反馈)