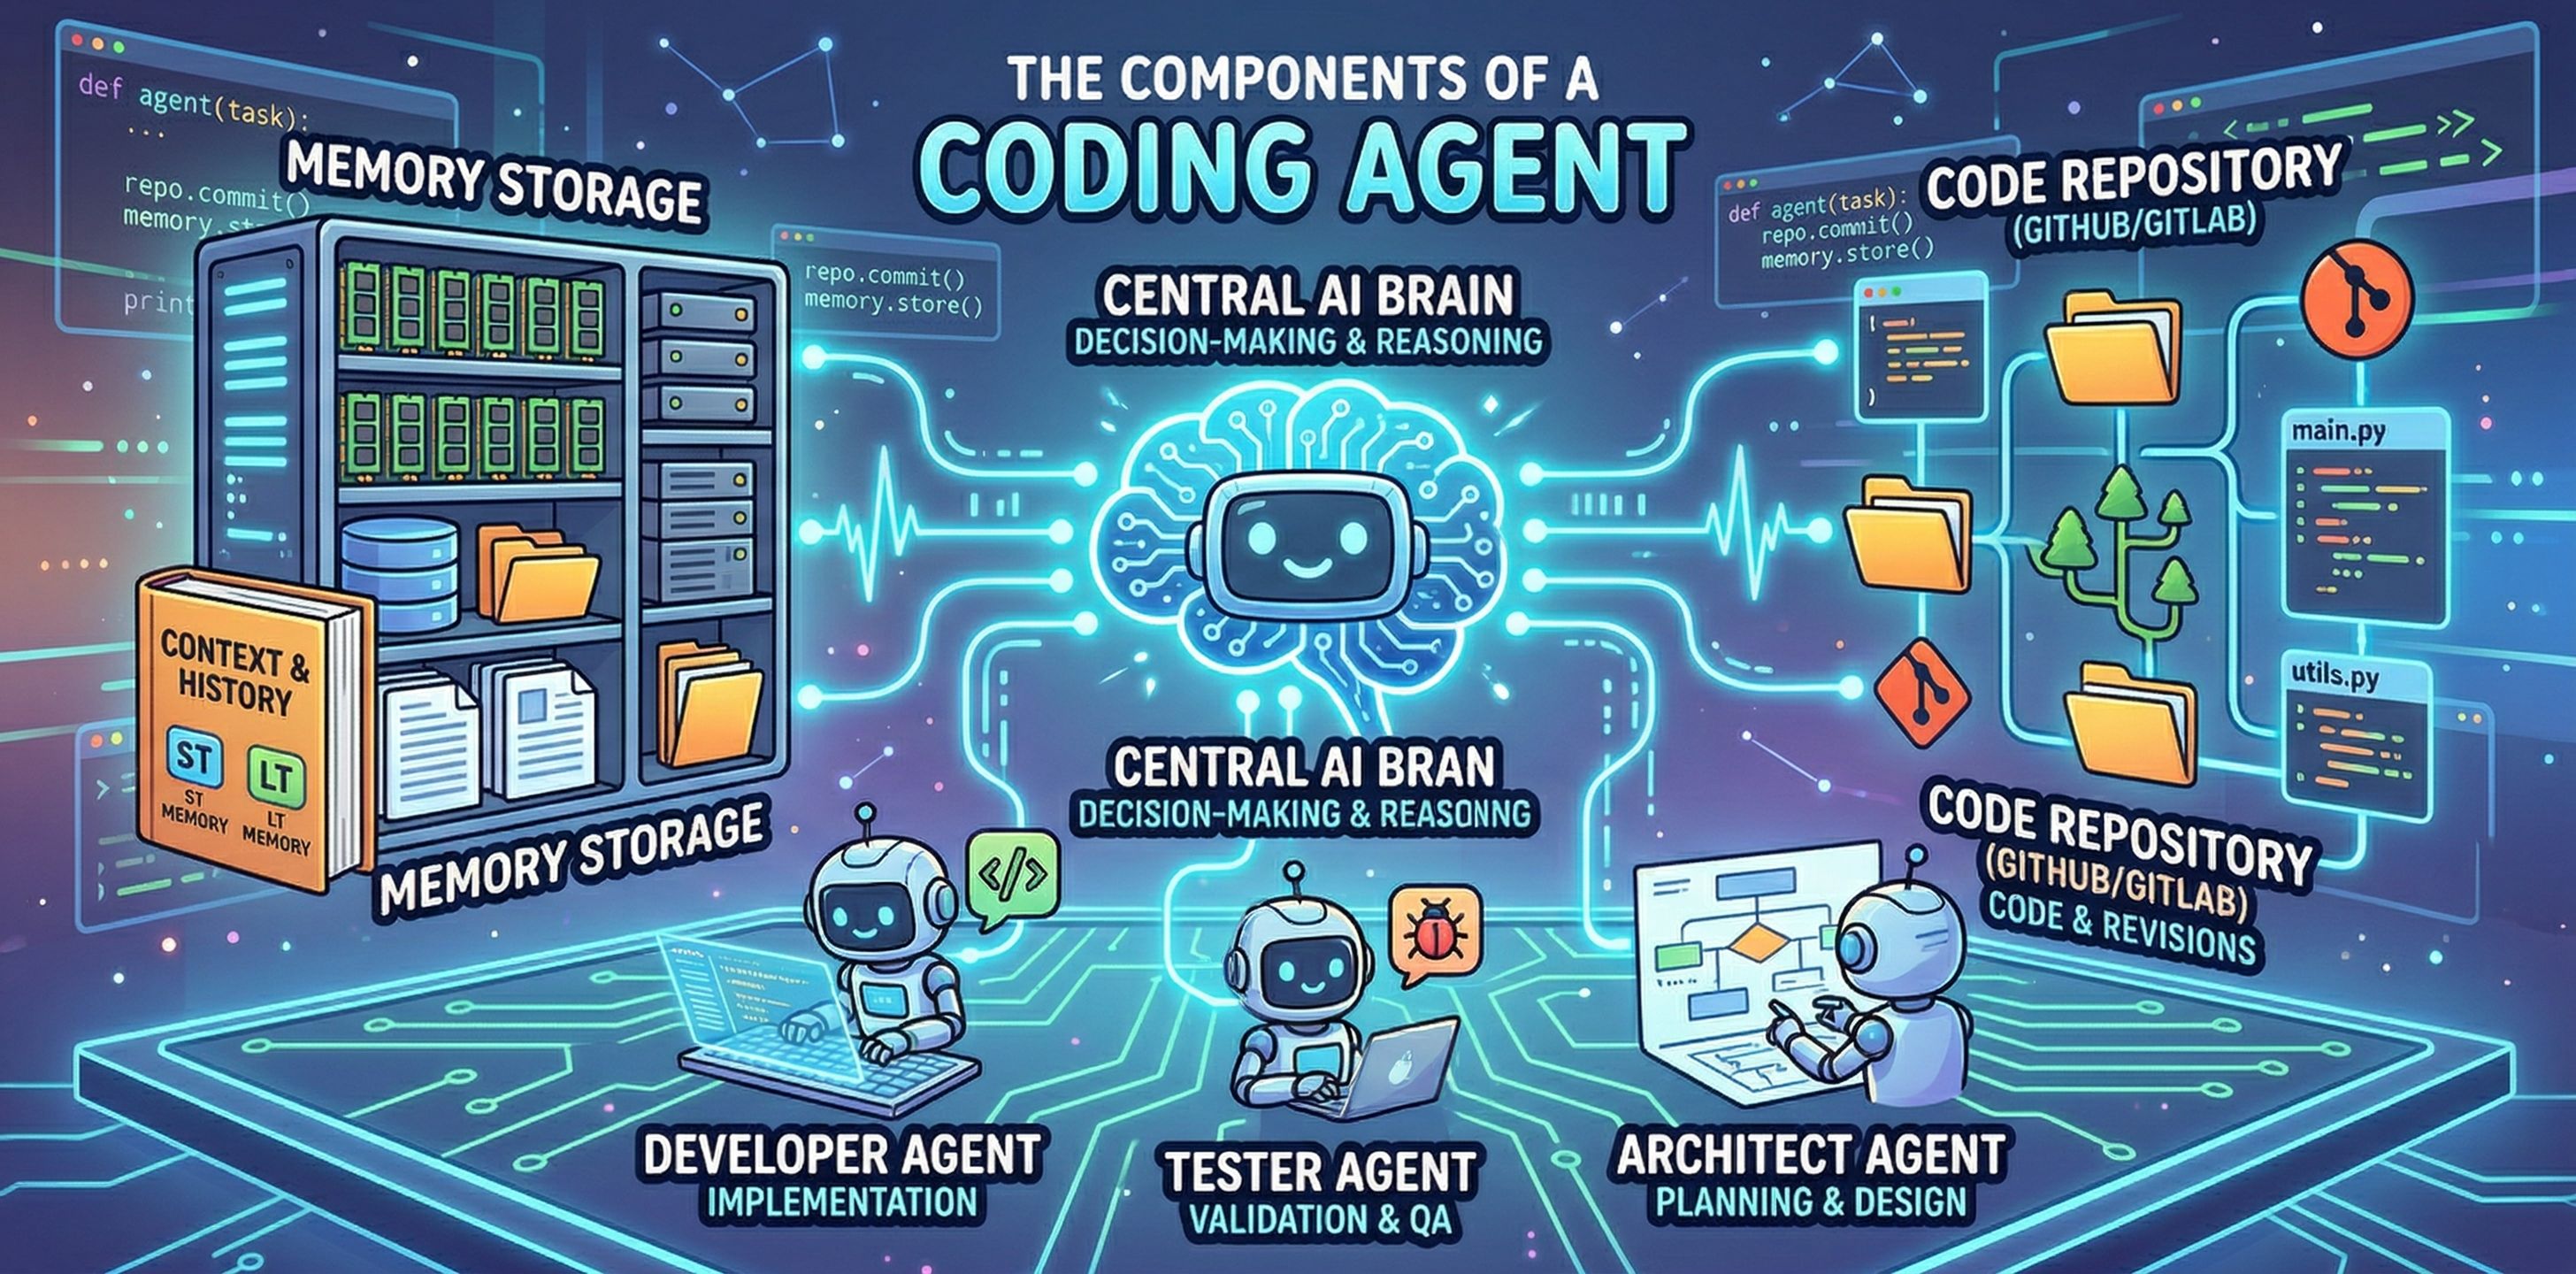
解析代码 Agent 的核心组件
快速阅读
本文由 Sebastian Raschka 撰写,深入剖析了代码 Agent(Coding Agent)以及代理运行环境(Agent Harness)的整体设计和工作原理。作者指出,现代大语言模型(LLM)系统在实际应用中,外围系统的设计(如工具调用、上下文管理和记忆存储)往往与模型本身同等重要。文章提炼了代码 Agent 的六大关键构建模块:1) 实时代码库上下文,2) 提示词结构与缓存复用,3) 结构化工具与权限验证,4) 上下文压缩与输出管理,5) 运行记录、记忆与状态恢复,6) 任务委派与受限子代理(Subagents)。理解这些组件有助于我们构建和使用更强大的开发辅助工具。
大语言模型、推理模型与 Agent
在深入探讨代码 Agent 具体细节之前,我们需要明确几个核心概念的区别:LLM、推理模型和 Agent。
- LLM(大语言模型):这是底层的“引擎”,主要负责生成下一个 token。
- 推理模型(Reasoning Model):仍然是 LLM,但经过特殊训练或提示,会在推理阶段花费更多算力用于中间推理、自我验证或搜索候选答案。可以把它看作是一个“增强版引擎”。
- Agent(代理):是架设在模型之上的控制循环。给定一个目标后,Agent 层(或称为 Harness 运行环境)会决定接下来检查什么、调用哪些工具、如何更新状态以及何时停止等。
- Agent Harness(代理运行环境):围绕 Agent 的软件脚手架,用于管理上下文、工具使用、提示词、状态和控制流。
- Coding Harness(代码运行环境):针对软件工程任务的专用环境,用于管理代码上下文、工具、代码执行及迭代反馈(例如 Claude Code 或 Codex)。
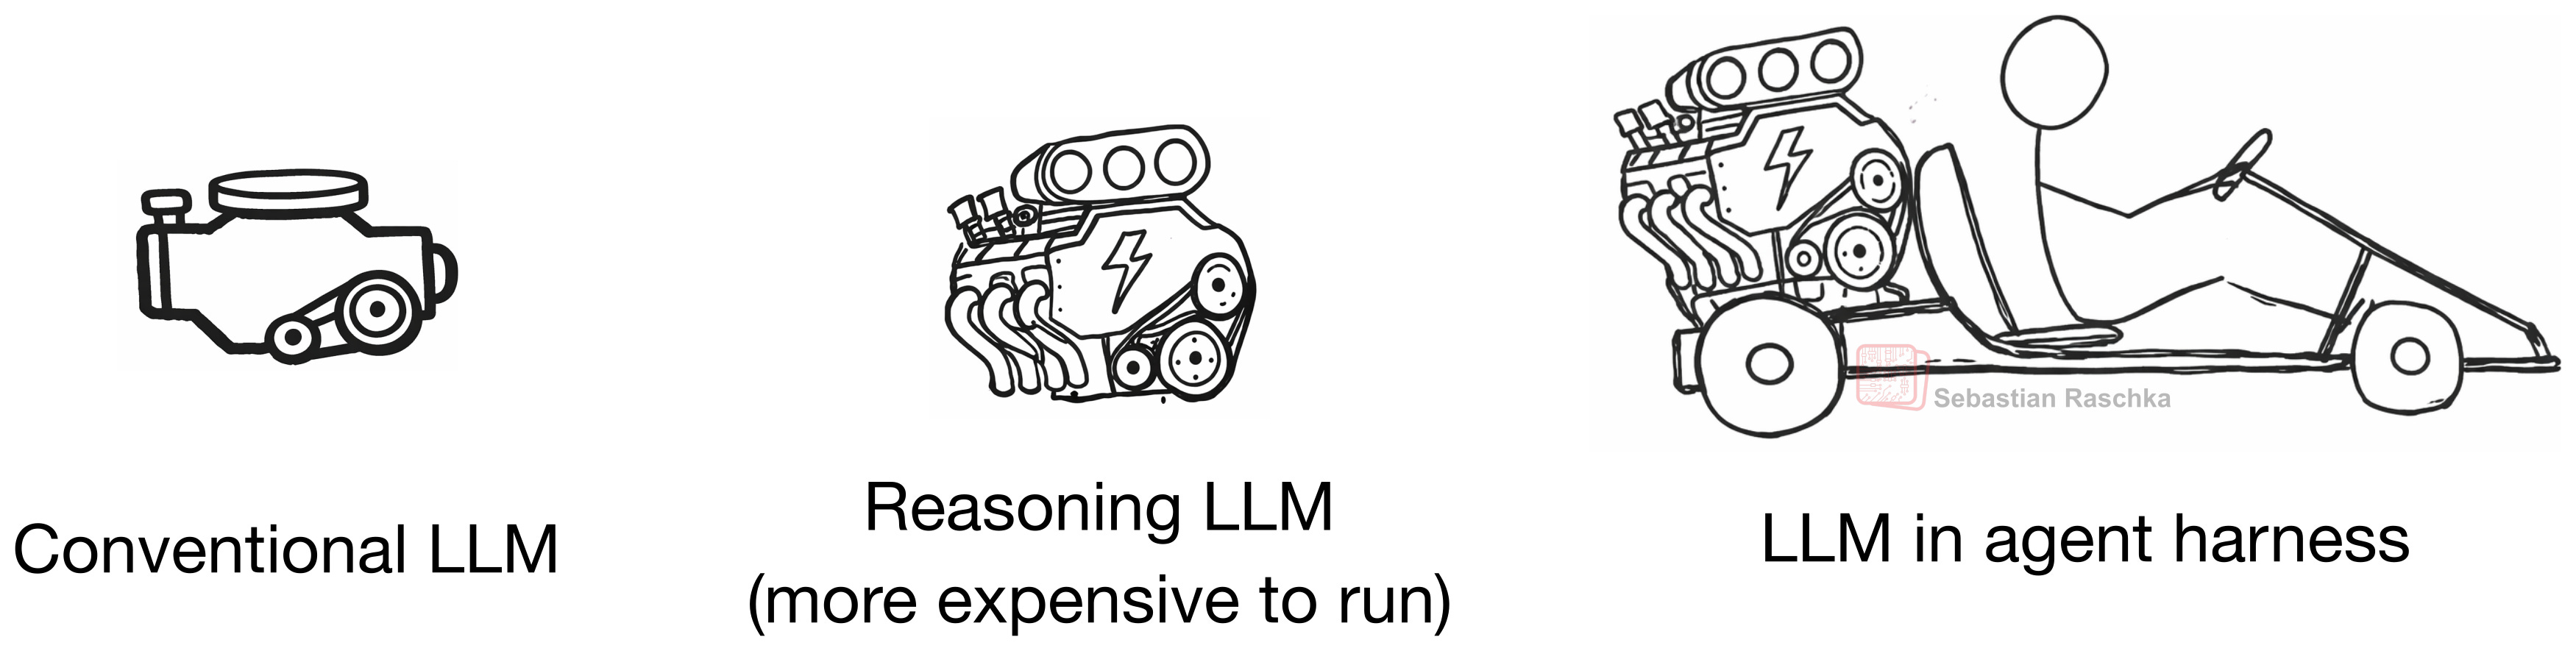 图 2:常规 LLM、推理模型以及封装在 Agent 运行环境中的 LLM 之间的关系。
正如你所见,出色的代码运行环境(Coding Harness)能够让模型在解决编程问题时显得异常强大。它不仅仅依靠模型的“Next-token”生成能力,更包含了对代码库的导航、搜索、函数查找、应用差异补丁(Diff)、执行测试等复杂的精神劳动。
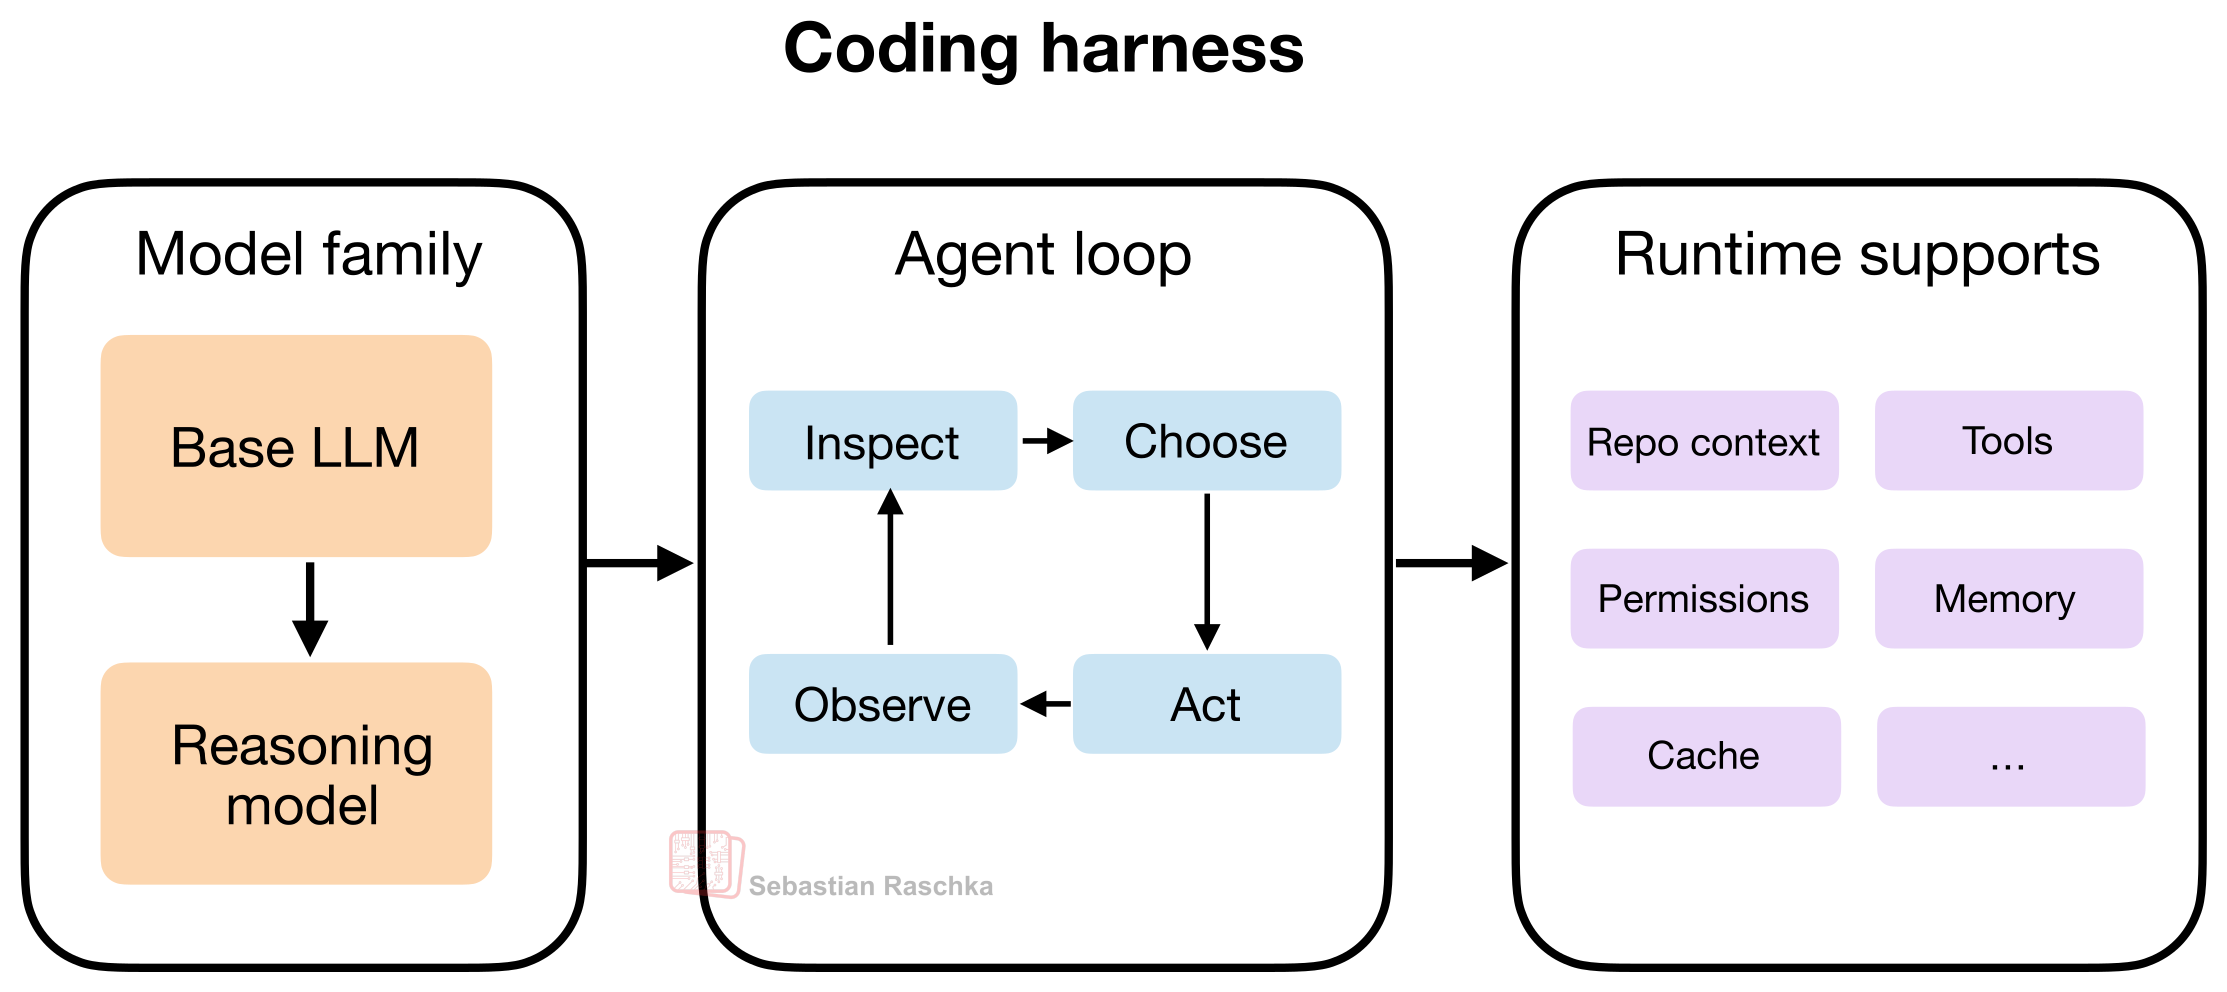 图 3:代码运行环境结合了三个层次:模型族、Agent 循环以及运行时支撑。
编写代码 Agent 的六个核心组件
作者在他自己从零实现的 Mini Coding Agent 项目中,将 Agent 提炼为以下六个主要模块:
##############################
#### Six Agent Components ####
##############################
# 1) Live Repo Context -> WorkspaceContext
# 2) Prompt Shape And Cache Reuse -> build_prefix, memory_text, prompt
# 3) Structured Tools, Validation, And Permissions -> build_tools, run_tool, validate_tool, approve, parse, path, tool_*
# 4) Context Reduction And Output Management -> clip, history_text
# 5) Transcripts, Memory, And Resumption -> SessionStore, record, note_tool, ask, reset
# 6) Delegation And Bounded Subagents -> tool_delegate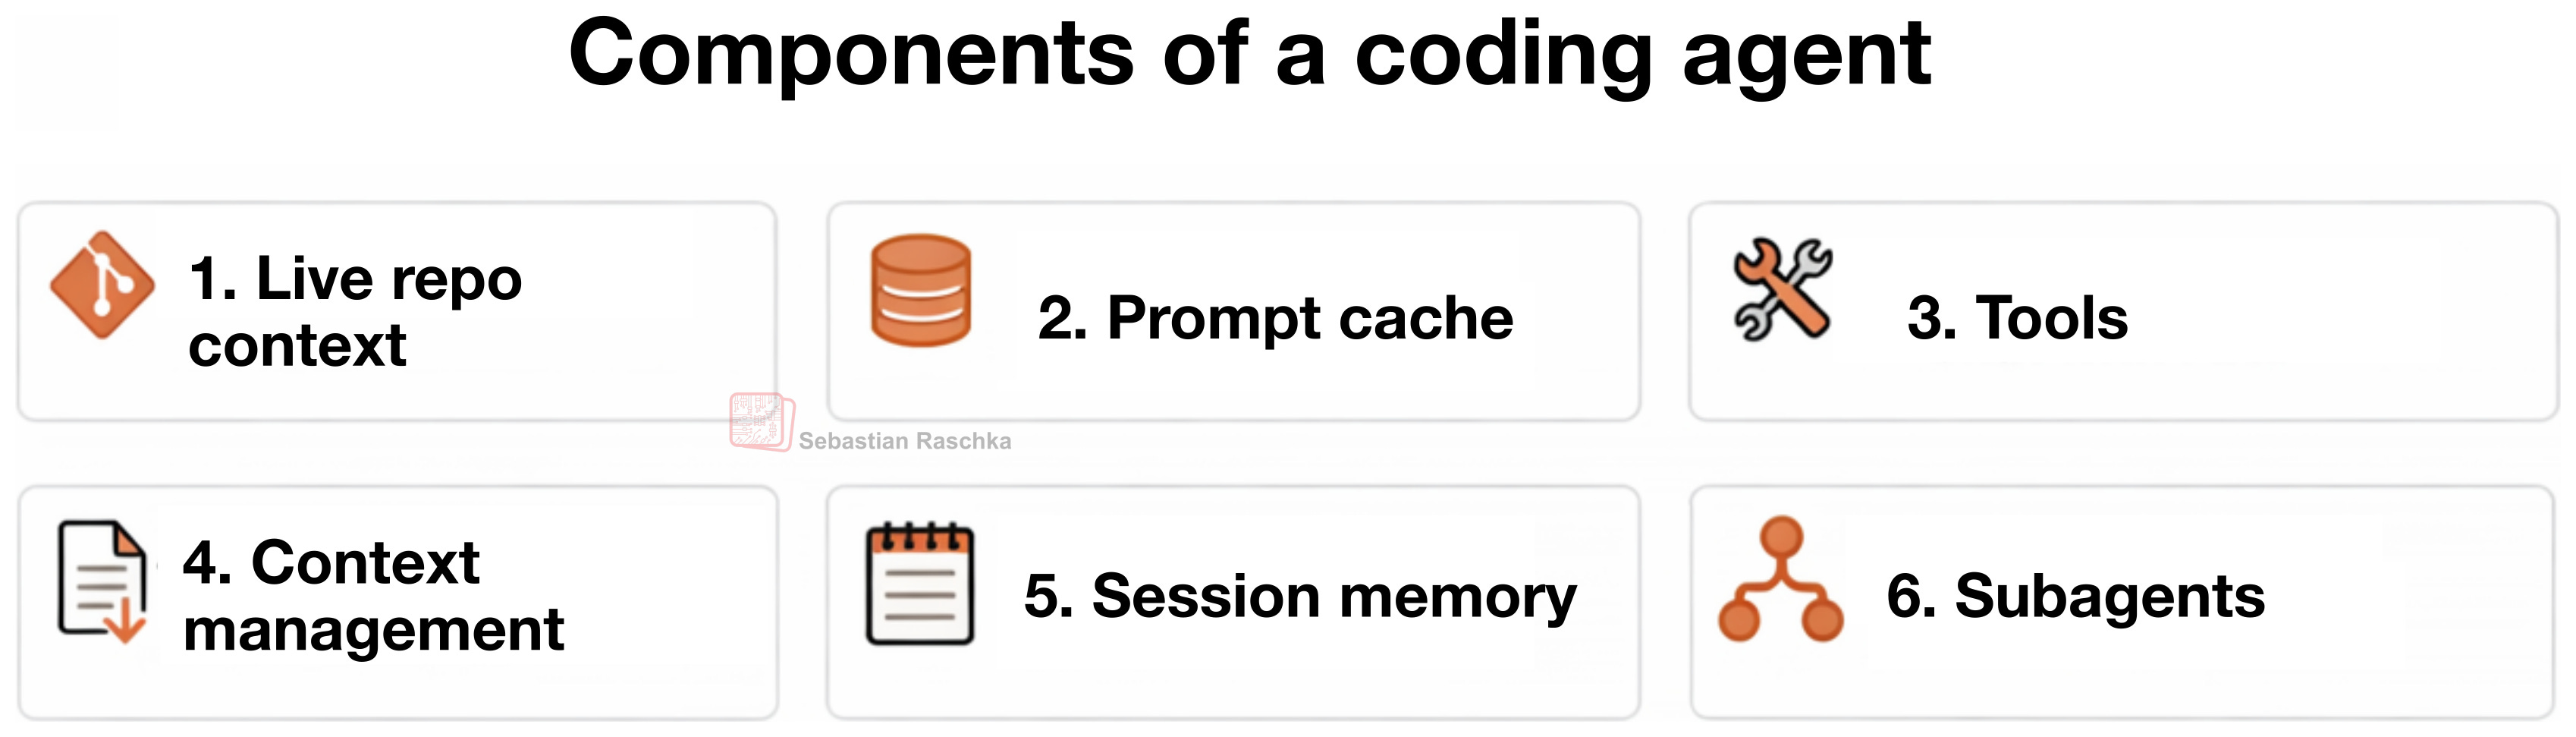 图 4:在以下章节中将讨论的代码 Agent/代码运行环境的主要特性。
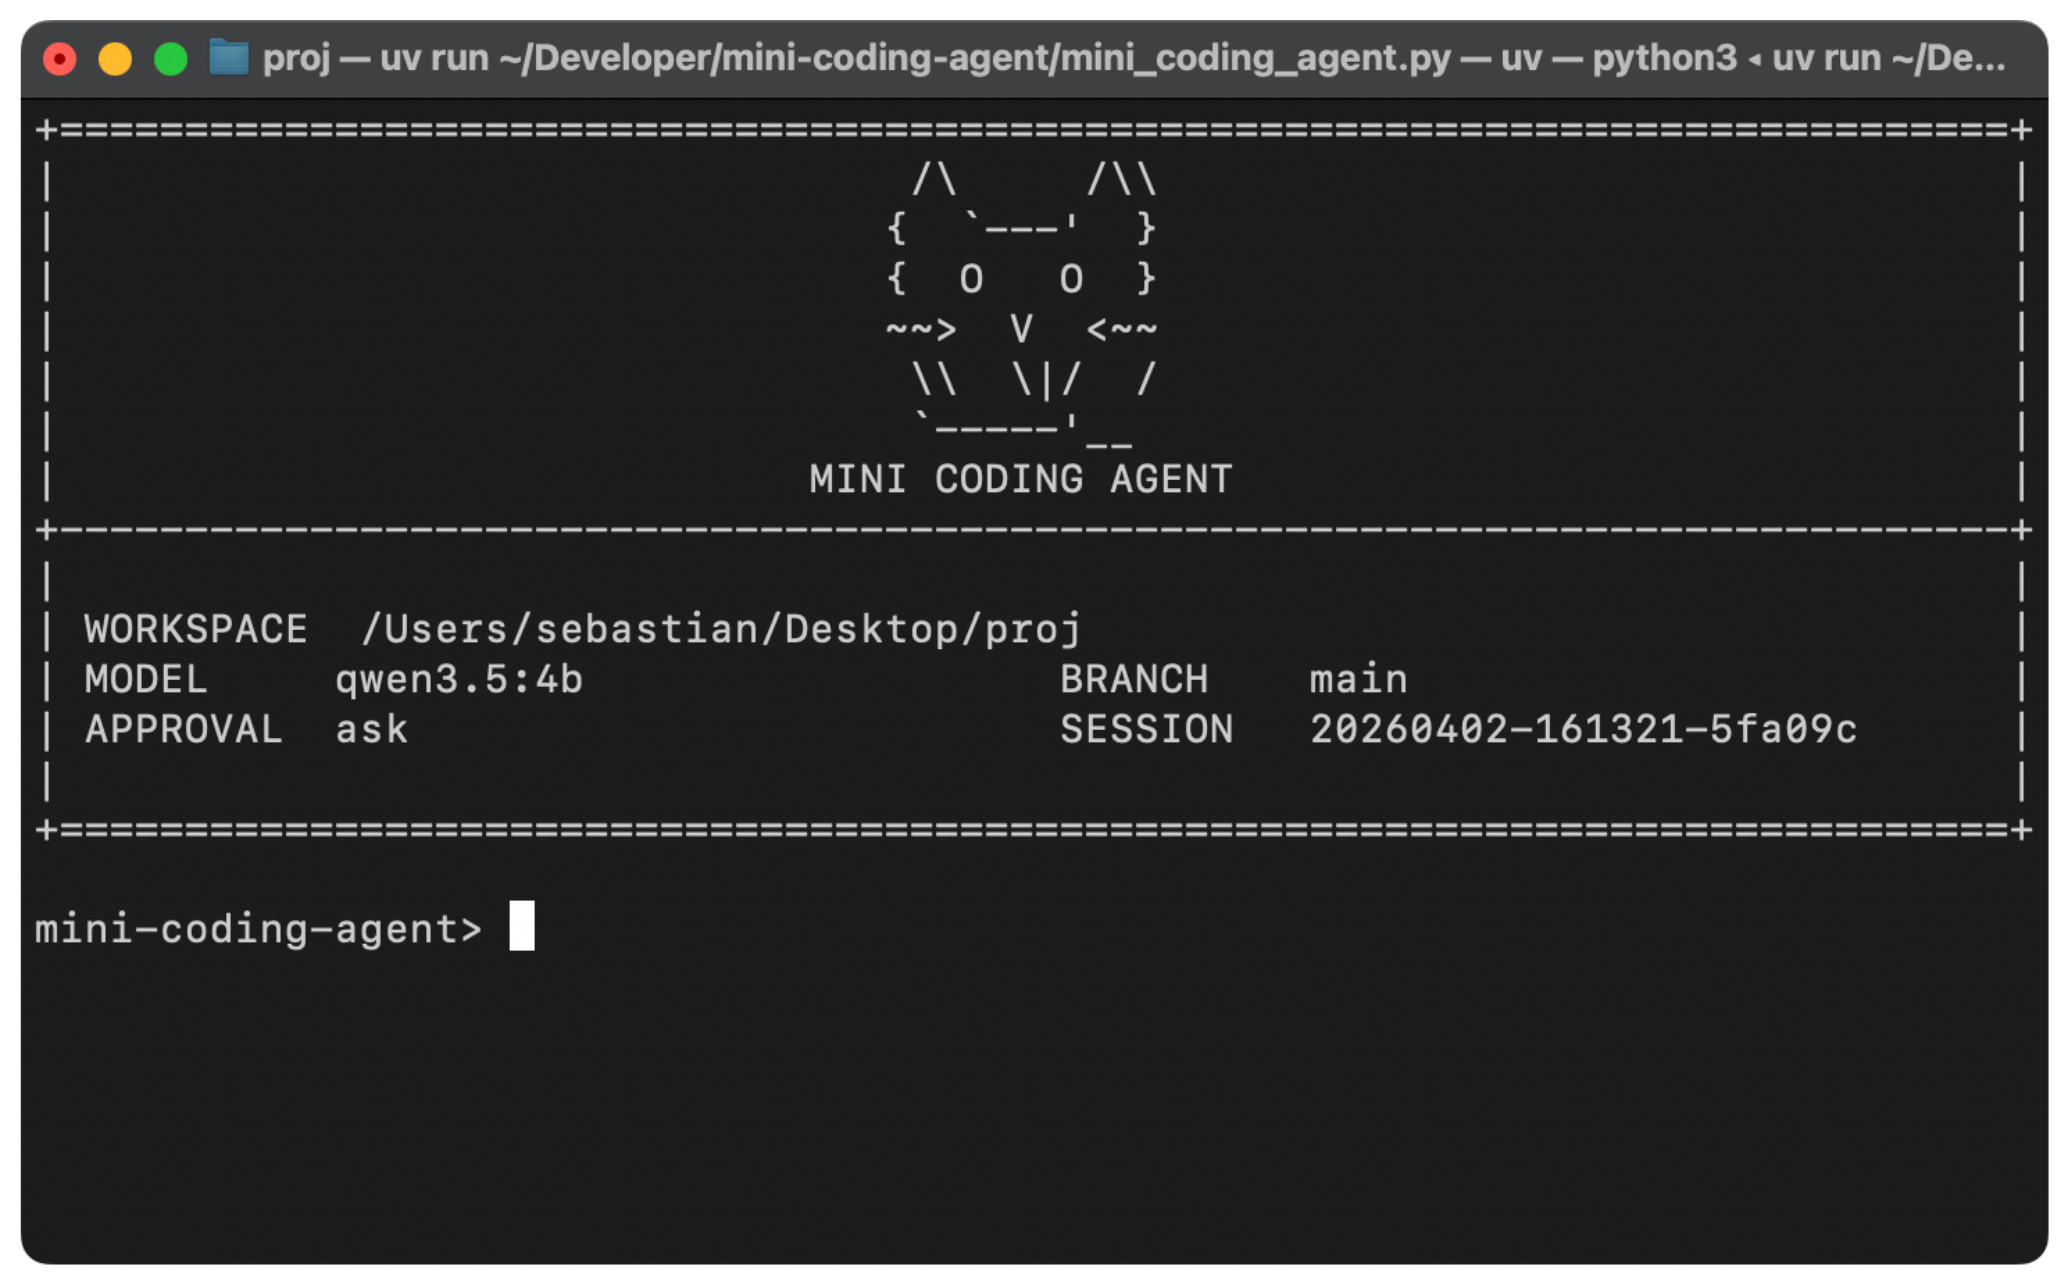 图 5:一个极简但功能完备的、用纯 Python 实现的 Mini Coding Agent。
1. 实时代码库上下文(Live Repo Context)
当用户提出“修复测试”或“实现 xyz”时,模型需要知道它当前所在的 Git 仓库、分支、以及哪些项目文档包含指令。Agent 在执行任何工作前会先收集这些信息(作为工作区摘要),这样就不会在每次提示时毫无背景地“从零开始”。
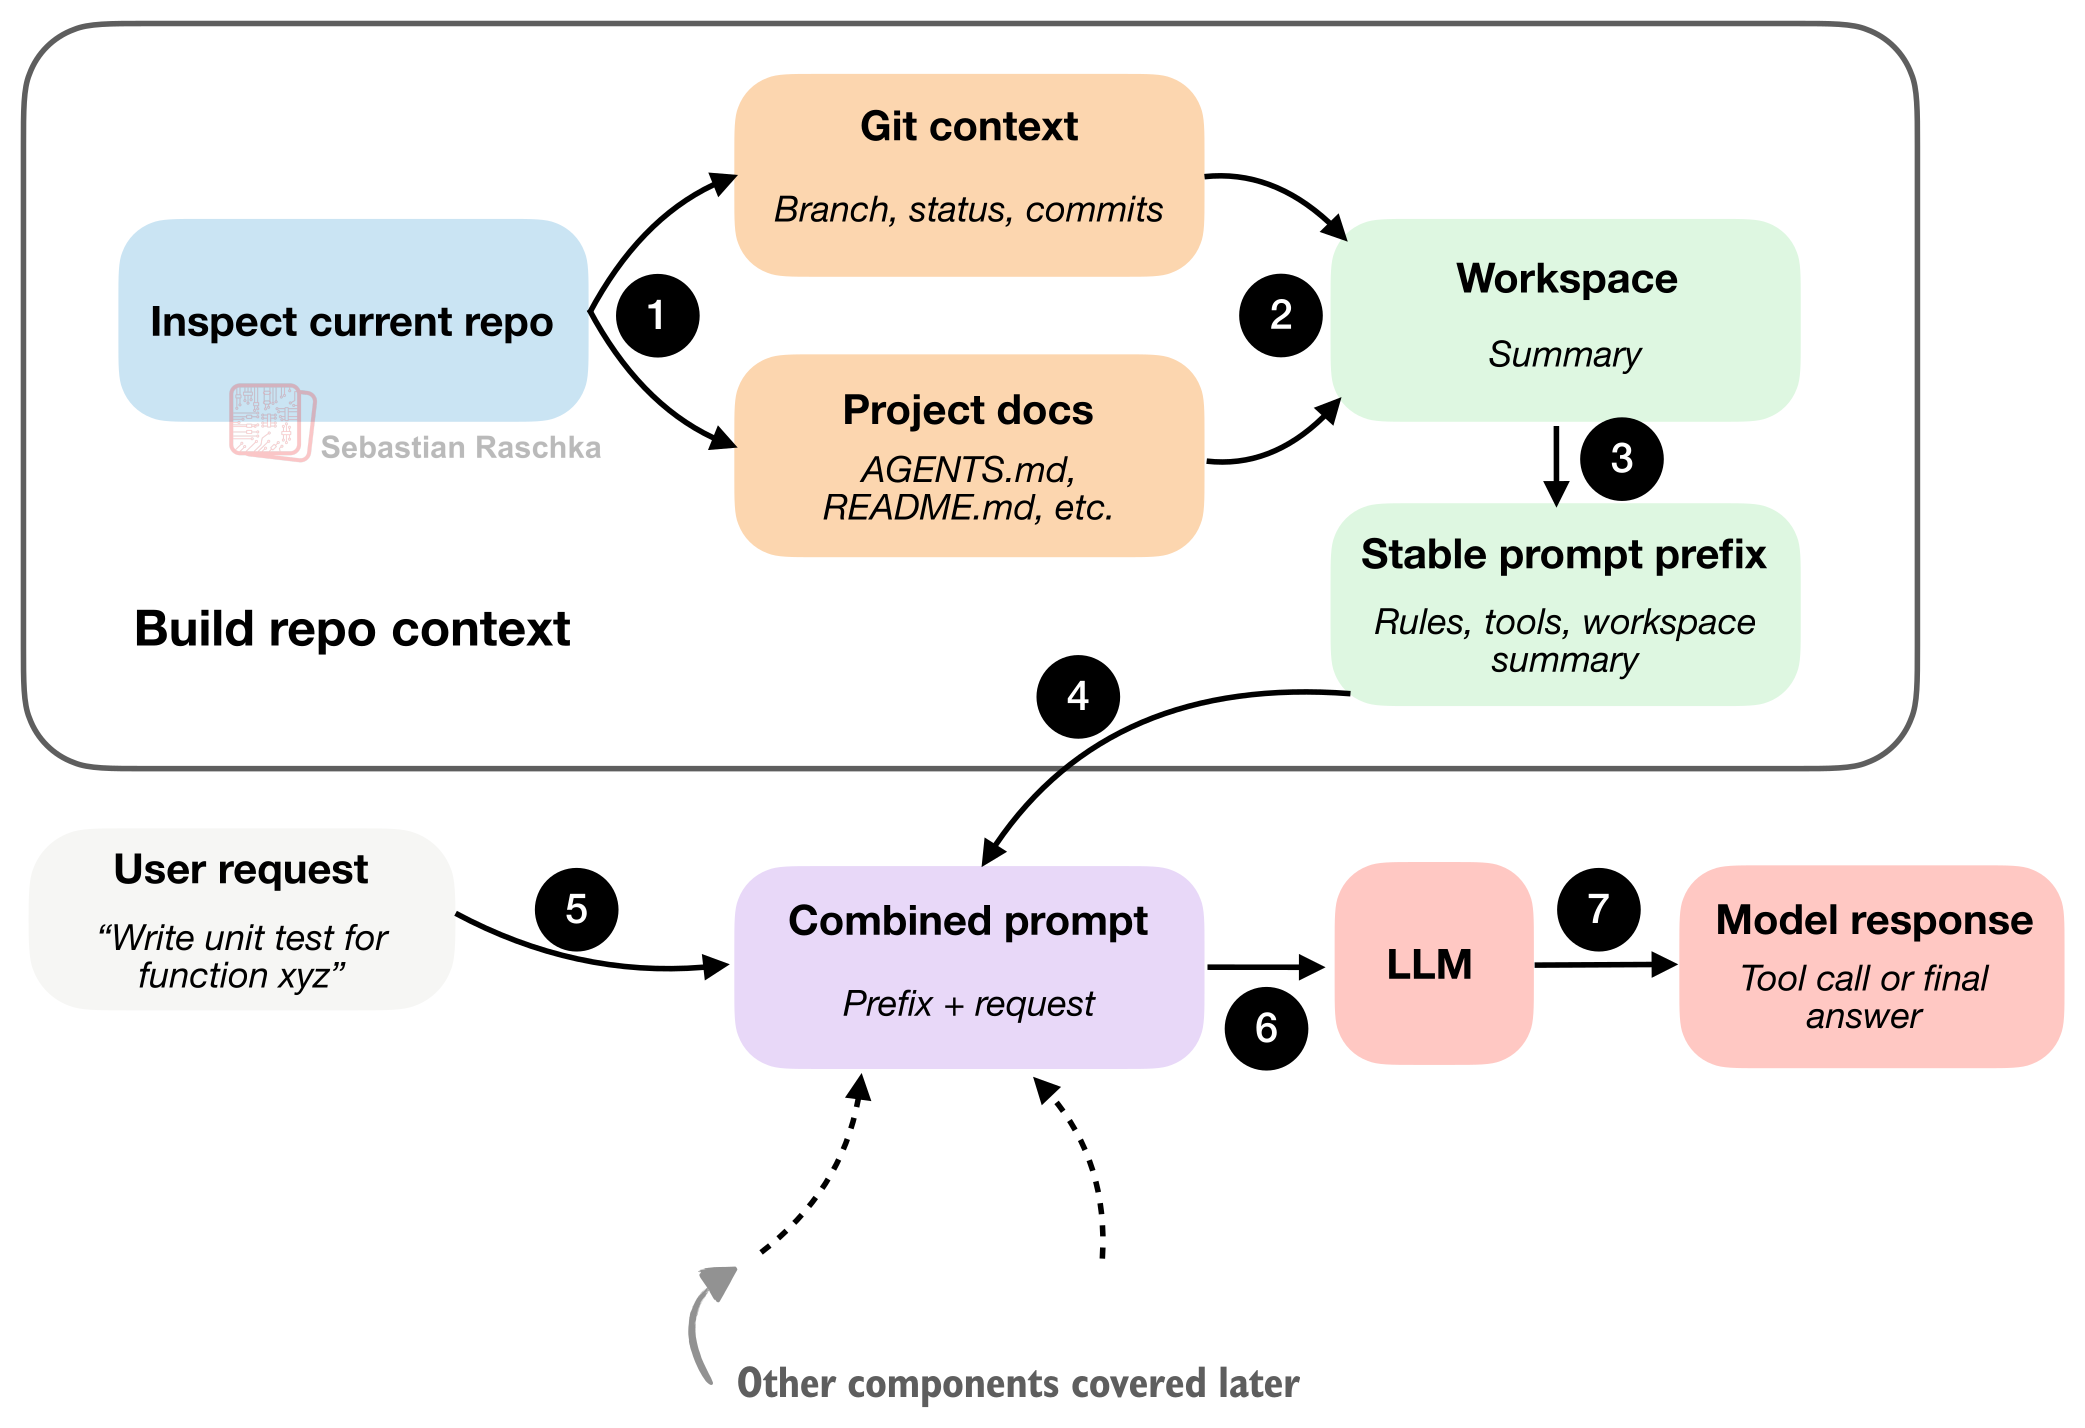 图 6:Agent 运行环境首先构建一个小型的工作区摘要,并将其与用户请求结合以提供额外的项目上下文。
2. 提示词结构与缓存复用(Prompt Shape And Cache Reuse)
编程会话通常是重复的,指令和工具描述很少改变。为了节省算力和上下文开销,智能的运行时系统会将这些“稳定的提示词前缀”(如通用指令、工具描述、工作区摘要)缓存并复用,而在每一轮交互中仅更新短期记忆、近期运行记录和最新的用户请求。
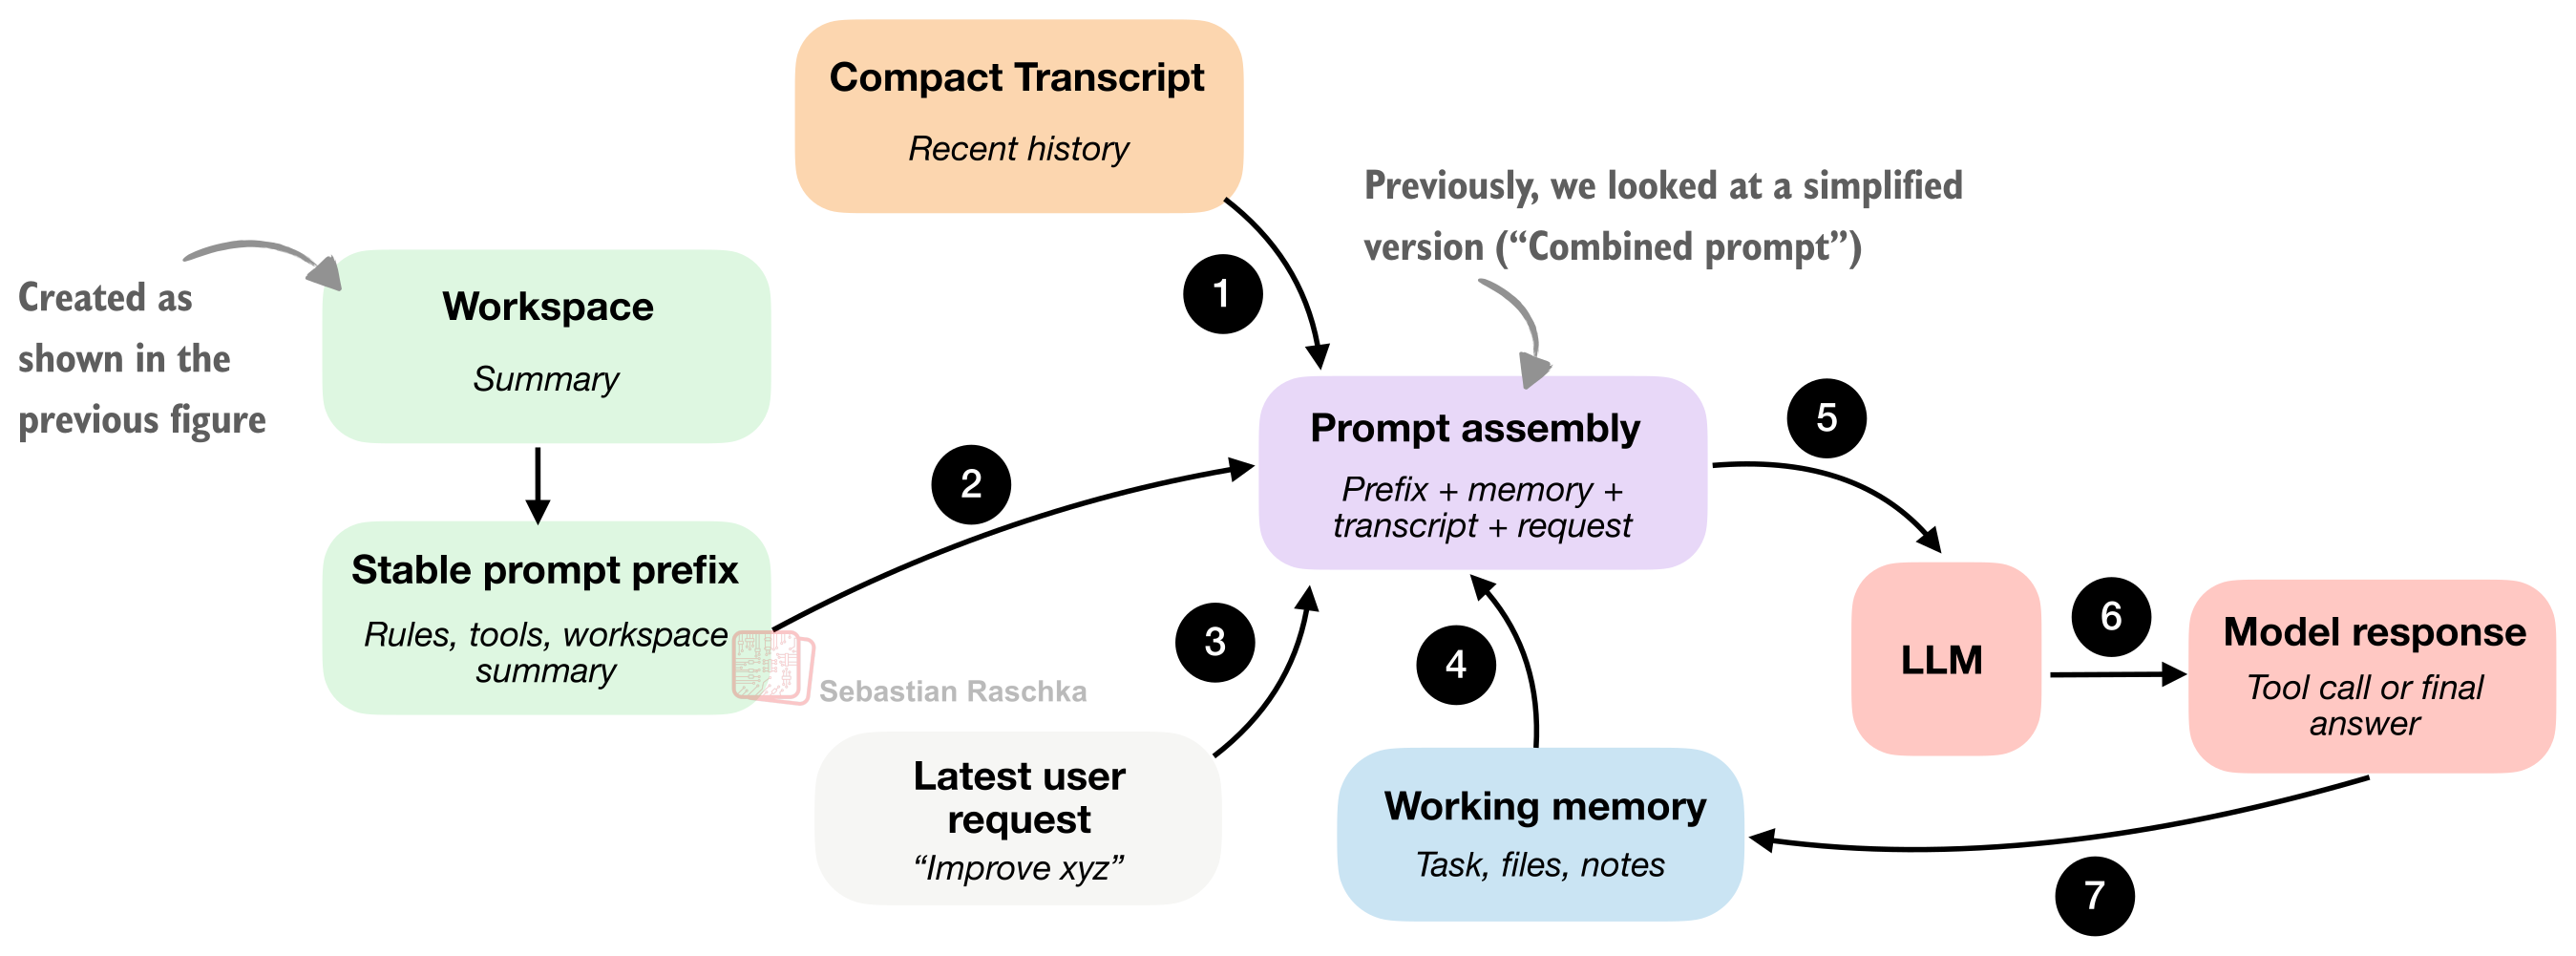 图 7:运行环境构建稳定的提示词前缀,加入不断变化的会话状态,然后将组合好的提示词反馈给模型。
3. 结构化工具、验证与权限(Structured Tools, Validation, And Permissions)
让模型真正拥有 Agent 能力的关键在于工具的调用。模型不应该输出任意散乱的代码,而是通过预先定义的、参数明确的结构化工具来执行动作(如列出文件、搜索、运行 Shell 命令等)。
当模型请求执行动作时,运行时会拦截并验证:
- “这是一个已知的工具吗?”
- “参数有效吗?”
- “需要用户批准吗?”
- “请求的路径是否在工作区内?”
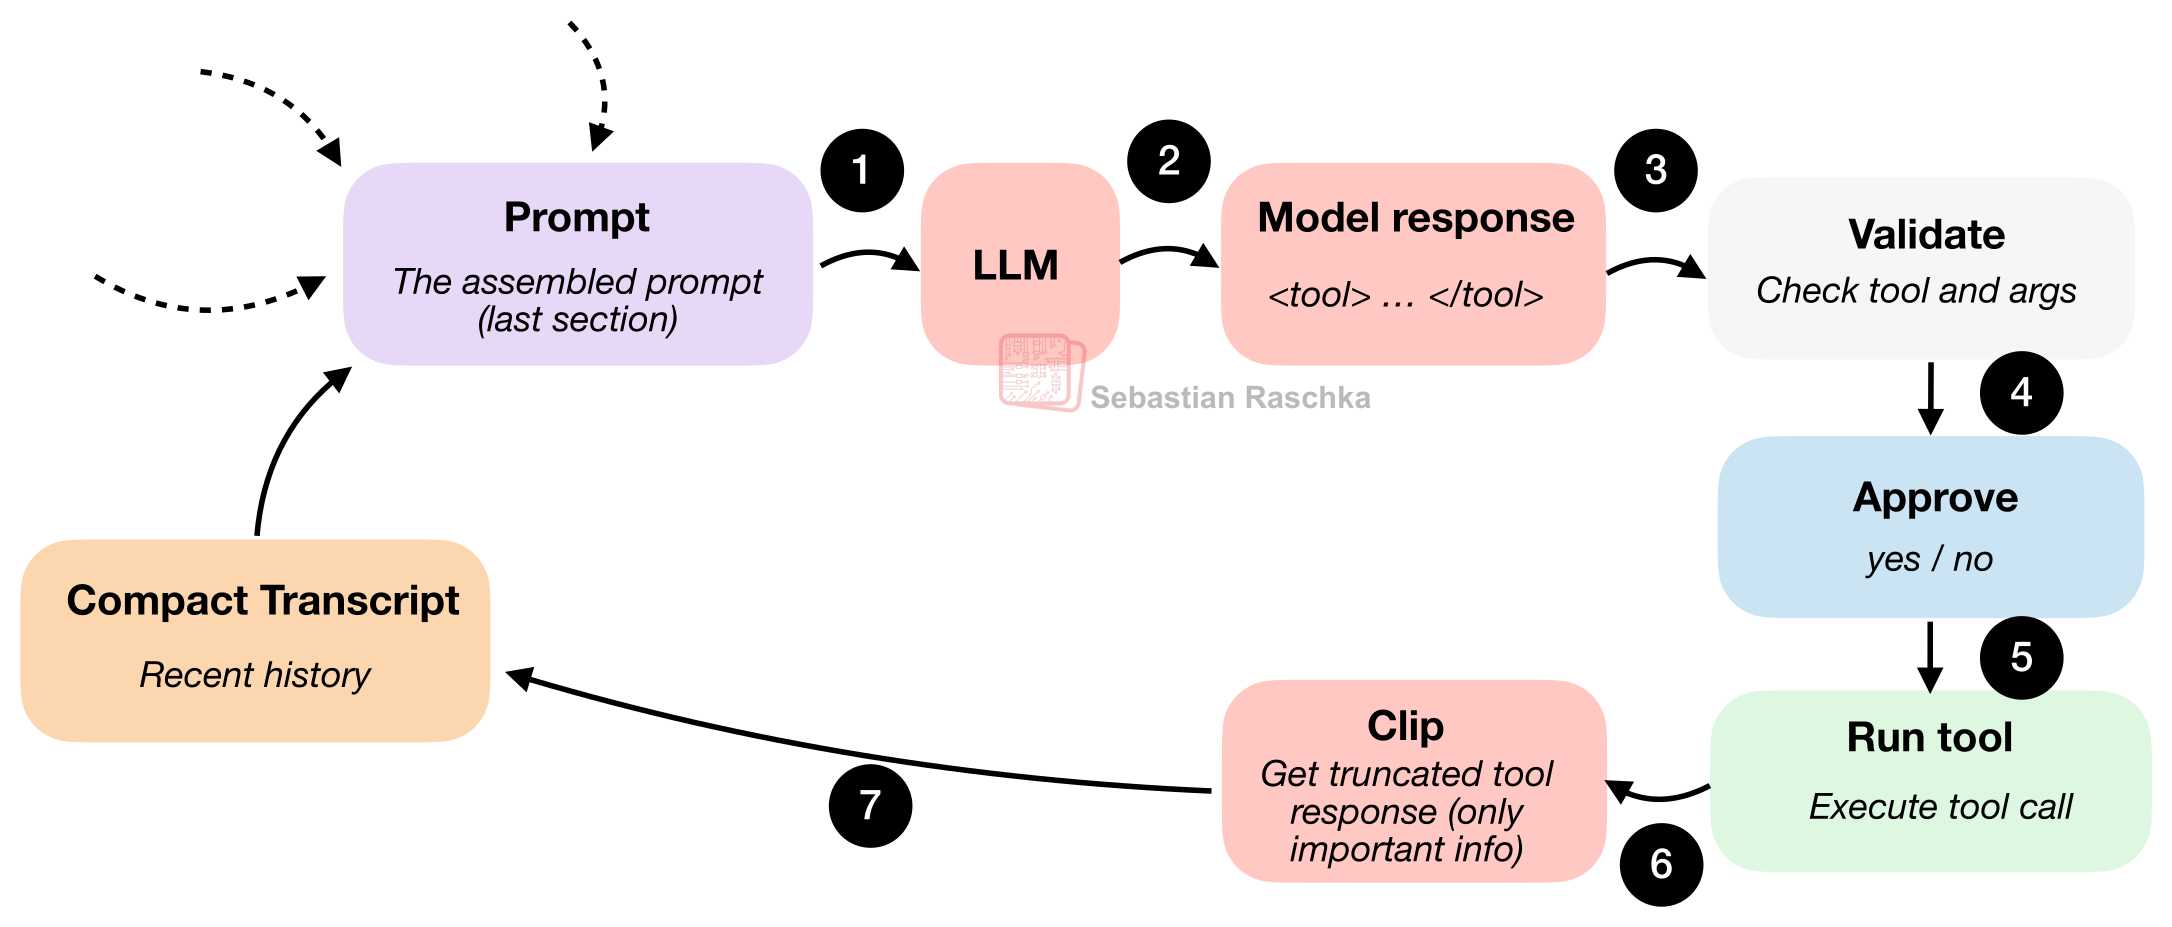 图 8:模型输出一个结构化动作,运行环境进行验证,可选地要求审批,然后执行并将结果反馈到循环中。
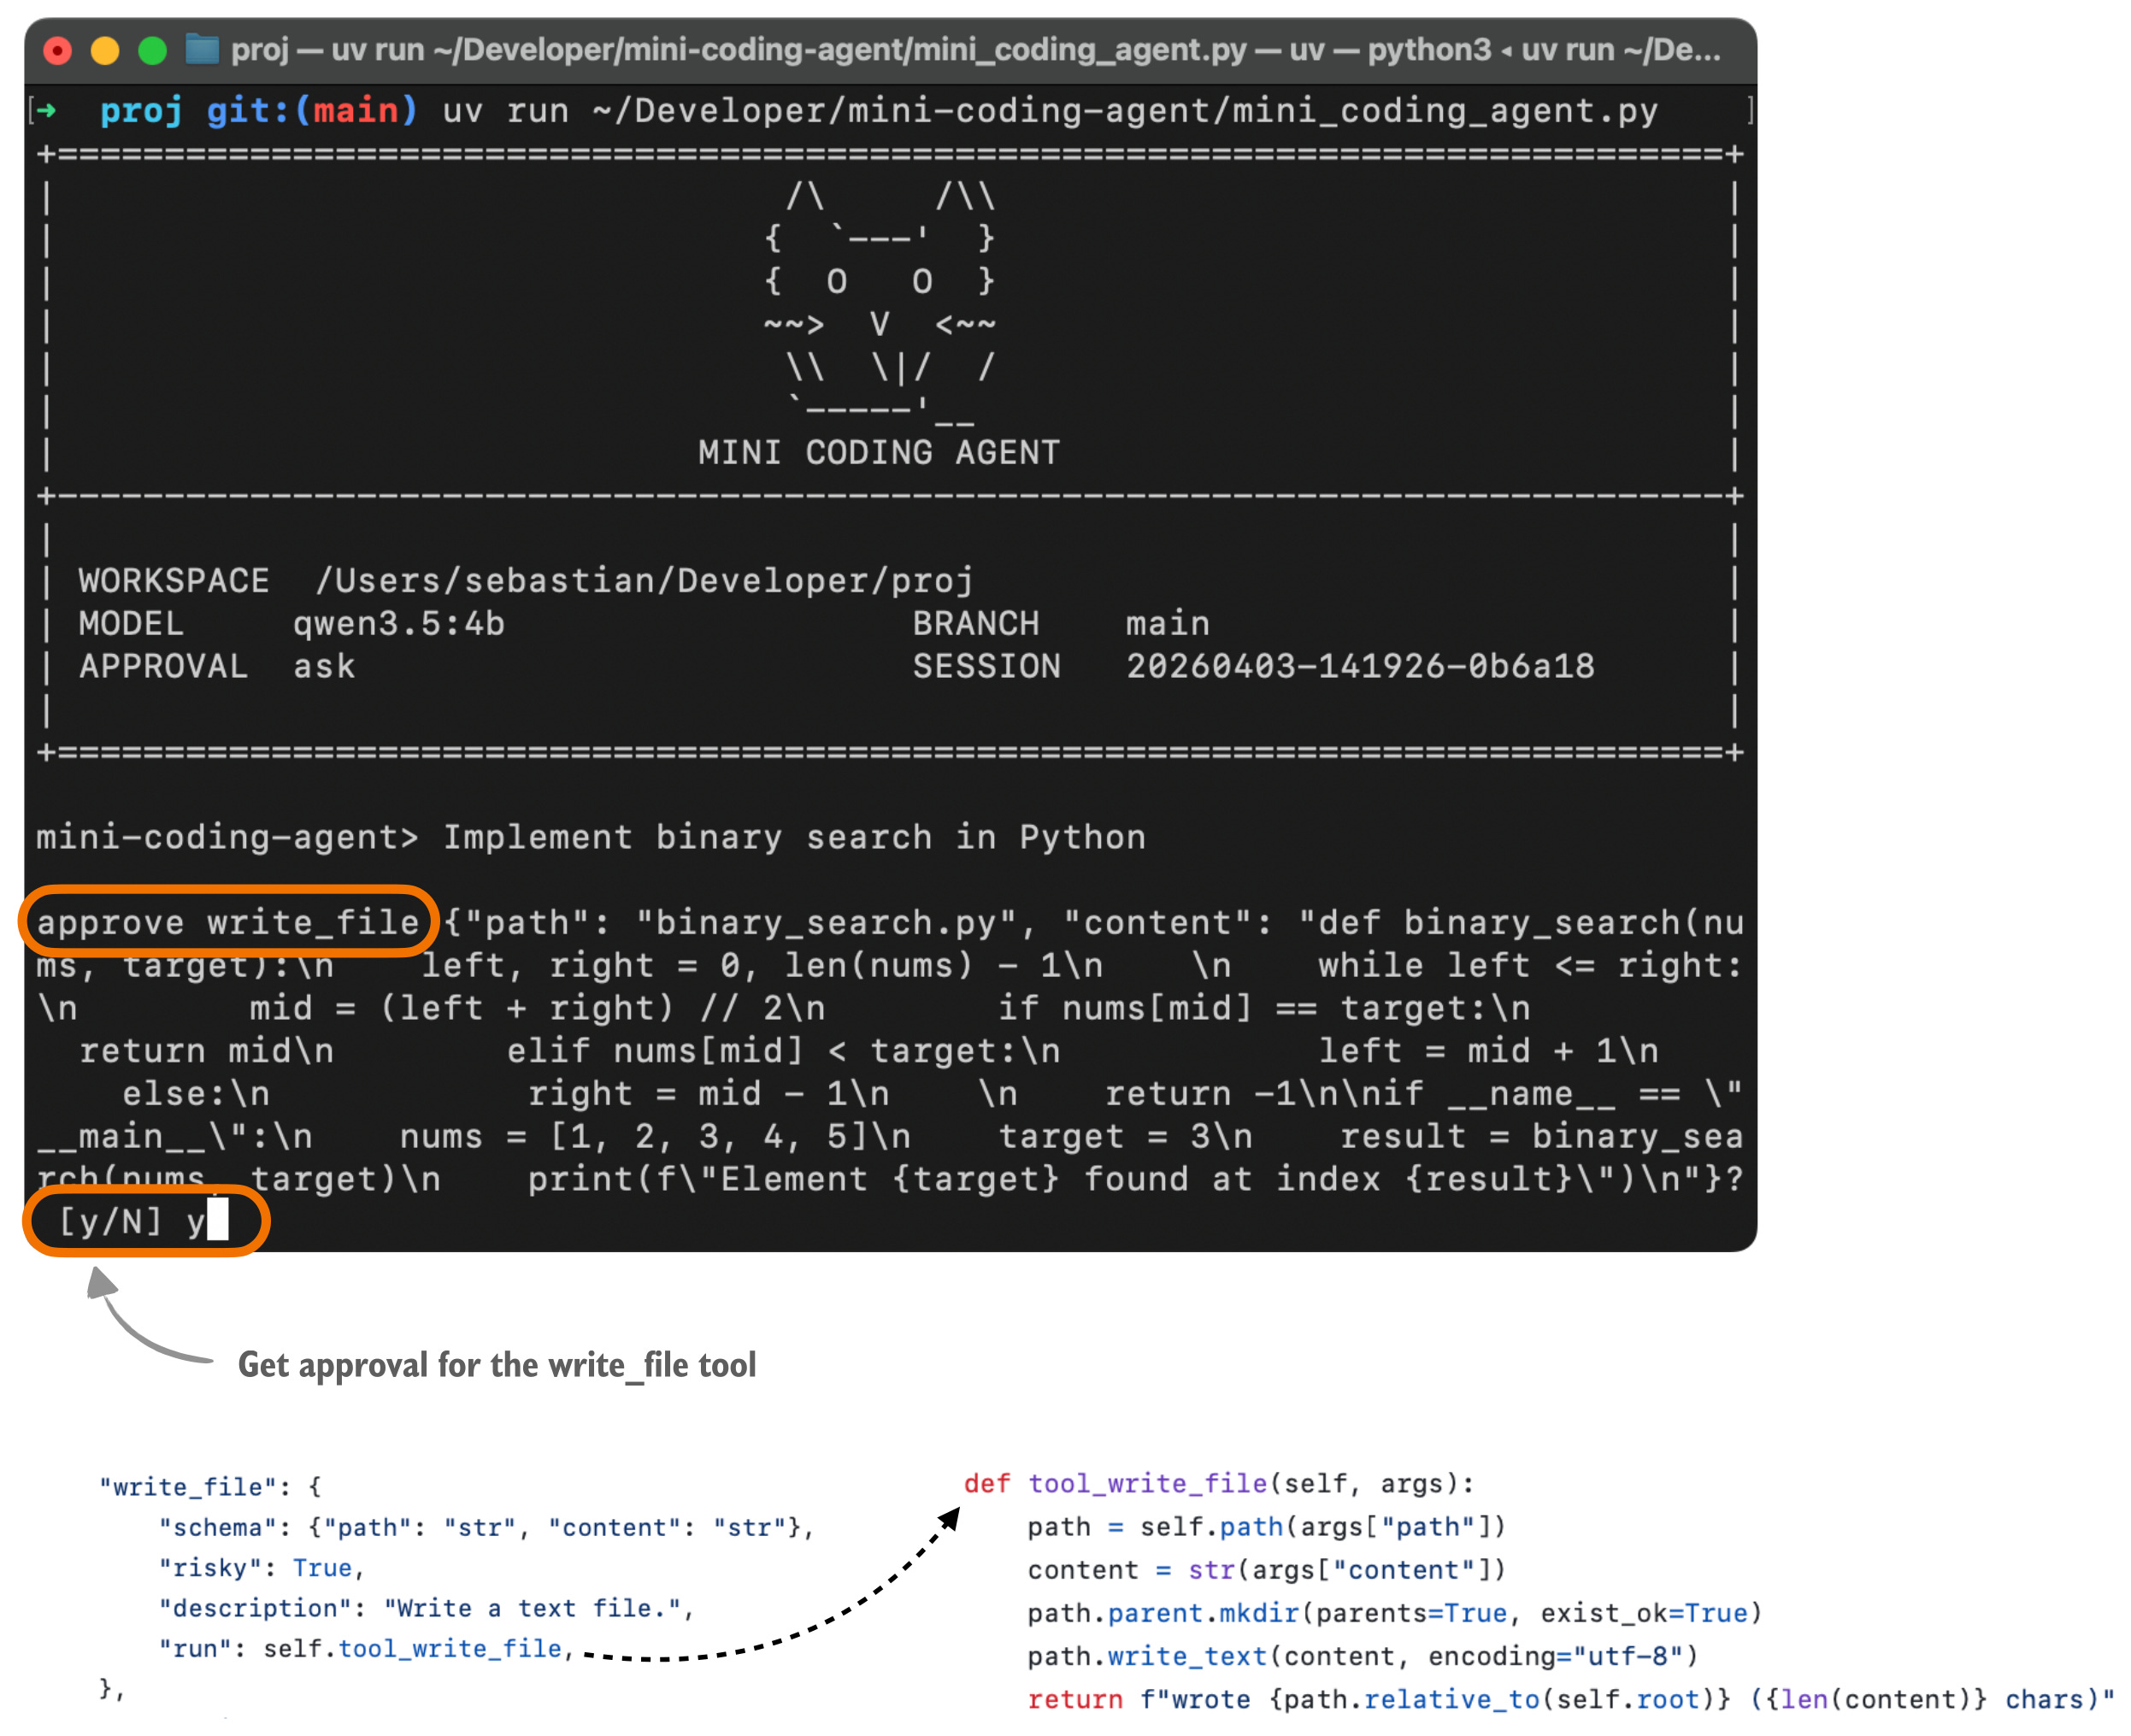 图 9:Mini Coding Agent 中请求工具调用批准的示例。
4. 上下文压缩与输出管理(Context Reduction And Output Management)
上下文膨胀是所有多轮交互 LLM 都要面临的痛点。代码 Agent 通过两种主要策略来处理:
- 裁剪(Clipping):截断长文档、冗长的工具输出等,防止其耗尽 token 预算。
- 记录降维(Transcript Reduction):保留最新交互的丰富细节,对旧的历史记录进行大力压缩和去重。
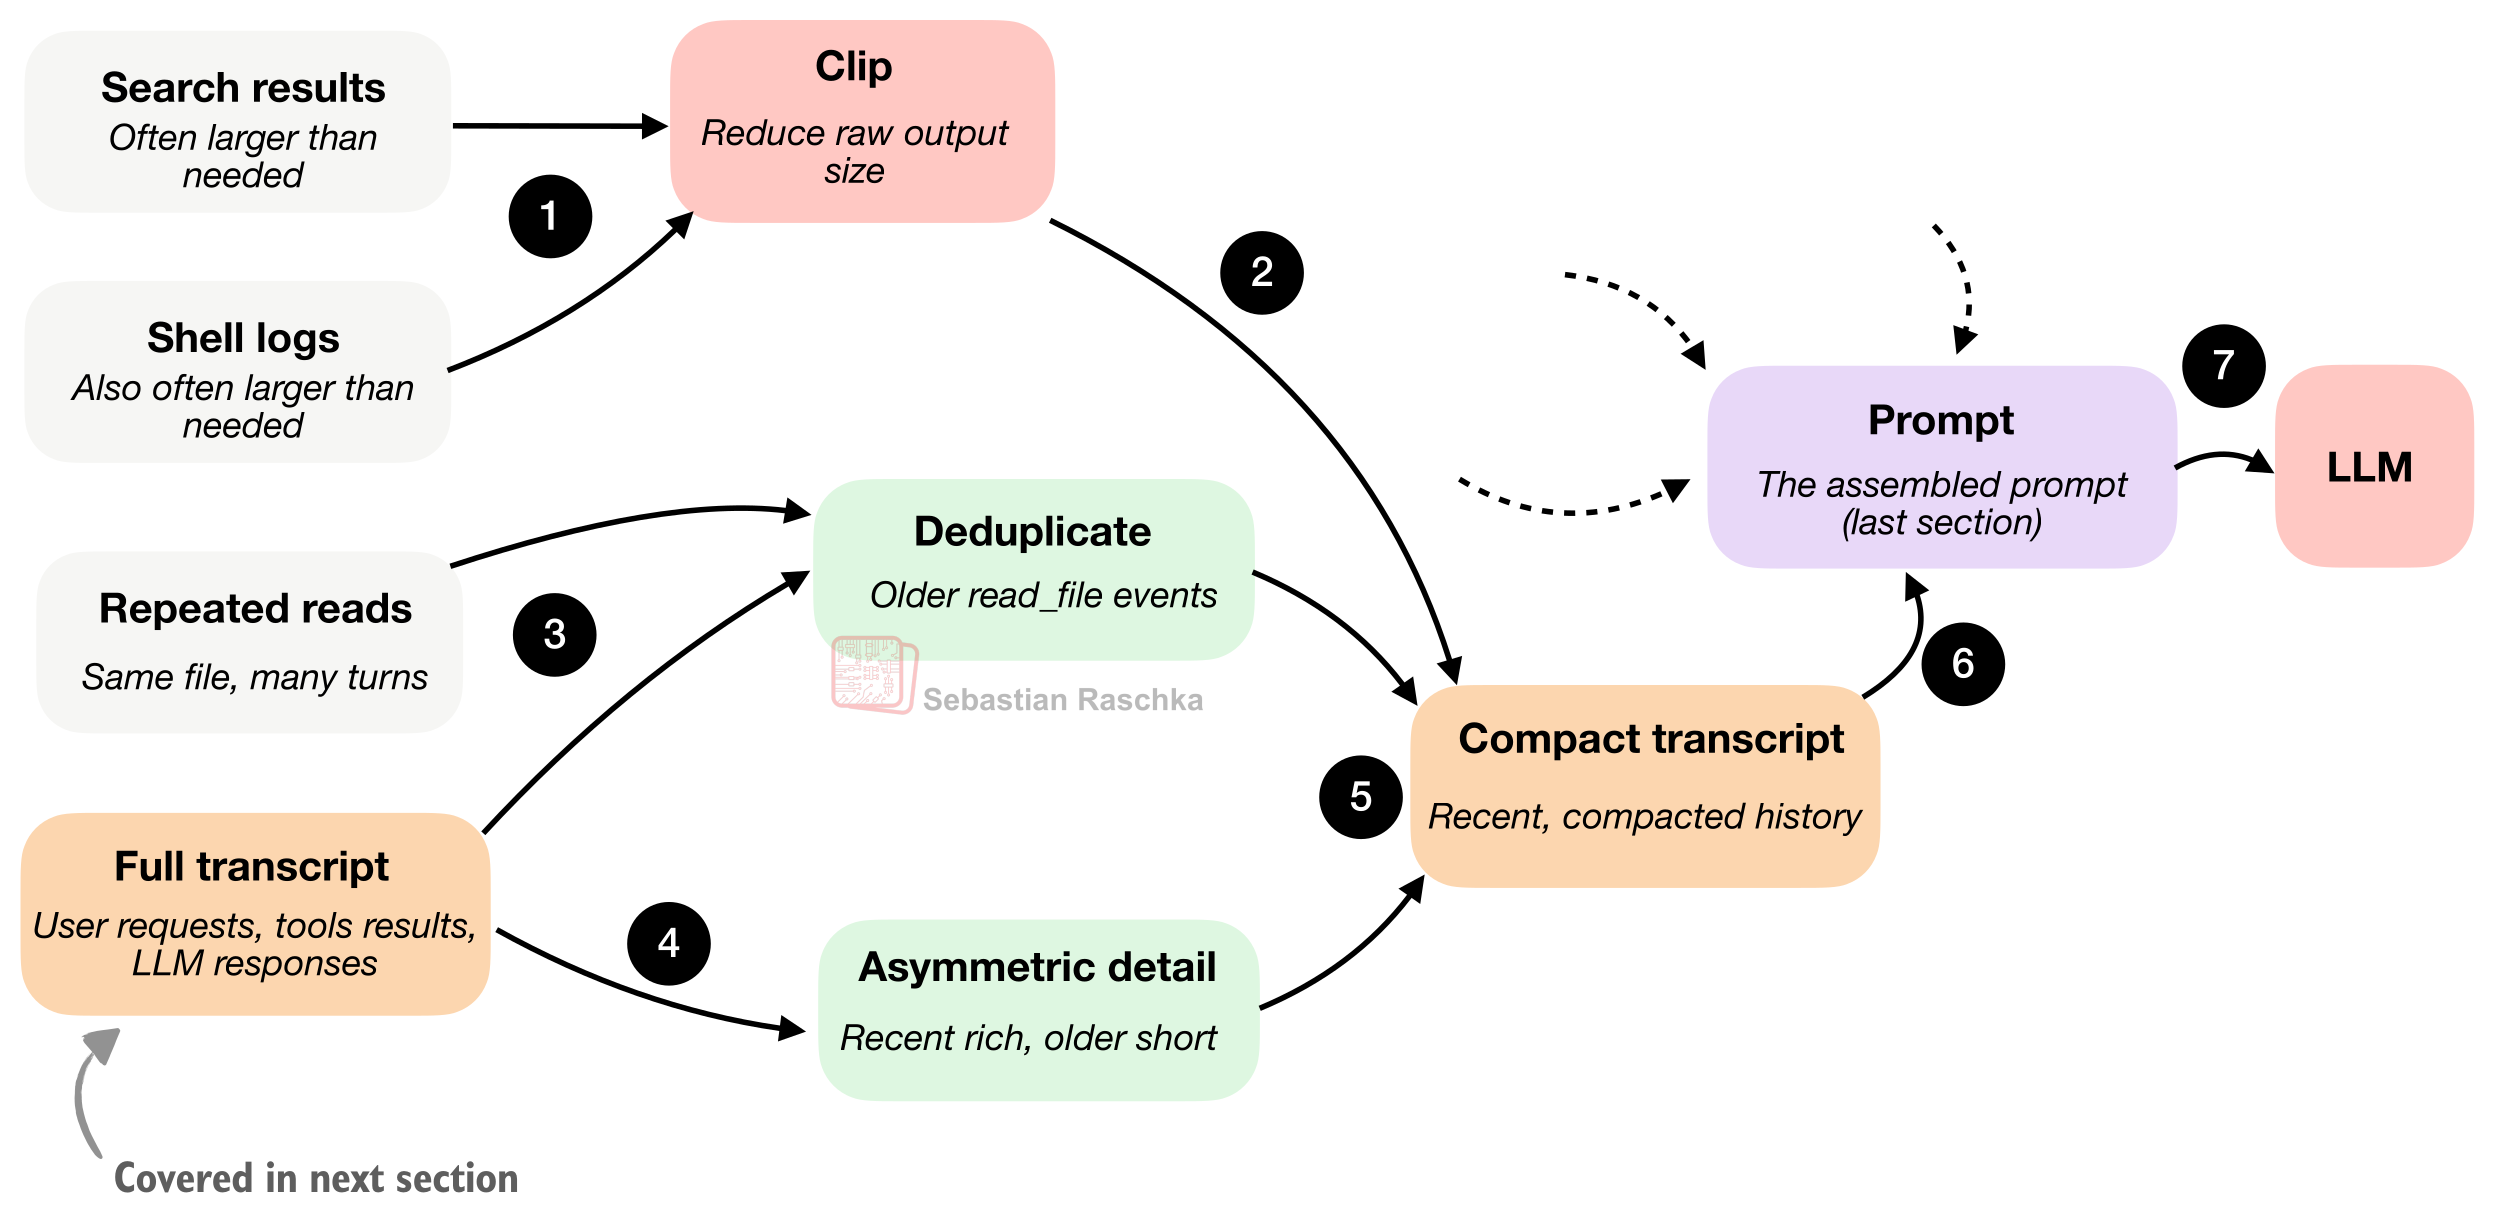 图 10:裁剪大型输出,对旧的读取进行去重,并在将其放回提示词之前对运行记录进行压缩。
5. 运行记录、记忆与状态恢复(Transcripts, Memory, And Resumption)
代码 Agent 的状态被分为两个层次:
- 工作记忆(Working Memory):这是显式维护的、简化的核心摘要(如当前任务、重要文件)。
- 完整运行记录(Full Transcript):包含所有用户请求、工具输出和模型响应的完整历史,通常作为 JSON 存在磁盘中,支持会话的暂停与恢复。
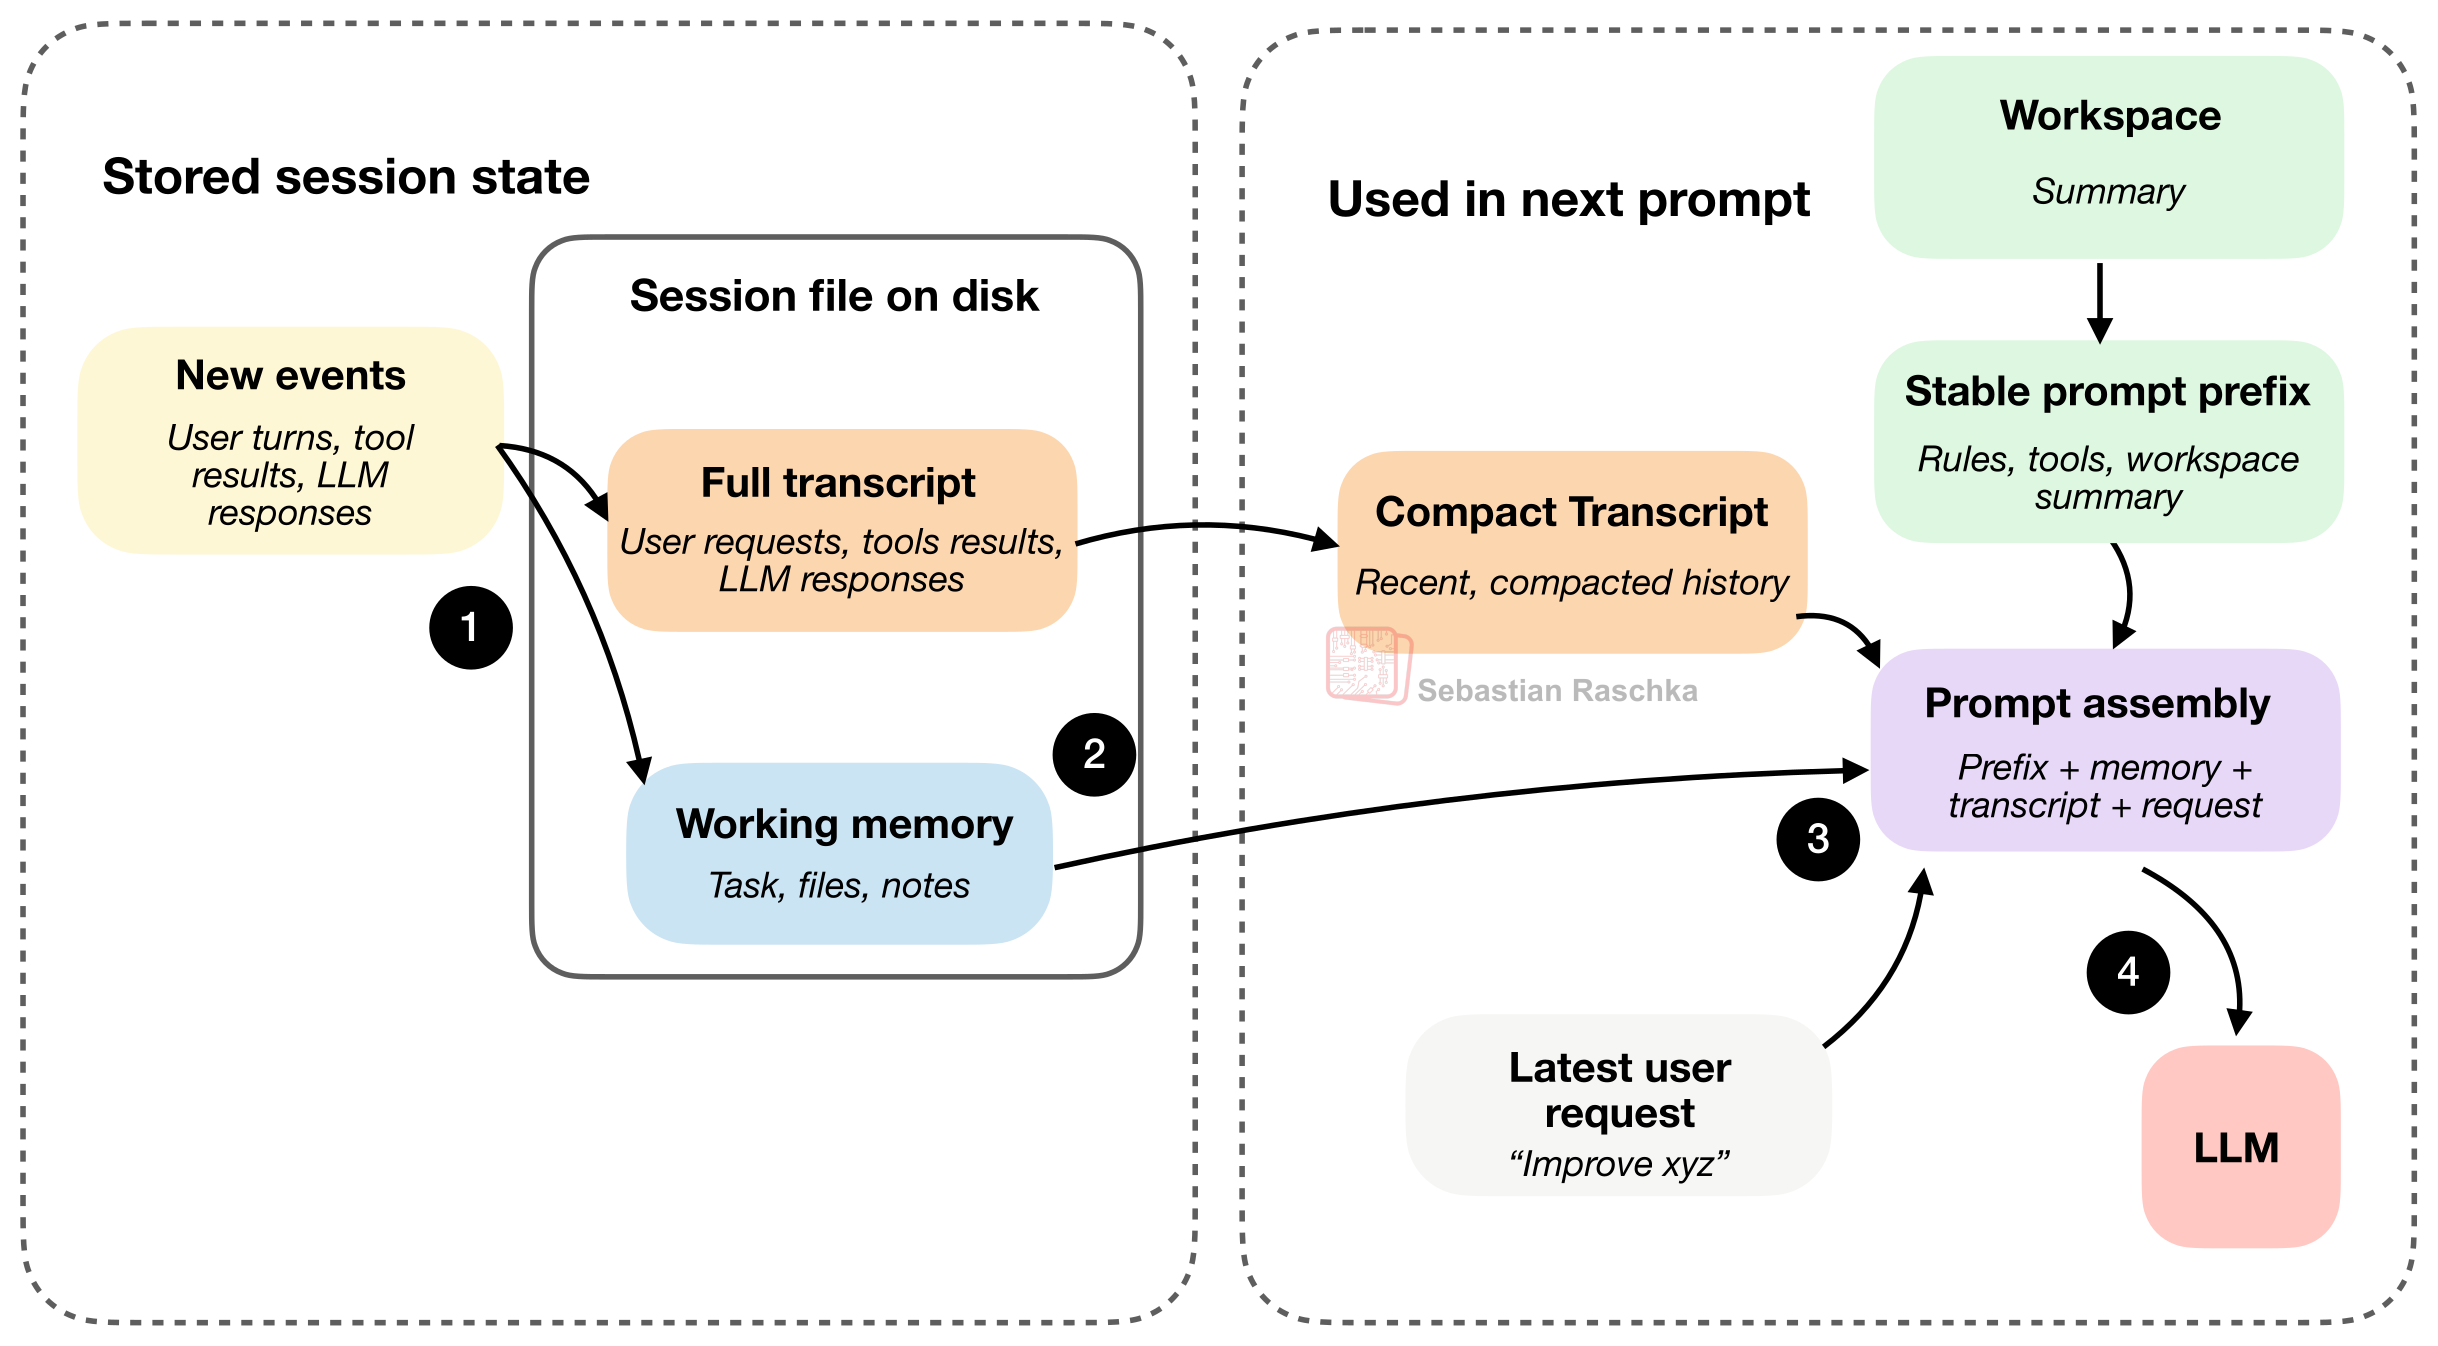 图 11:新事件会被追加到完整运行记录中,并在工作记忆中进行摘要,通常存储为 JSON 文件。
6. 任务委派与受限子代理(Delegation And Bounded Subagents)
为了提高执行效率,主 Agent 可以在处理主要任务的同时,生成子代理(Subagents)来并行处理分支任务(如查阅文档或诊断测试错误)。关键在于如何约束子代理的作用域,防止它们错误修改文件或陷入无限递归。
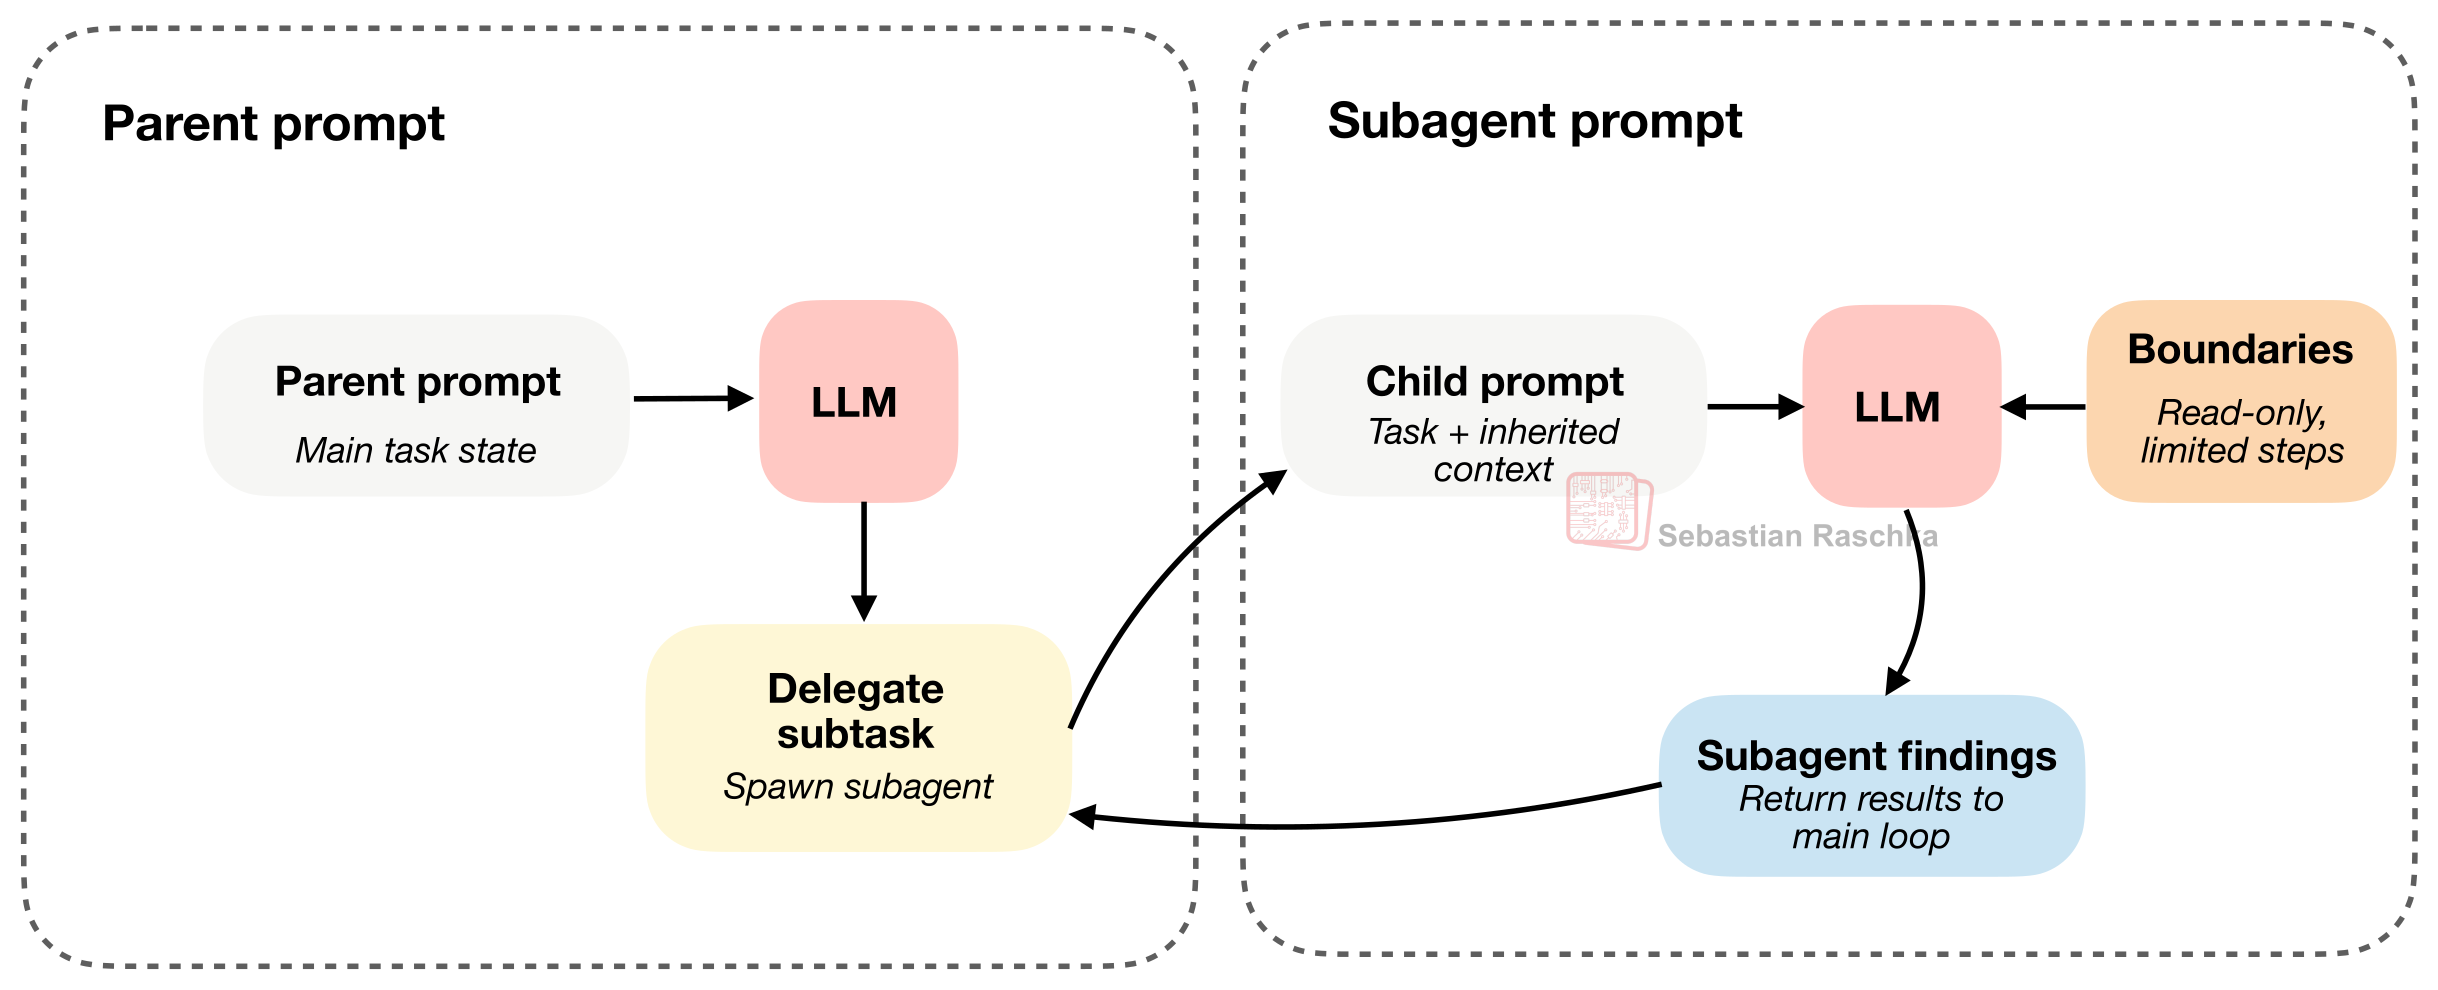 图 12:子代理继承足够的上下文来执行任务,但在比主代理更严格的边界内运行。
总结
以上六个核心组件紧密交织,共同构成了一个强大的代码辅助环境。这些组件的存在,正是为什么专门的代码运行环境能使 LLM 发挥出远超简单多轮对话形式的能力。
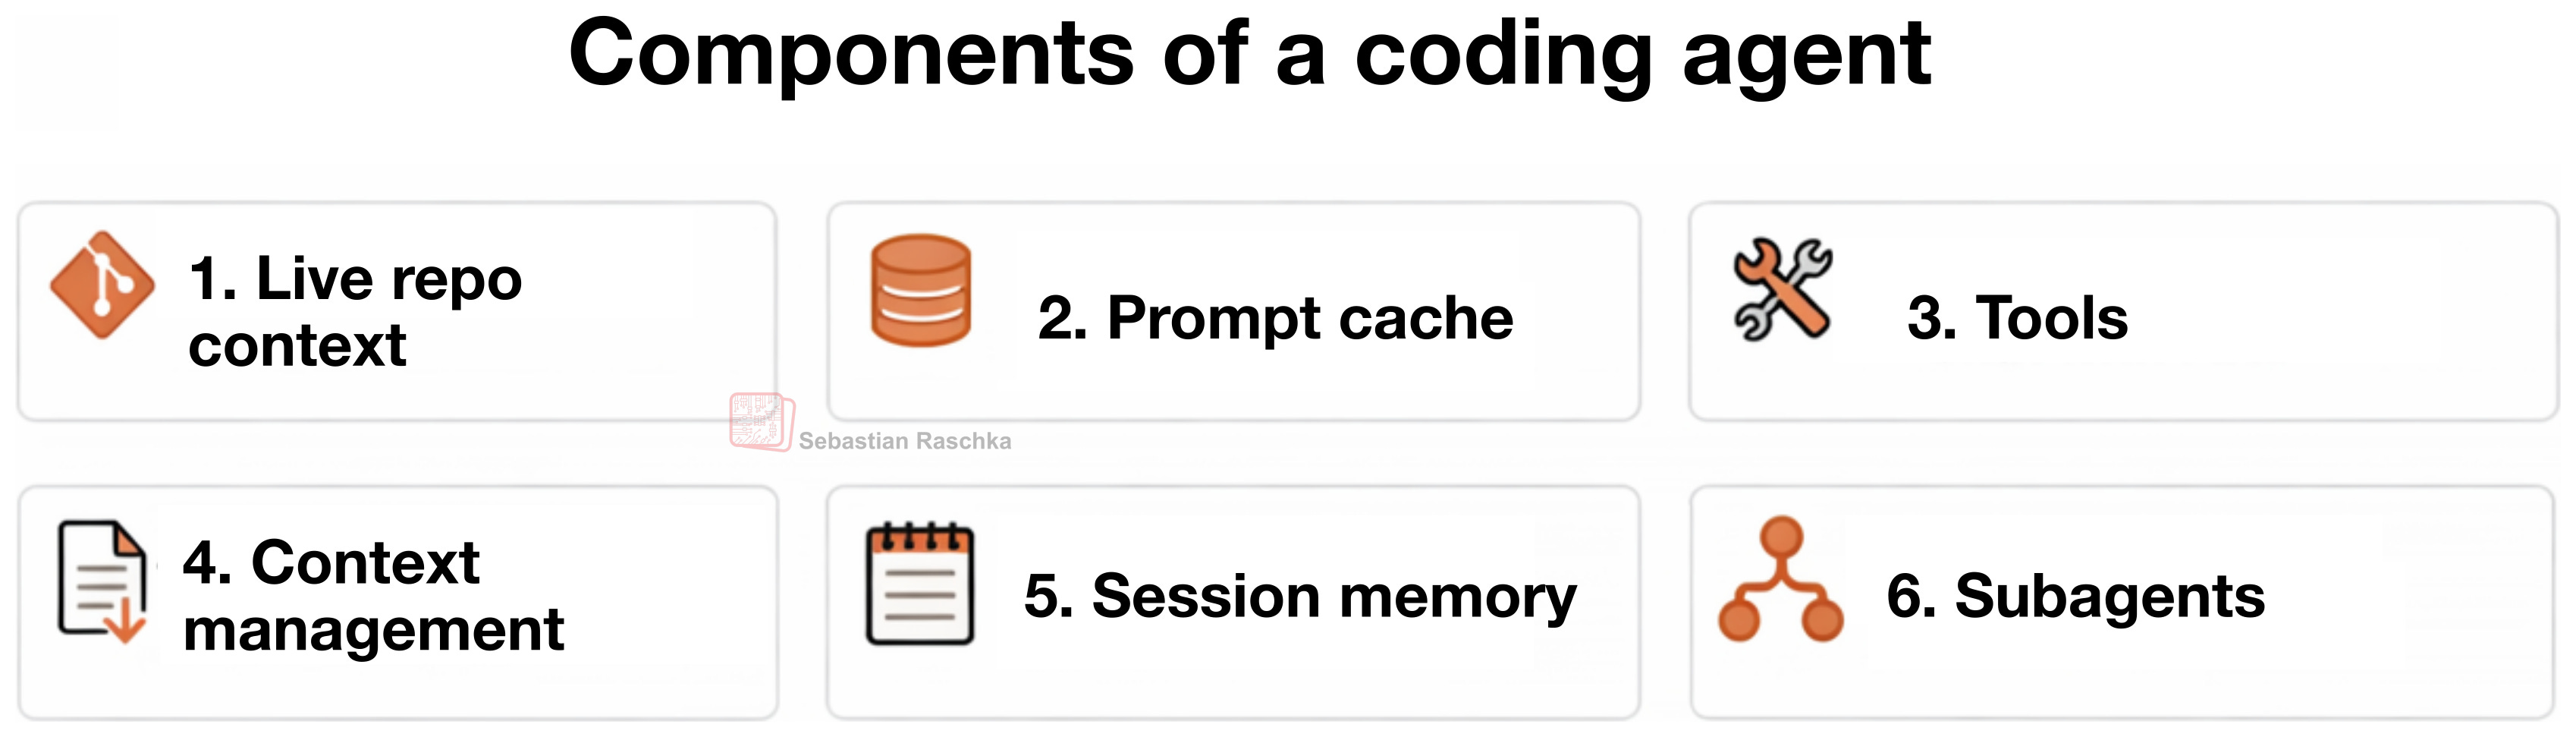 图 13:本文讨论的代码运行环境的六个主要特性。
正如作者所言,构建这些组件需要精心设计,甚至还涉及诸如对大型项目的代码拆解、调试等复杂的系统工程。而这也正是构建未来更加智能的 AI 软件工程师的必经之路。
🔗 原文链接:Components of A Coding Agent