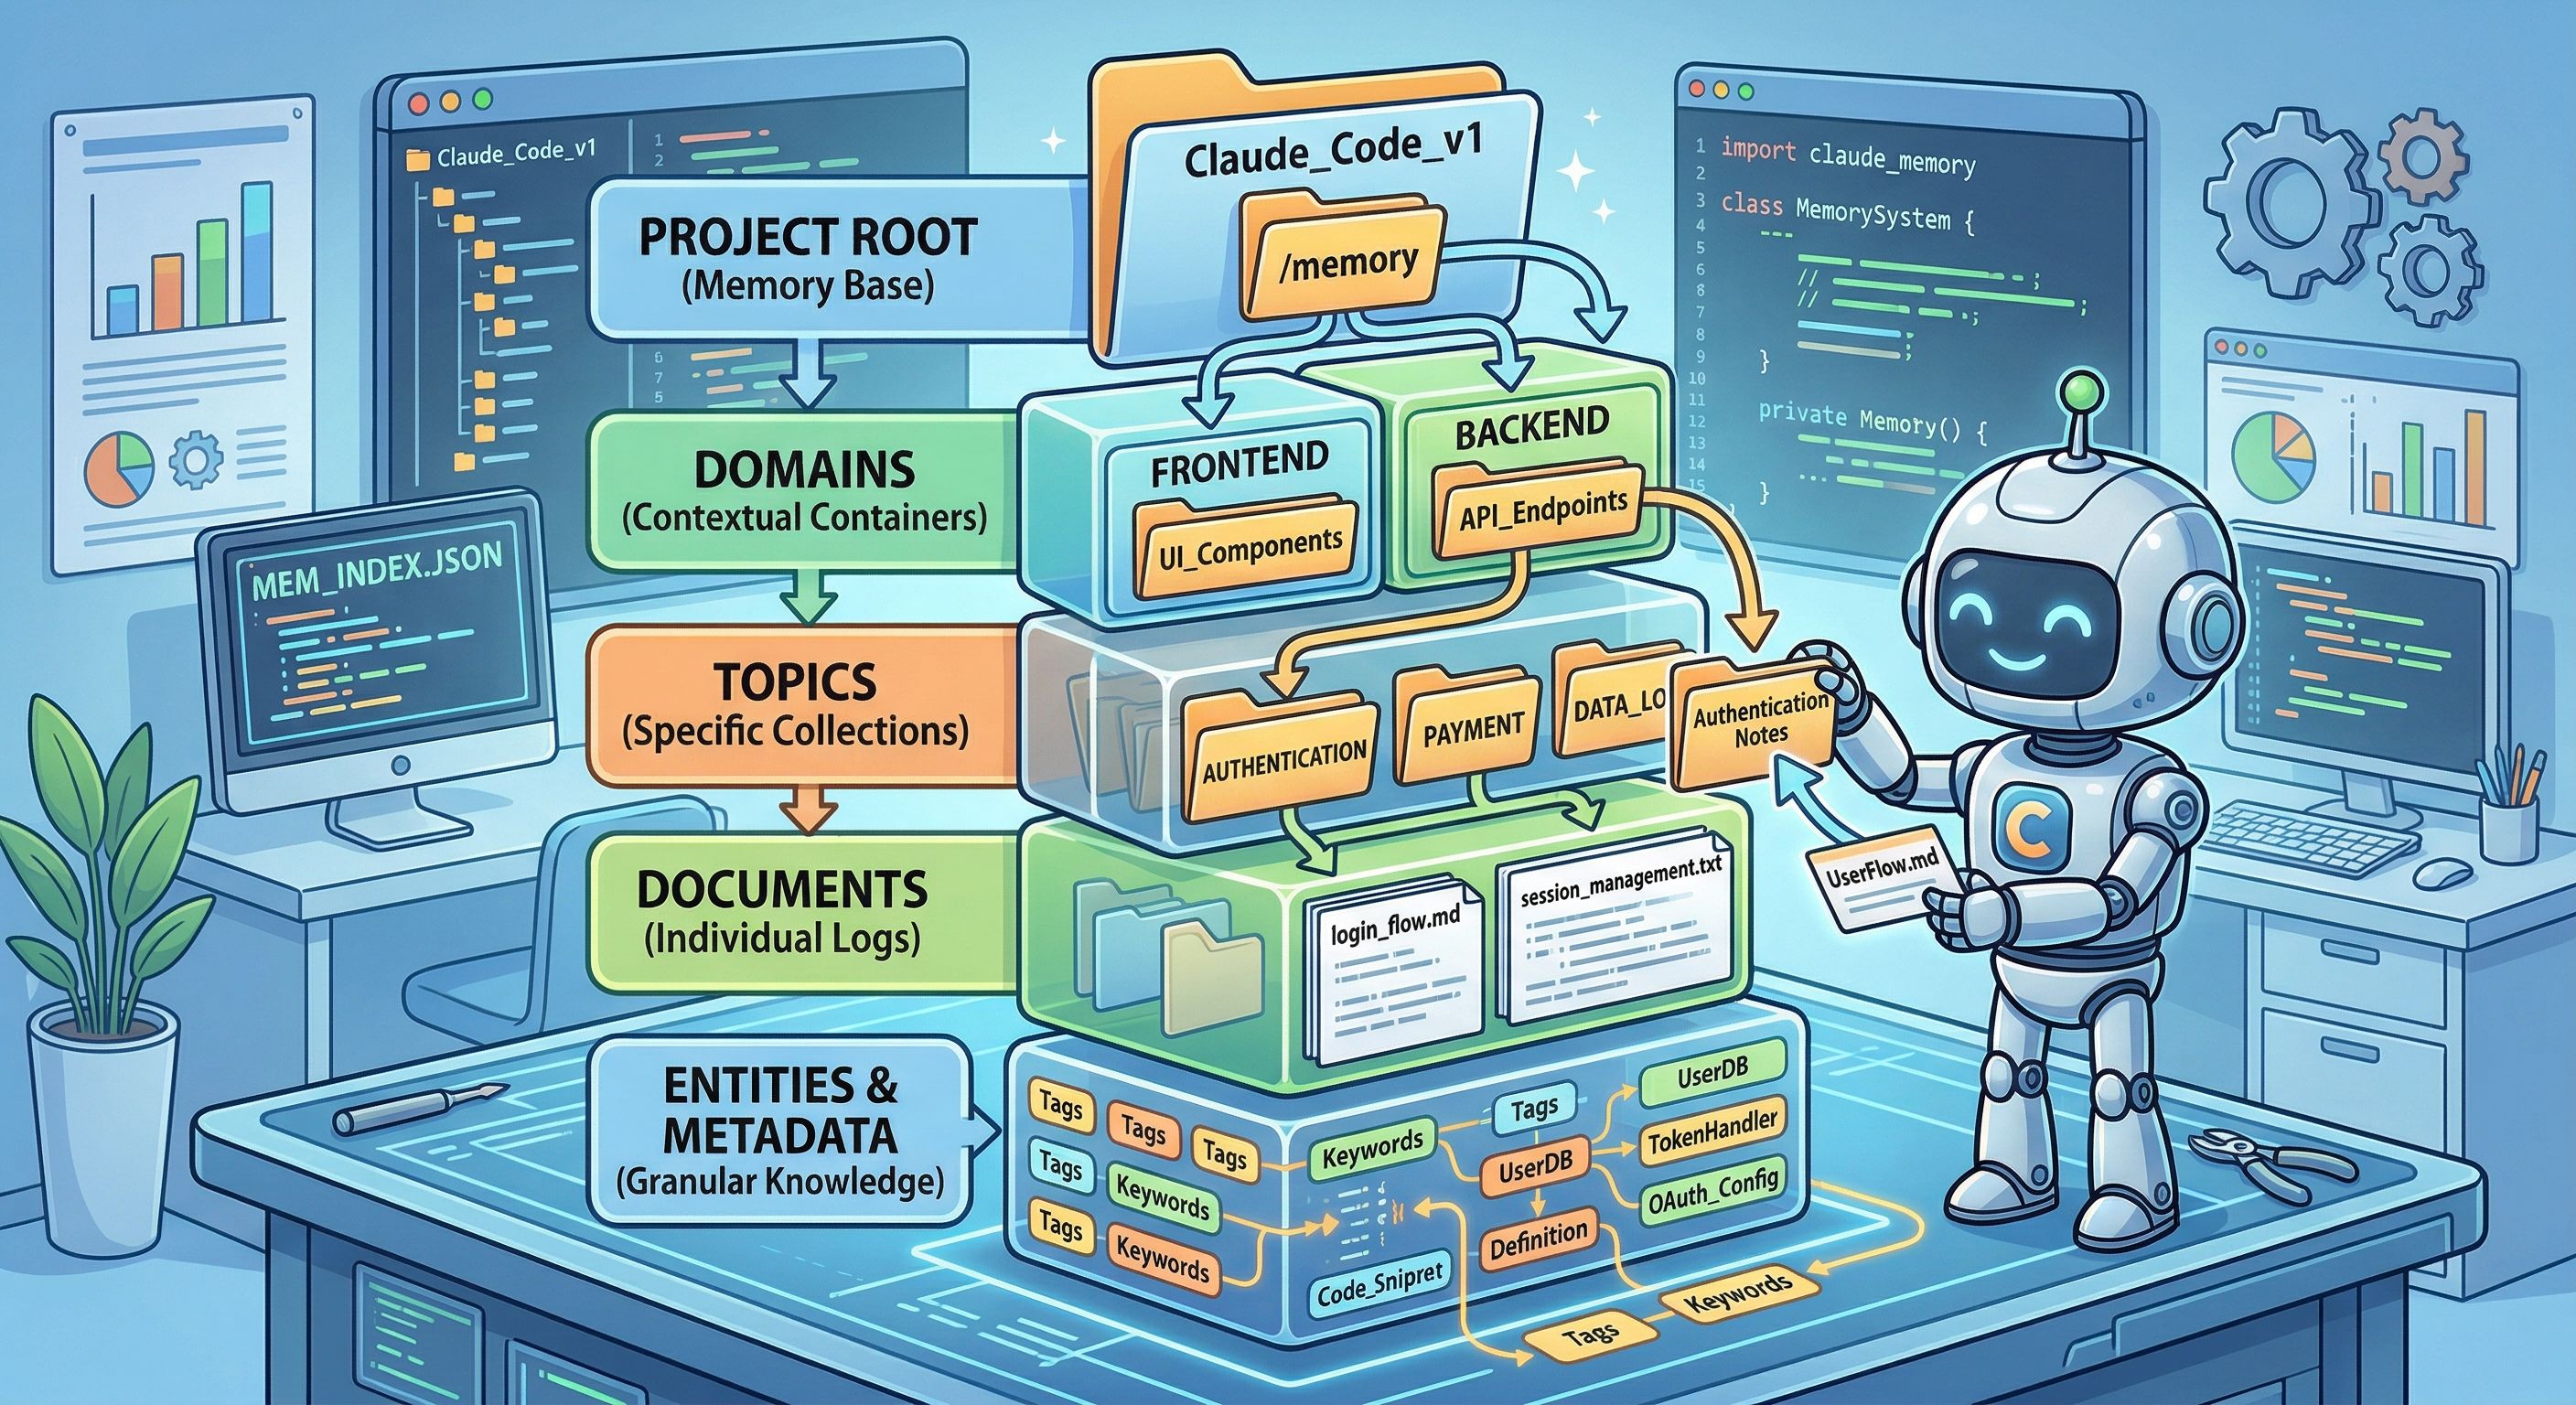
Claude Code 的记忆系统架构解析
快速阅读
Claude Code 拥有一个精心设计的五层记忆系统,而非简单地“记住所有内容”。这五层分别是:
- 对话历史(Conversation history):每次对话中用户和 Claude 交互的 JSONL 记录。
- 会话记忆(Session memory):后台 Agent 动态构建的 Markdown 结构化记忆,用于防止上下文窗口超出限制。
- CLAUDE.md:人类可控的全局和项目级偏好文件。
- 自动记忆(Auto-memory):Claude 跨会话学习用户偏好的核心模块,保存在
~/.claude/projects/<slug>/memory/。 - 团队记忆(Team memory):用于团队级共享的上下文信息。
本文重点探讨了“自动记忆”的管理方式:包括按轮次提取信息的后台 Forked Agent、周期性通过 autoDream 功能合并与修剪记忆、以及由 Sonnet 驱动的高效非阻塞式记忆检索流程。Claude Code 在兼顾效率和安全性的前提下,完美示范了如何构建一个有约束的强大 Agent 记忆模块。
最近 @himanshustwts 和 @Hesamation 深入研究了 Claude Code 泄露的源代码,揭开了其记忆系统的全貌。因为记忆是决定 Agent(智能体)身份和表现的关键部分,了解 Claude 如何追踪用户偏好、管理并筛选记忆,对我们设计和使用 AI Agent 都大有裨益。
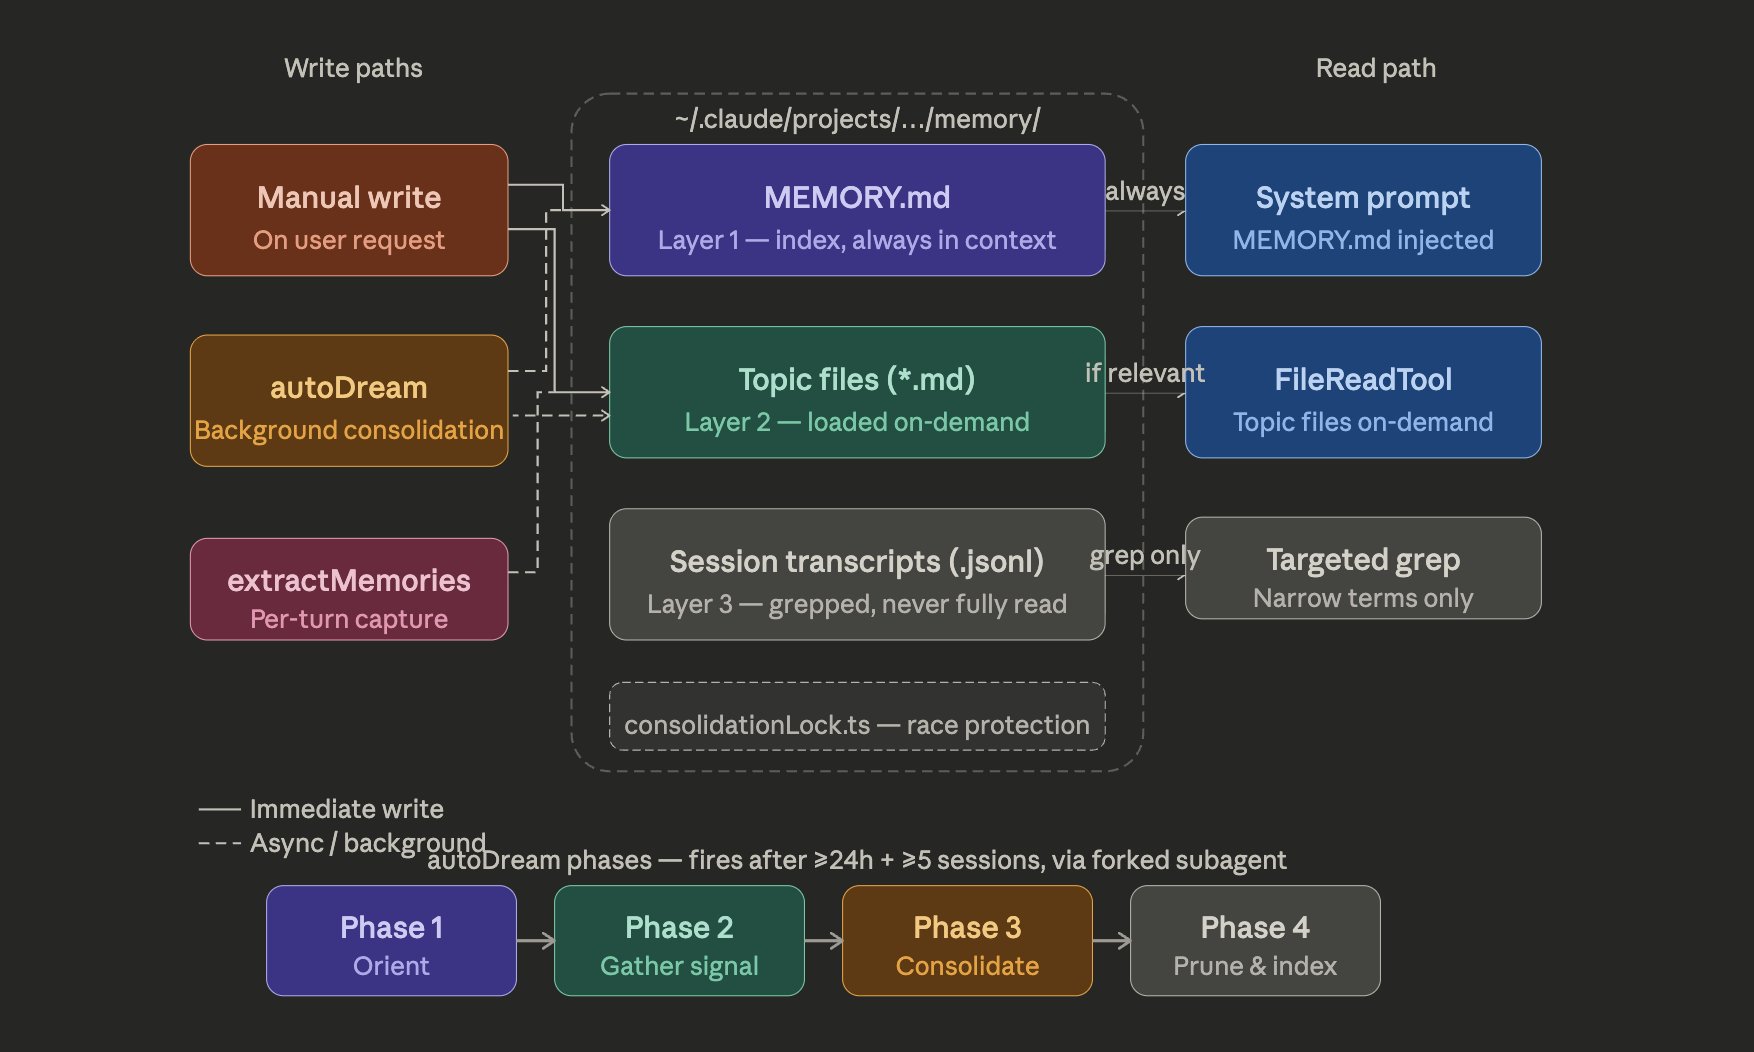
Claude 的五层记忆架构
Claude 并非只有一个单一的记忆系统。实际上,它拥有五层分别具有不同用途、成本和目标受众的记忆机制:
- 对话历史(Conversation history):最简单的一种记忆,包含了对话中所有用户提示词和 Claude 响应的
jsonl格式日志(可以通过/export导出)。每个项目上限 100 条,长文本粘贴会被哈希处理后单独存储,成本为零。 - 会话记忆(Session memory):这是一个由后台 Agent 在你的对话进行时构建和更新的结构化 Markdown 记忆。它本质上是一种压缩策略,当对话内容达到上下文窗口约 85% 时,它会对内容进行总结。虽然这段代码存在,但似乎受到一个神秘的
tengu_session_memory标志位限制(可能是未完全开放的功能)。 - CLAUDE.md:人类控制的一层,通常记录编码规范、偏好、需要记住的事项等。当启动会话时,Claude 会自动遍历文件系统的层级结构,加载多个
.claude.md文件。 - 自动记忆(Auto-memory):这通常是我们讨论 Claude Code 时所指的“核心记忆”。Claude 在这里从多次对话中了解用户(角色、偏好、项目上下文等)。这些数据存储在
~/.claude/projects/<slug>/memory/目录下。 - 团队记忆(Team memory):主要用于团队级别的协作。
接下来我们重点探讨自动记忆(Auto-memory),这也是对开发者和用户最可见、也最能影响本地体验的部分。
自动记忆是如何管理的?
Claude 的自动记忆绝不是简单粗暴的“只追加(append-only)”,它的管理非常有序,分为三个阶段:
1. 逐轮提取(Per-turn extraction)
一个后台 Agent 会分析过去的 N 条消息,决定哪些信息值得记忆,然后选择新建记忆文件或更新现有文件。在开始工作之前,它会接收现有的全部记忆,以确保它是在更新而非创建重复项。
写入过程非常严格。记忆有四种特定类型:
user:关于你是谁(角色、专业知识、偏好)feedback:你希望 Claude 如何工作(纠正和确认的方法)project:代码或 Git 无法直接告诉它的项目信息(截止日期、决策、动机)reference:在代码库之外哪里可以找到信息(如 Linear 看板、Slack 频道)
当为记忆创建一个新主题文件时,它的索引会记录在 MEMORY.md 中:
MEMORY.md (the index):
- [User Profile](user_profile.md) — backend engineer, 5 years Python, new to this
repo's React frontend
- [Testing Policy](feedback_testing.md) — never mock the database in integration
tests
...

feedback_testing.md (one memory file):
---
name: Testing policy
description: Integration tests must use real database connections, never mocks
type: feedback
---
(通过目录 + 一句话总结的方式,极大帮助 Agent 之后找到正确的记忆文件。)
Forked Agent 模式
你可能会问:“所有这些后台工作不会拖慢整体速度吗?”
答案是不会。提取信息的后台 Agent 是作为一个共享主对话 Prompt Cache 的“分叉子智能体(forked subagent)”运行的。不仅大部分输入 Token 能命中缓存,用户也不需要等待记忆操作完成。而且它受到沙盒限制:只能写入 isAutoMemPath() 允许的记忆路径,禁止使用 MCP 工具、Agent 工具以及具备写入权限的 Bash。
2. 定期整合(Periodic consolidation)
通过一个名为 autoDream 的后台进程,当经过足够的时间和会话次数(默认距离上次整合 24 小时和 5 个会话)时触发。它会进行四阶段扫描:
- 阅读
MEMORY.md索引并浏览现有的主题文件。 - 从日常日志和会话脚本中收集最近的信号(只做精准搜索,不通读)。
- 将新信息合并到现有文件中,将相对日期转换为绝对日期,并删除与当前代码库矛盾的事实。
- 清理冗余和陈旧指针,缩短啰嗦的条目,解决文件之间的矛盾(“如果两个文件有冲突,修复错误的那个”)。
3. 记忆删除不是自动的
目前没有过期时间或定时清理计划。要删除一段记忆,唯一的途径是 Agent 判定它与代码库不再相关或与其他记忆相矛盾。
如何检索记忆?
为了保持效率,Claude 绝不会把所有记忆都塞进上下文窗口。
MEMORY.md(上限 200 行 / 25KB)会始终加载到系统 Prompt 中。但具体的单个记忆文件不会。
Claude 使用速度更快的 Sonnet 模型作为相关性过滤器(即使你的主模型是 Opus)。当发出请求时,系统会启动一个非阻塞进程:
- 扫描所有记忆文件的前置数据(最多 200 个,按最新时间排序)
- 格式化清单:
[type] filename (timestamp): description - 将清单和你的查询一起发送给 Sonnet。
- Sonnet 选出最相关的 5 个文件名。
- 只有这 5 个文件会被加载到上下文中。
这也解释了为什么记忆文件 Frontmatter 中的 description 字段如此重要,因为这是 Sonnet 判定相关性时看到的唯一内容。
安全性与约束
值得一提的是,自动记忆目录 (autoMemoryDirectory) 的自定义配置只能在全局设置 ~/.claude/settings.json 中配置,而不能在项目级别的 .claude/settings.json 中设置。这是为了防止恶意代码库通过覆盖该路径实现对敏感文件(如 ~/.ssh)的静默写入权限。
此外,对于超过 1 天的旧记忆,系统会在加载时强制注入一条警告:“这段记忆已经 X 天了,这只是一个时间点的观察,不是实时状态,请在确认事实前先对比当前代码库。”
结语
Claude Code 的记忆系统完美展示了如何为一个强大的基础模型套上可靠的“缰绳”(Harness)。从强制的格式化结构、依赖廉价小模型检索、防范并发读写,到对历史信息的怀疑论设定,每一步都展现了工程师对于 AI 系统设计深度边界的思考。