Autoresearch:AI Agent 全自动单卡大模型炼丹
快速阅读
曾经,前沿的 AI 研究需要大量的人工介入,通过组会进行频繁对齐。而 Karpathy 在 2026 年发布的最新开源项目 Autoresearch,展示了一个全新的范式:将实验的接力棒完全交给 AI Agent。
这个项目基于单卡环境与简化的 GPT 训练代码,引入了极为克制的固定时间预算(5分钟/次)。在这个框架下,AI 可以自主修改模型结构、超参数和优化器,独立完成评估并决定代码的去留。人类研究员不再需要手动调整代码,而是通过修改一份核心的 program.md 指令文件,去指挥 Agent 的探索方向。
项目介绍
Autoresearch 的核心理念是:给 AI Agent 提供一个小型但真实的 LLM 训练环境,让它在夜间自主进行实验。
它的工作流非常纯粹:
- Agent 自动修改训练代码。
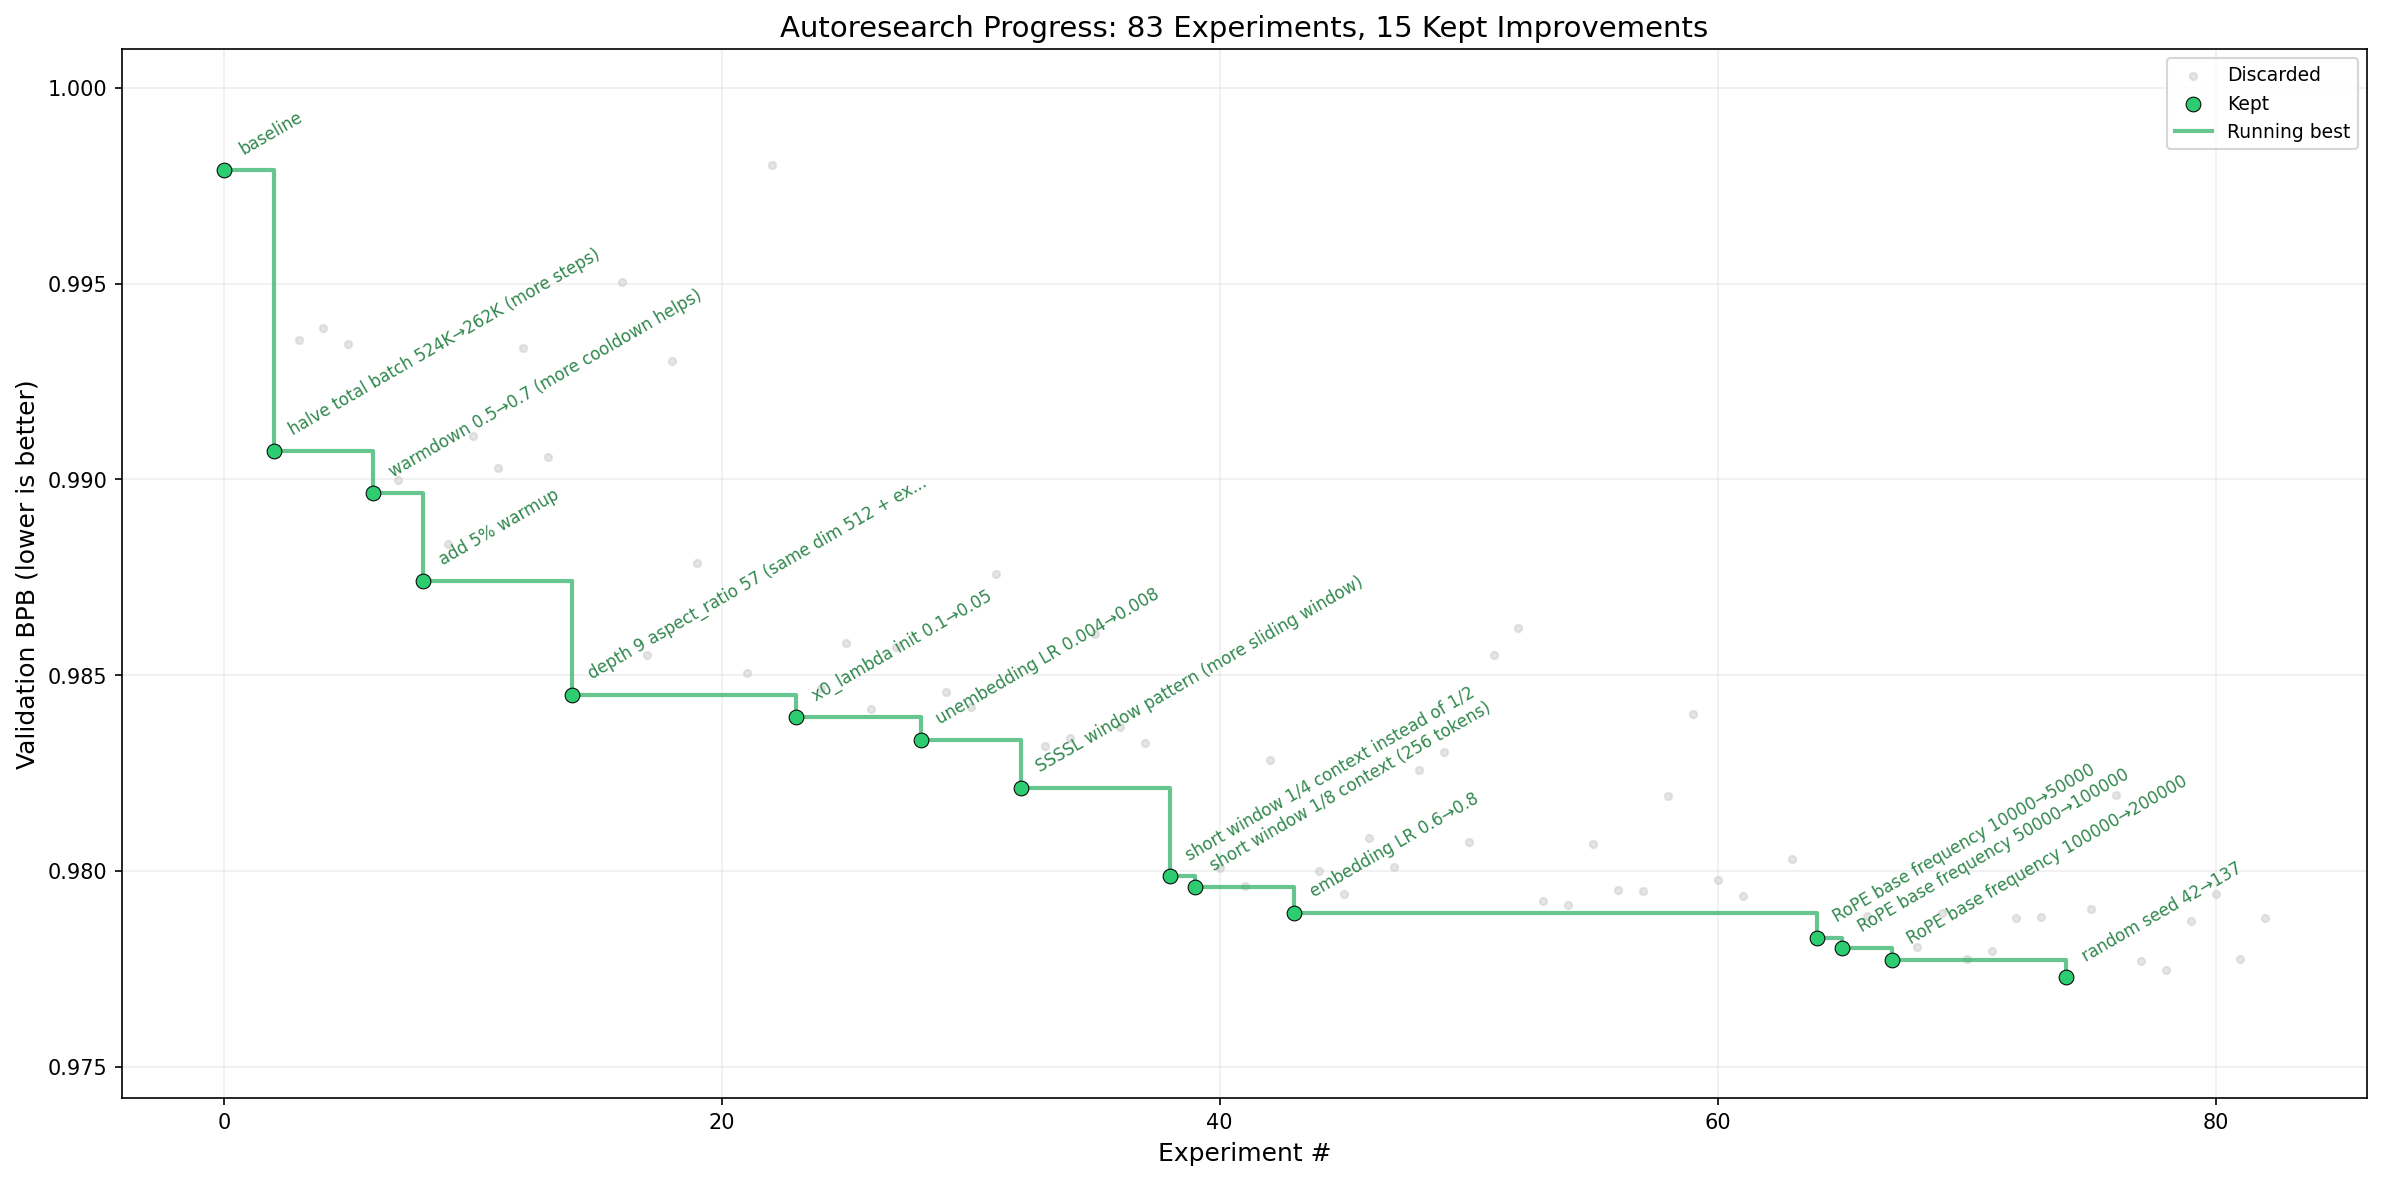
- 运行长达 5 分钟的训练。
- 检查模型结果(基于
val_bpb,即 validation bits per byte)是否有所提升。 - 如果有提升则保留修改,否则放弃并开启下一轮实验。
一觉醒来,你就能获得一份详细的实验日志以及(大概率)一个更好的模型。该项目中的训练代码是 Karpathy 之前开源的 nanochat 的极简单 GPU 实现。
架构设计
为了保证纯粹性和极高的可控性,Autoresearch 整个仓库极其精简,核心逻辑被拆分在三个主要文件中,分工明确:
prepare.py(静态基础设施) 这个文件包含了不可修改的常量、一次性的数据准备逻辑(下载训练数据、训练 BPE 分词器)以及运行时的实用工具(如 dataloader 和评估脚本)。train.py(Agent 演练场) 这是整个系统中唯一允许 Agent 进行修改的文件。里面包含完整的 GPT 模型架构、优化器(如前沿的 Muon + AdamW)和训练循环。Agent 可以随心所欲地修改架构、超参数、batch size 甚至魔改优化器。program.md(人类控制台) 这份 Markdown 文件是单 Agent 的指令基线,用于给 Agent 提供上下文与约束。作为研究员,你的工作不再是直接写 Python,而是编写和迭代这份文档,指挥你的“AI 炼丹团队”。
设计理念
Autoresearch 能在极短时间内引起社区的巨大反响,源于其几个深思熟虑的设计选择:
- 唯一修改入口:Agent 只能修改
train.py。这大幅降低了代码库崩坏的风险,且让每一次的代码 Diff 都能被轻松 Review。 - 绝对公平的“时间预算”:每次实验固定运行 5 分钟。无论 Agent 如何修改参数或模型结构,验证集上的表现都是在同等时间算力下得出的。这意味着实验有了统一的标准,Agent 会自动寻找到在你当前硬件上“性价比最高”的优化方案。
- 极致的开箱即用:无需复杂的分布式配置,仅依赖 PyTorch 等极少核心包,一台普通的单卡机器(如 NVIDIA GPU)即可直接上岗。
基础用法
如果有一张 NVIDIA GPU(环境要求 Python 3.10+ 并安装了 uv 包管理器),你可以通过以下命令快速启动:
# 1. 安装 uv 包管理器(如果没有的话)
curl -LsSf https://astral.sh/uv/install.sh | sh

# 2. 安装项目依赖
uv sync

# 3. 运行数据下载并训练分词器(仅需一次,约 2 分钟)
uv run prepare.py

# 4. 手动运行单次训练实验,验证环境是否正常(约 5 分钟)
uv run train.py
当上述命令跑通后,你的自主炼丹炉就搭好了。接下来只需启动并引入你最喜欢的编码 Agent(如 Claude / Codex),禁用其所有破坏性权限后输入指令:“看看 program.md,让我们开启一轮新实验吧!”
对于想在 MacBook 等算力更小的设备上尝试的朋友,社区也已经迅速响应,诞生了针对 MacOS (mlx) 和 Windows RTX 的 多个 Fork 版本。Karpathy 也在项目里给出了详细的小显存适配建议(如大幅降低 vocab_size 和 MAX_SEQ_LEN)。