如何构建多智能体研究系统:来自 Anthropic 的经验
快速阅读
Anthropic 近期推出了具备研究能力的 Claude,它能跨网页、Google Workspace 及各种集成工具执行复杂任务。这背后是一个多智能体(Multi-agent)研究系统。这篇博客分享了他们从原型到生产环境中获得的经验教训:
- 多智能体优势:适合探索性强、路径动态的研究任务。子智能体(Subagents)通过并行运作,扩大了上下文容量,大幅提高了问题解决能力。
- 架构概览:采用“编排者-工作者”模式(Orchestrator-Worker)。主智能体负责制定策略,并生成专门的子智能体并行搜索和过滤信息。
- 提示工程与评估:需教导主智能体如何委派任务,并根据查询复杂度调整规模。设计良好的工具接口和使用“思维扩展”(Extended thinking)是关键。
- 生产挑战:状态保持与错误累积是主要难题。这需要结合 AI 的适应性与确定性的安全护栏(如重试机制和检查点),并使用特定的部署和调试策略。
Claude 现在具备了研究能力,允许其在网络、Google Workspace 及任何集成中进行搜索,以完成复杂的任务。这个多智能体系统从原型到生产的旅程,为系统架构、工具设计和提示工程带来了关键的经验教训。多智能体系统由多个智能体(自主在循环中使用工具的 LLM)协同工作组成。Anthropic 的研究功能包含一个主智能体,它根据用户查询规划研究流程,然后使用工具创建并行的子智能体,同时搜索信息。引入多个智能体也带来了智能体协调、评估和可靠性方面的新挑战。
以下是适用于构建多智能体系统的一些有效原则。
多智能体系统的优势
研究工作涉及开放性问题,很难预先设定步骤。人类在进行研究时,往往会根据发现不断更新方法。这种不可预测性使得 AI 智能体特别适合此类任务。研究需要灵活性,以便在调查展开时进行方向的转换或探索关联信息。模型必须能够自主运行多个回合,根据中间结果决定探索方向,这是线性的单次处理管道无法做到的。
搜索的本质是压缩:从庞大的语料库中提取洞察。子智能体利用各自的上下文窗口并行运行,同时探索问题的不同方面,然后为主研究智能体压缩最重要的信息,从而促进了这种压缩过程。这种架构还实现了关注点的分离,减少了路径依赖,使调查更加彻底和独立。
当智能达到一定阈值时,多智能体系统成为扩展性能的重要途径。正如人类社会通过集体智慧变得更加强大一样,多智能体系统在广度优先(Breadth-first)的查询中表现卓越。内部评估显示,以 Claude Opus 4 为主智能体,Claude Sonnet 4 为子智能体的系统,在内部研究评估中比单个 Claude Opus 4 智能体的表现高出 90.2%。
多智能体系统之所以有效,主要是因为它们消耗了足够的 Token 来解决问题。分析表明,Token 使用量解释了 80% 的性能差异。不过,缺点是代币消耗极快,多智能体系统使用的 Token 大约是普通聊天的 15 倍。因此,它们更适合价值较高、需要大量并行处理、信息超出单个上下文窗口以及需要与众多复杂工具交互的任务。
研究系统的架构概览
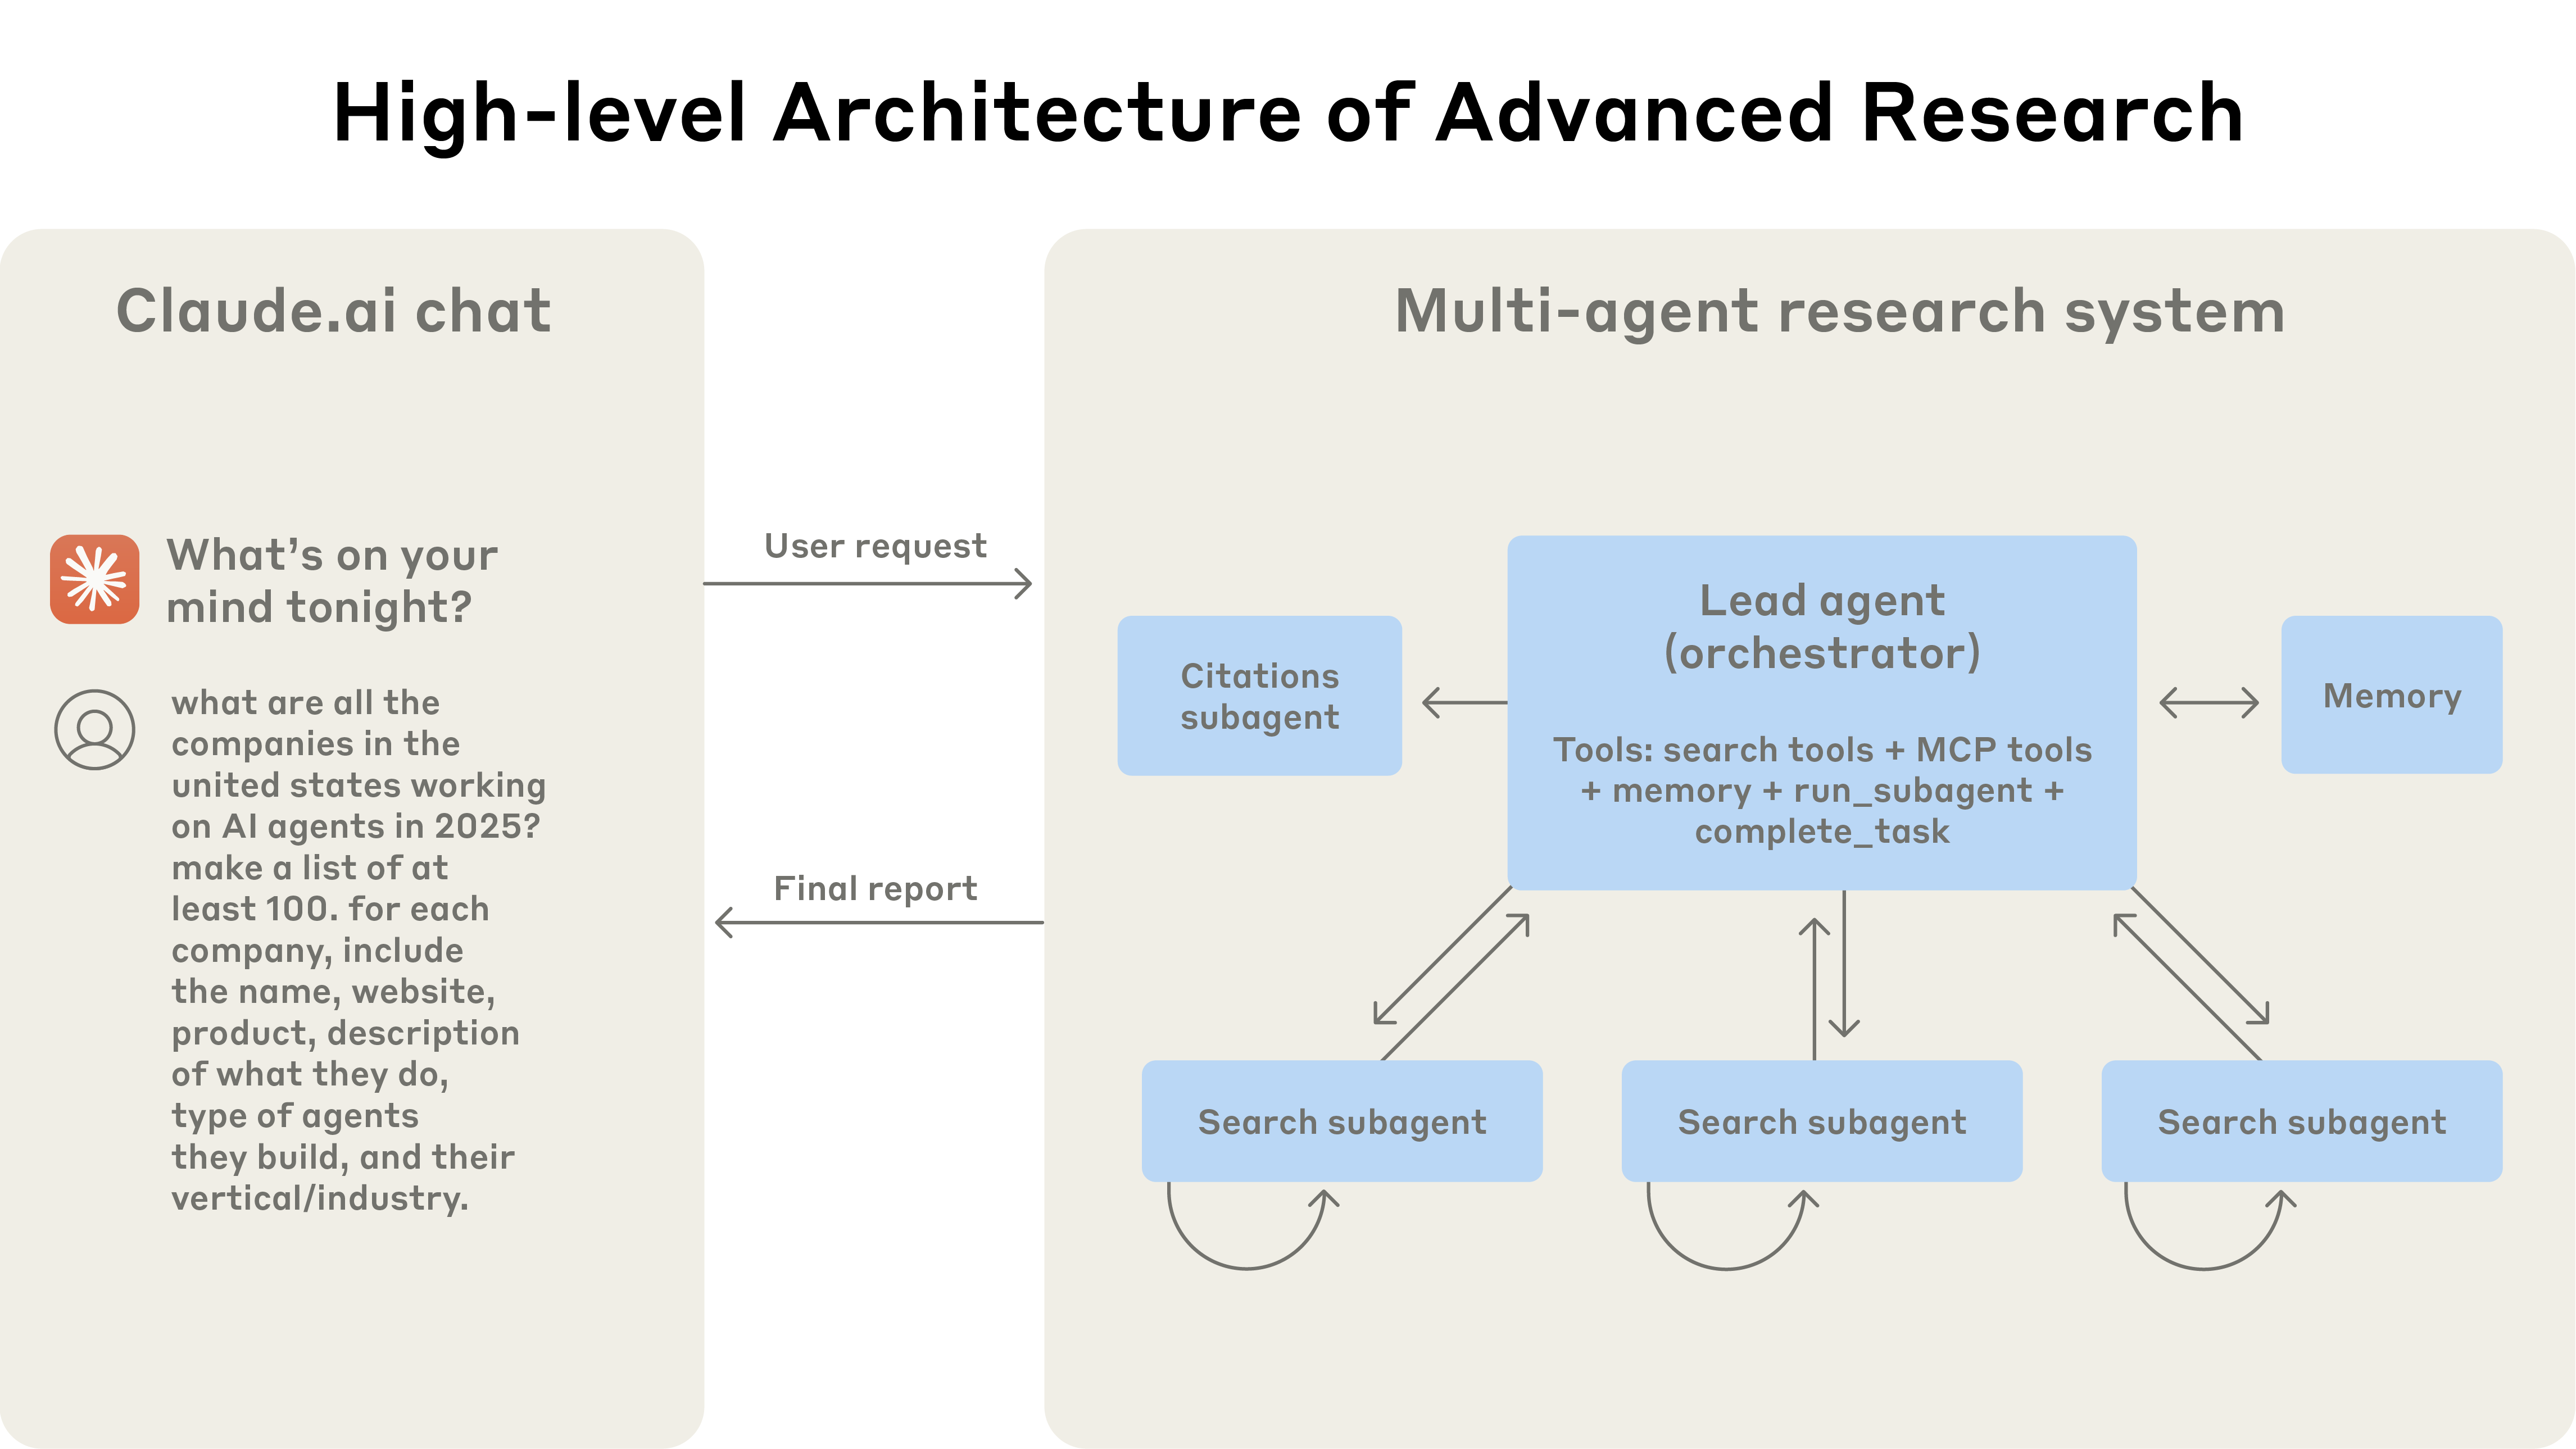
该研究系统采用了“编排者-工作者”(Orchestrator-worker)模式。当用户提交查询时,主智能体会进行分析、制定策略,并生成子智能体以同时探索不同方面。子智能体充当智能过滤器,迭代使用搜索工具收集信息,然后将结果返回给主智能体以汇编最终答案。
与传统的检索增强生成(RAG)使用静态检索不同,这种架构使用的是多步搜索,能动态查找相关信息,适应新发现,并分析结果以形成高质量的答案。
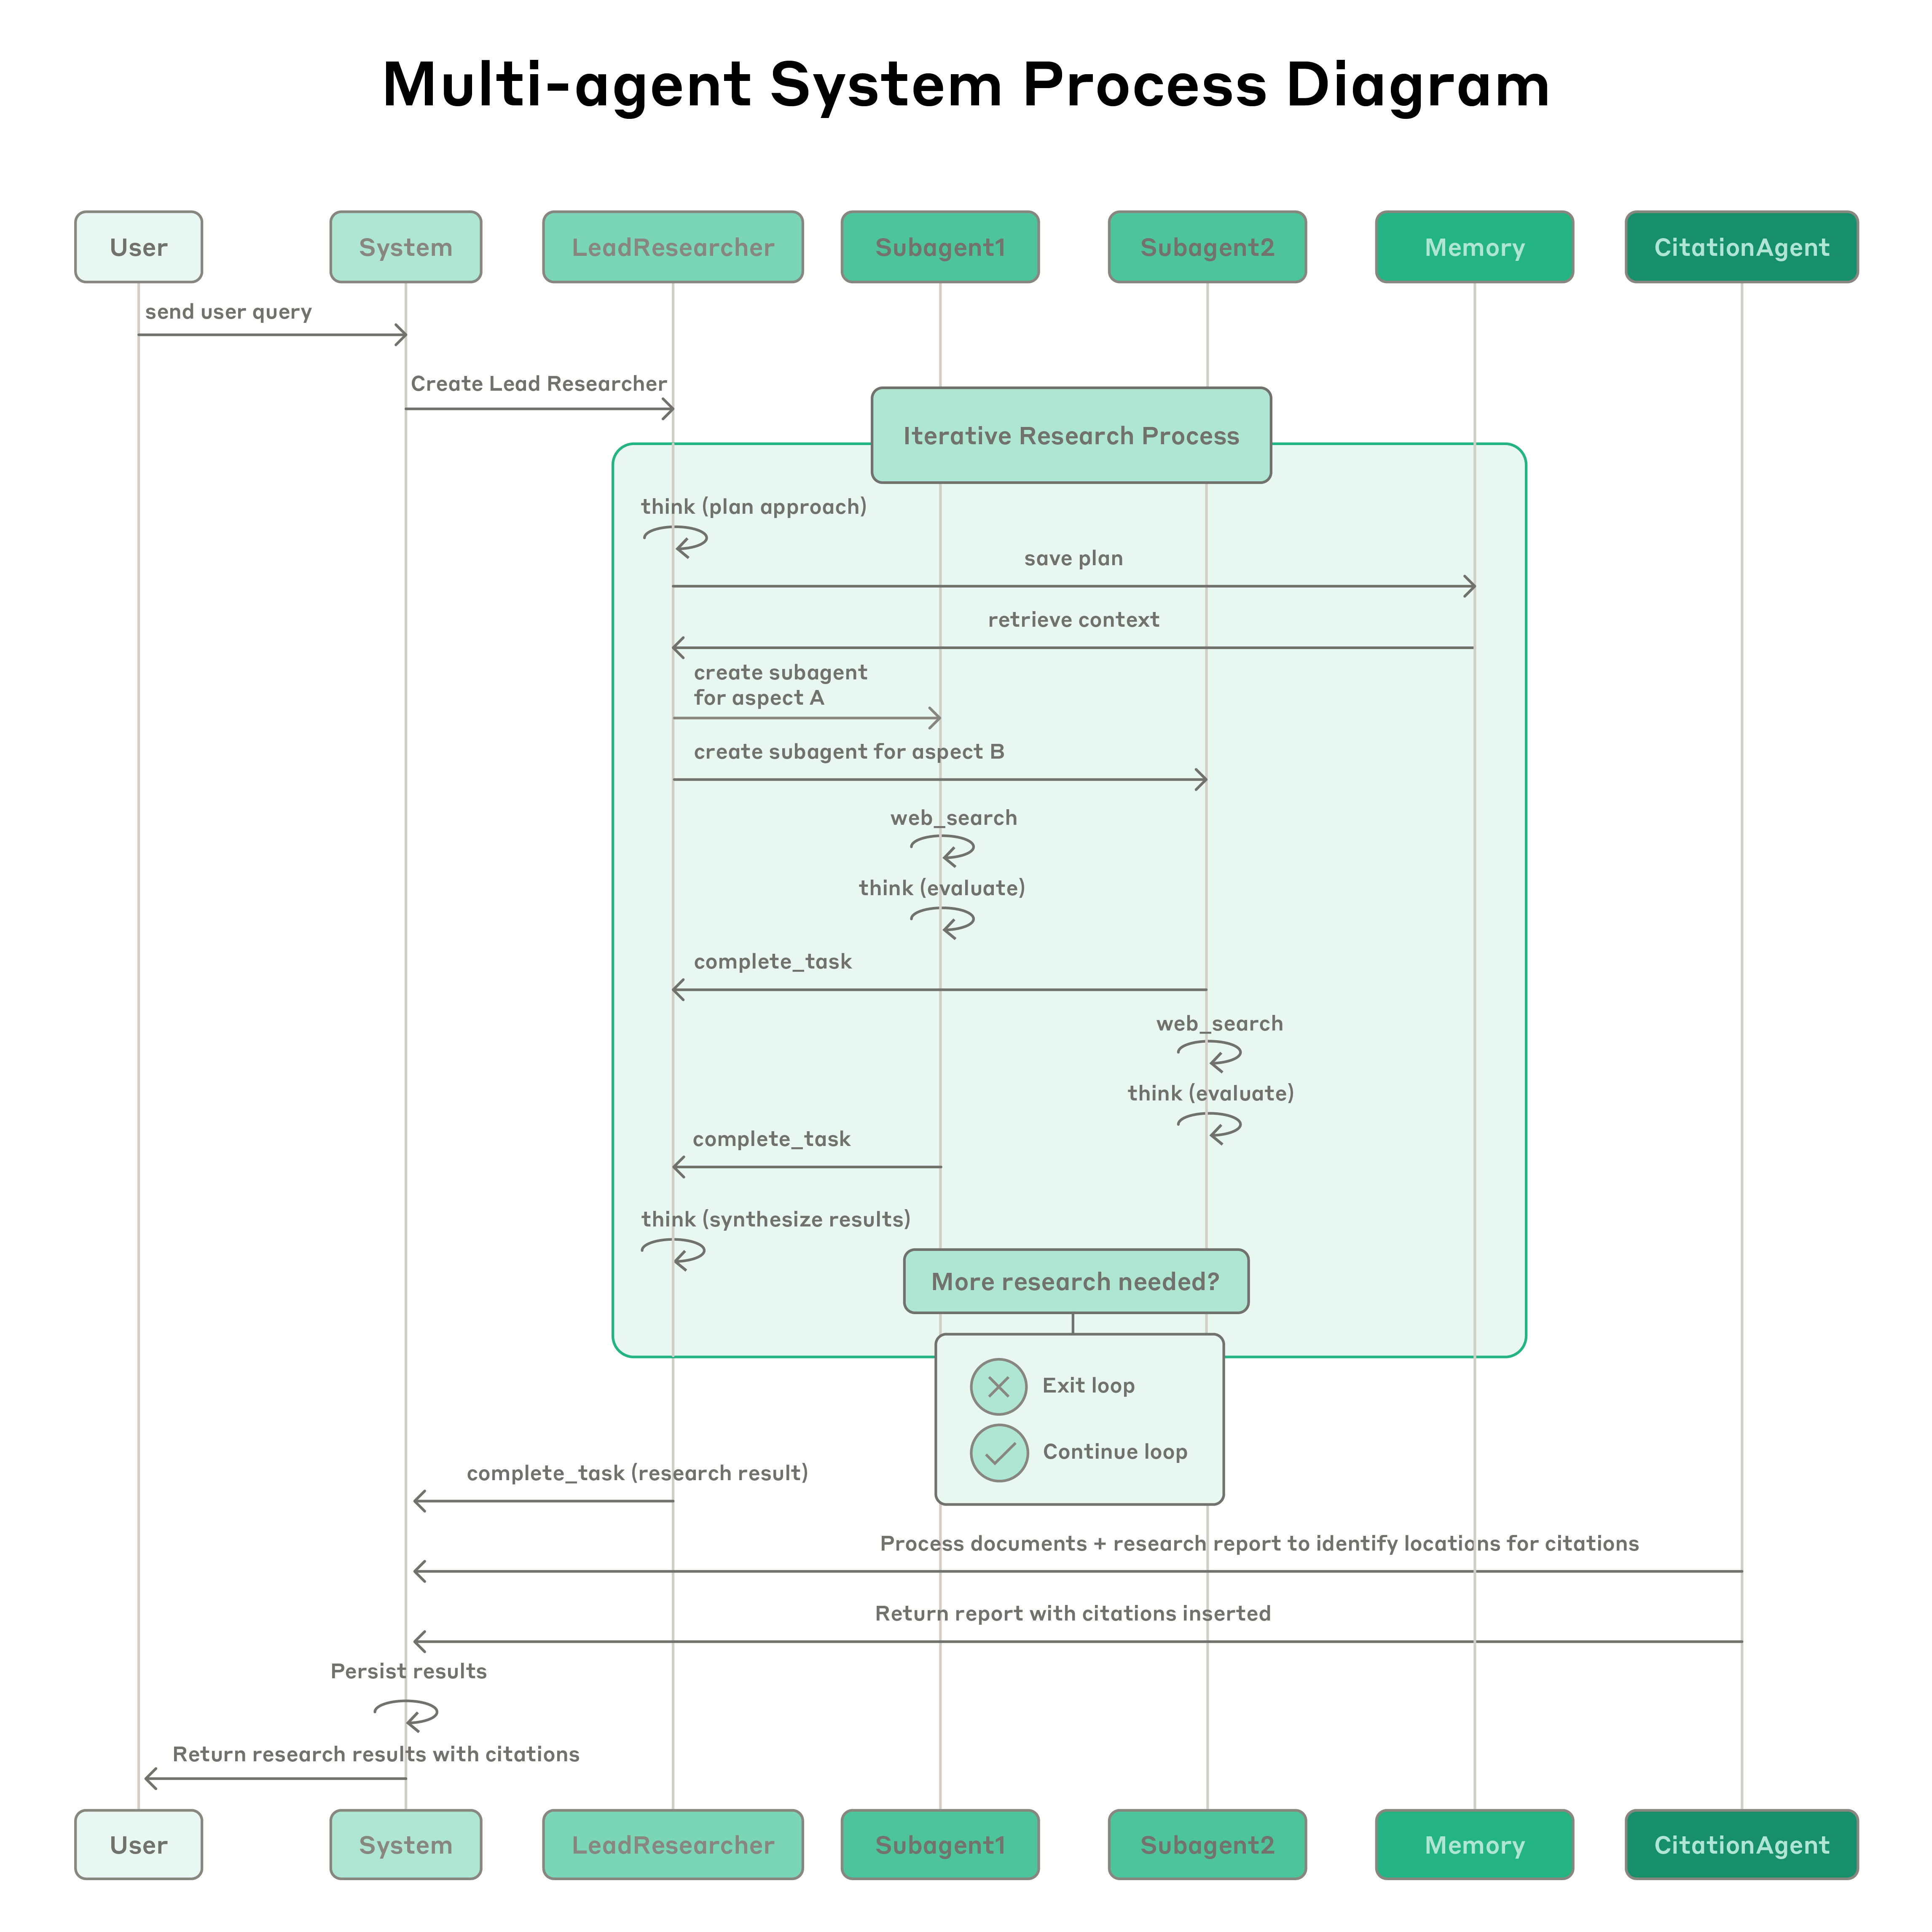
流程如下:
- 主研究员(LeadResearcher):思考方法,将计划保存到内存中,并创建专门的子智能体。
- 子智能体(Subagents):独立执行网络搜索,使用交错思维(Interleaved thinking)评估工具结果,并将发现返回。
- 主研究员综合:决定是否需要更多研究。如果信息足够,则退出循环。
- 引用智能体(CitationAgent):处理文档和研究报告,确保所有声明都有准确的来源引用。
研究智能体的提示工程与评估
多智能体系统的协调复杂度增长迅速。早期智能体经常犯错,例如为简单查询生成 50 个子智能体,或在不存在的来源中无休止地搜索。提示工程是改善这些行为的主要手段:
- 像智能体一样思考:使用真实系统构建模拟,逐步观察智能体的工作,以发现故障模式。
- 教导编排者如何委派:为子智能体提供明确的目标、输出格式、工具指导和任务边界,防止重复工作。
- 根据查询复杂度调整工作量:在提示中嵌入扩展规则,如简单事实查找只需要 1 个智能体,而复杂研究可能需要 10 个以上。
- 工具设计和选择至关重要:智能体与工具的接口和人机接口一样重要。为工具提供清晰的描述,并设定明确的启发式规则。
- 让智能体自我改进:Claude 4 模型是很优秀的提示工程师。可以通过测试智能体来发现并重写有缺陷的工具描述。
- 先宽后窄的搜索策略:提示智能体从简短、宽泛的查询开始,评估可用信息后,逐步缩小焦点。
- 引导思维过程:利用“扩展思维模式”(Extended thinking mode)作为可控的暂存器,帮助主智能体规划和评估。
- 并行工具调用提升性能:让主智能体并行生成子智能体,并让子智能体并行使用工具,将复杂查询的研究时间缩短了多达 90%。
在评估方面,传统的测试方法可能不再适用,因为智能体可能通过不同的有效路径达到同一目标。建议尽早使用小样本进行测试,并利用 LLM 作为裁判来进行可扩展的评估,同时保留人工评估以捕捉自动化系统容易遗漏的边缘情况和微妙偏差。
生产可靠性与工程挑战
在智能体系统中,微小的变化可能会引发巨大的行为改变。
- 状态保持与错误累积:智能体运行时间长,必须能够持久地执行代码并处理错误。Anthropic 构建了能够从错误发生处恢复的系统,结合了 AI 的适应性和确定性的重试逻辑。
- 调试困难:由于智能体的决策具有动态性和非确定性,需要完整的生产追踪来诊断失败原因,同时不窥探单个对话的隐私。
- 部署需谨慎:使用彩虹部署(Rainbow deployments)来平滑过渡,防止代码更改破坏正在运行的智能体。
- 同步执行的瓶颈:当前主智能体同步等待子智能体完成,虽然简化了协调,但也限制了并行性。未来转向异步执行将带来性能提升,但也会增加协调的复杂性。
结论
将 AI 智能体从原型推向生产环境面临着比预期更大的鸿沟。微小的问题可能导致智能体完全偏离轨道。尽管面临挑战,多智能体系统在开放式研究任务中已证明其巨大价值,能够帮助用户发现商机、解决技术难题并节省大量时间。这需要精心的工程设计、全面的测试、注重细节的提示和工具设计,以及跨团队的紧密协作。