Anthropic的上下文检索 (Contextual Retrieval):解决RAG痛点的新方法
快速阅读
为了让 AI 模型掌握特定的背景知识,开发者通常使用检索增强生成(RAG)。然而,传统 RAG 在切分和编码信息时会破坏文本块(chunk)的上下文,导致无法从知识库中检索到相关信息。
Anthropic 在本文中提出了一种名为 上下文检索 (Contextual Retrieval) 的新方法,包含“上下文嵌入 (Contextual Embeddings)”和“上下文 BM25”两项子技术。此方法能将检索失败率降低 49%;如果结合重排技术 (Reranking),甚至可将失败率降低 67%。开发者只需借助 Claude 结合“提示词缓存 (Prompt Caching)”功能,就可以极低的成本为大规模知识库生成所需的上下文信息,从而大幅提升 RAG 系统的准确性。
更长提示词作为简单解
有时候最简单的解决方案就是最好的方案。如果您的知识库小于 200,000 token(约 500 页材料),您只需将整个知识库放入模型提示词中,无需使用 RAG 等复杂方法。
最近几周,Claude 发布了 提示词缓存 (Prompt Caching),使这种长提示词方法变得更快且更具性价比。现在,开发者可以在 API 调用之间缓存常用提示词,将延迟降低超过 2 倍,成本最高降低 90%。 然而,随着知识库的增长,您将需要一种更具扩展性的解决方案。这就是“上下文检索”发挥作用的地方。
传统 RAG 的局限:上下文丢失
对于不适合完全放入上下文窗口的大型知识库,标准的做法是使用 RAG(检索增强生成)。 传统 RAG 的流程是将知识库文档拆分成较小的文本块(通常不超过几百个 token),将其转换为向量嵌入并存储在向量数据库中。在运行时,系统会根据用户查询的语义相似度找到最相关的文本块并添加到提示词中。为了弥补向量嵌入在精确匹配方面的不足,系统常常会引入 BM25(最佳匹配 25,基于 TF-IDF 原理)来进行词汇匹配,比如精确搜索特定的错误代码。
但传统 RAG 系统有一个致命的缺陷:它们在切分文档时破坏了上下文。 例如,当你查询“ACME Corp 2023年第二季度的收入增长是多少?”时,一个相关的文本块可能只是:“该公司的收入比上一季度增长了3%。”由于缺乏公司名称和时间背景,这个片段几乎无法被有效检索到。
引入上下文检索 (Contextual Retrieval)
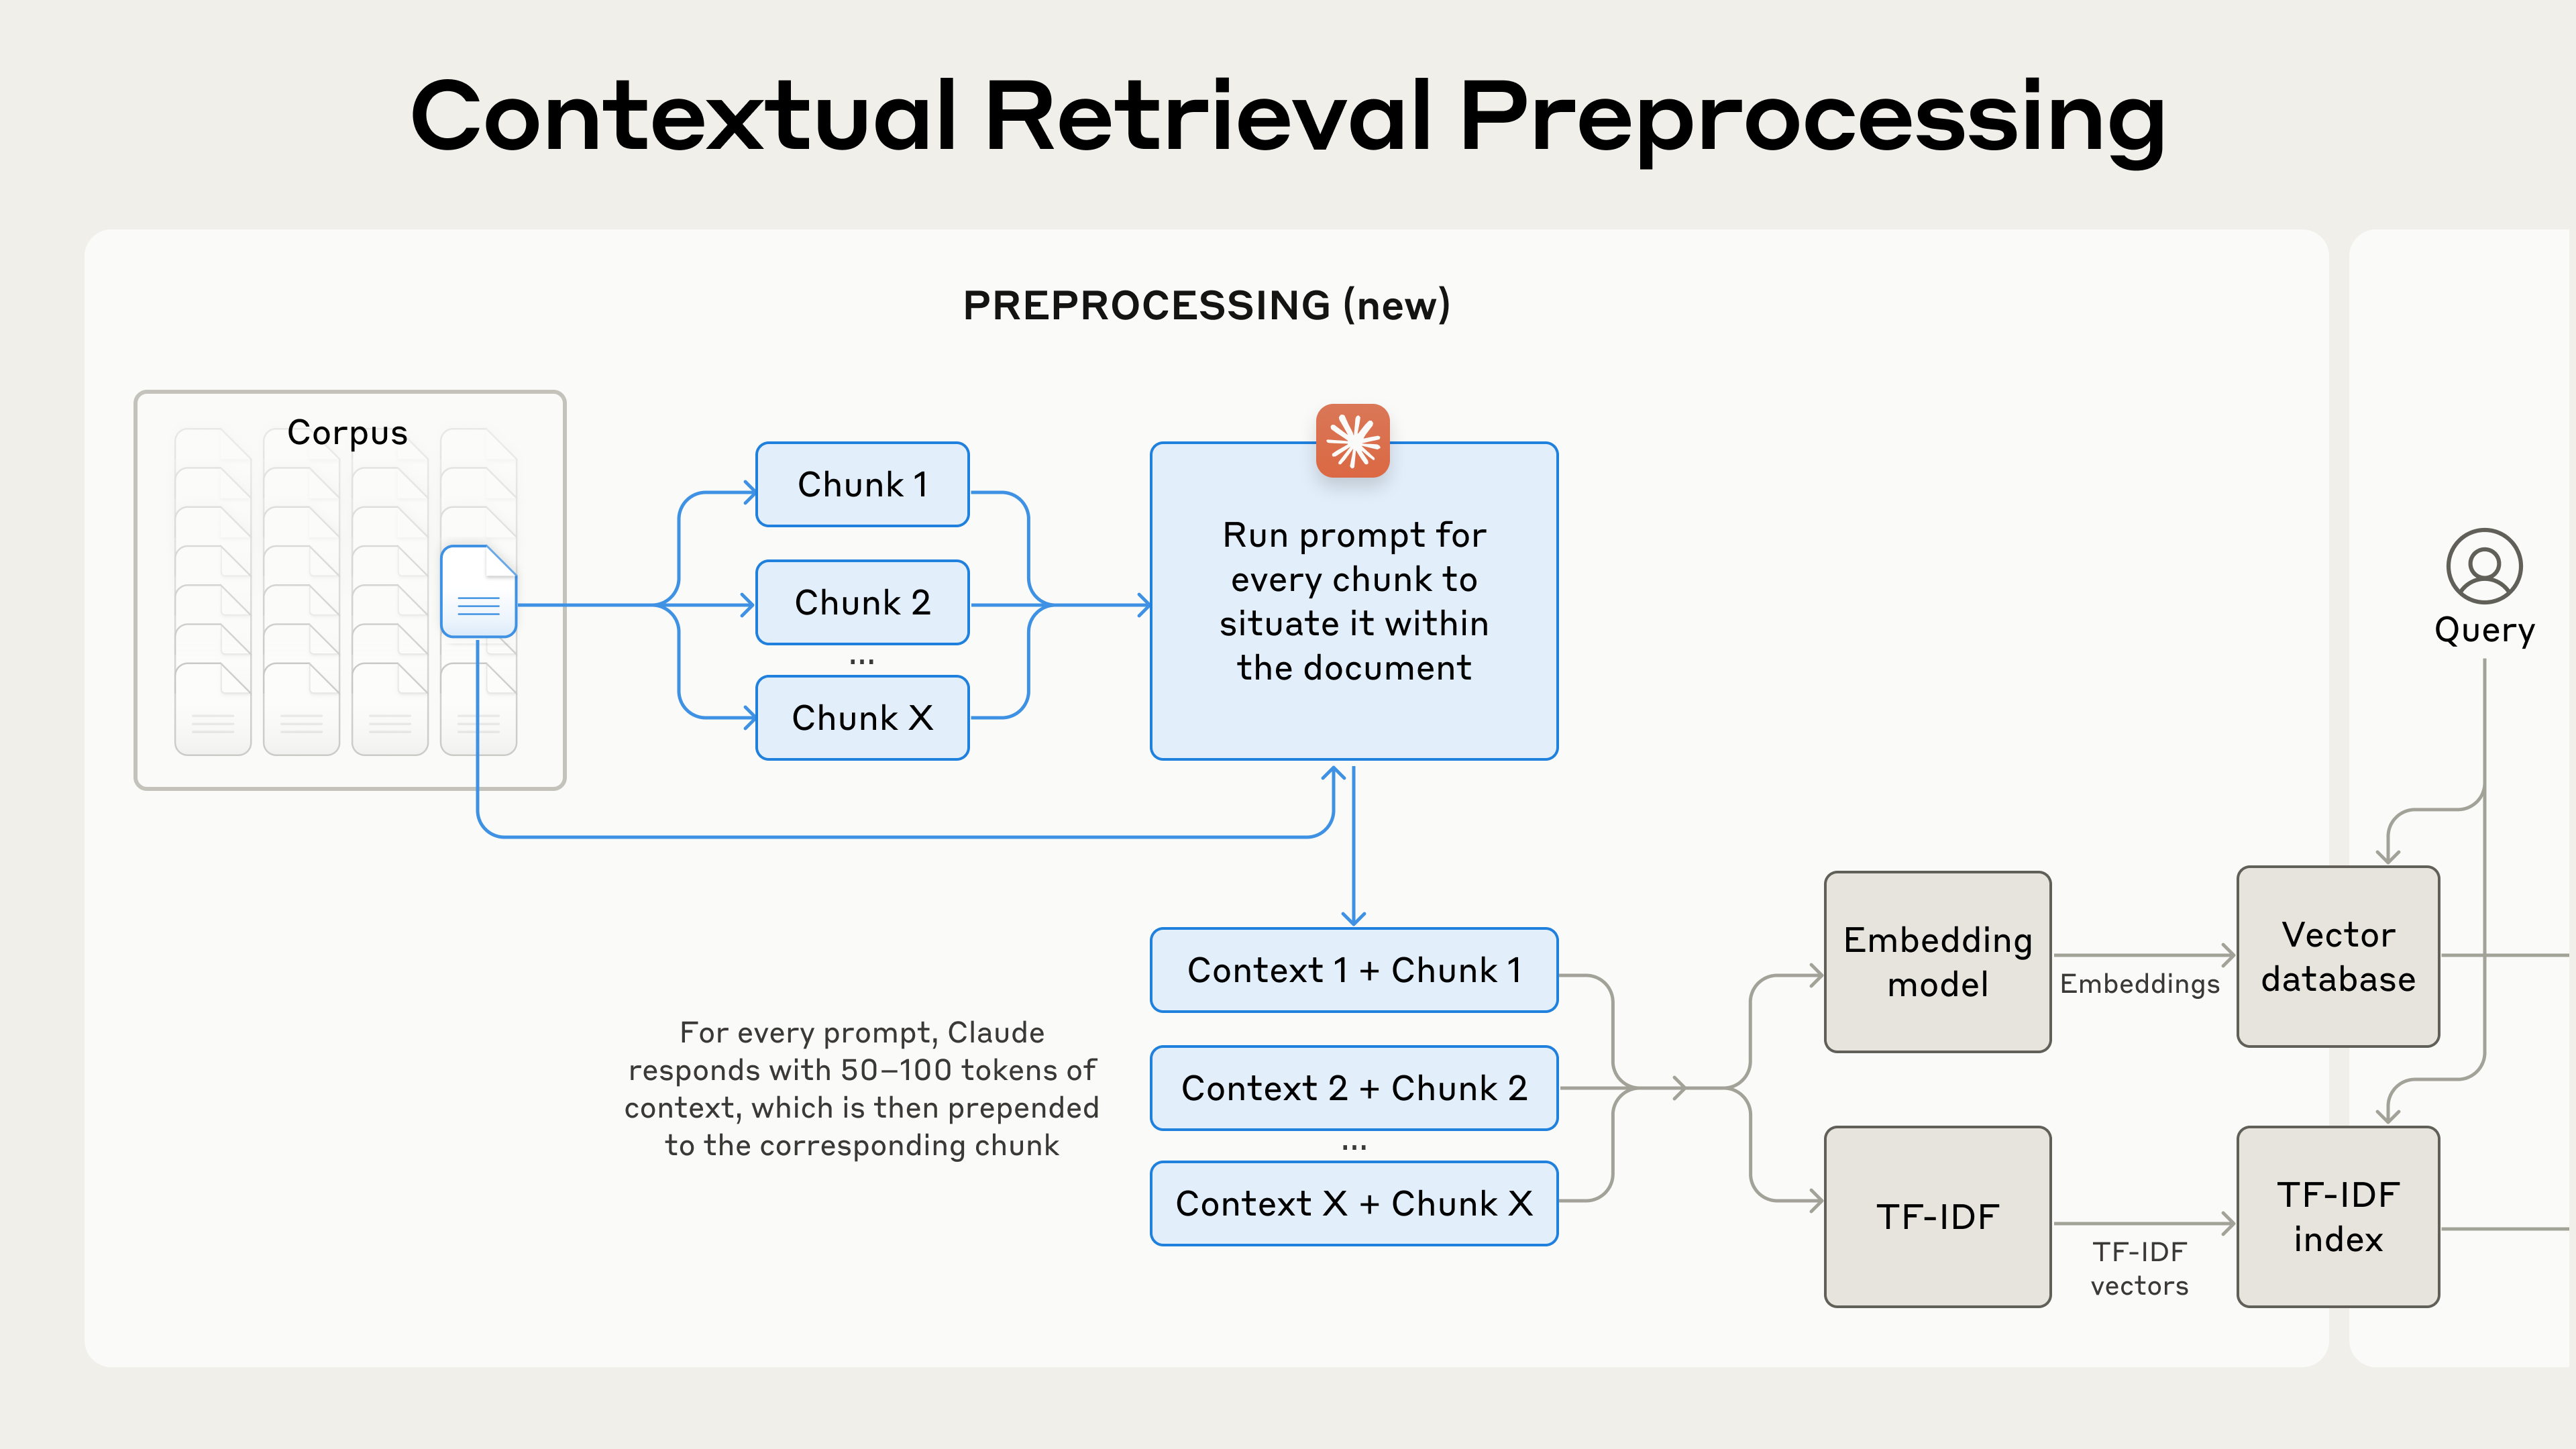
上下文检索通过在创建向量嵌入和 BM25 索引之前,为每个文本块加上特定且具有解释性的上下文,解决了这个问题。
回到前面的财报例子,传统的文本块会被改造为:
改造后:“这段文本来自 ACME 公司 2023 年第二季度的业绩报告;上一季度的收入为 3.14 亿美元。该公司的收入比上一季度增长了3%。”
实施上下文检索
为了避免人工为成千上万个文本块添加上下文,我们可以让 Claude 代劳。使用 Claude 3 Haiku(或更强的模型)及简单的提示词,可以自动为每个文本块生成几十个 token 的短小精悍的上下文背景。这一段小背景在创建文本块及其 BM25 索引前会被附加在其前面。
利用提示词缓存降低成本
由于 Claude 拥有提示词缓存功能,你不需要为每个切分的文本块反复传递整个长文档。你只需将原文档放入缓存一次,然后让每个文本块复用这个缓存。以 800 token 的文本块、8k token 的文档和每块 100 token 的上下文计算,生成上下文文本块的一次性成本极低,仅为每百万文档 token $1.02。
性能显著提升
Anthropic 在代码库、小说、ArXiv 论文等多个领域测试了该方法:
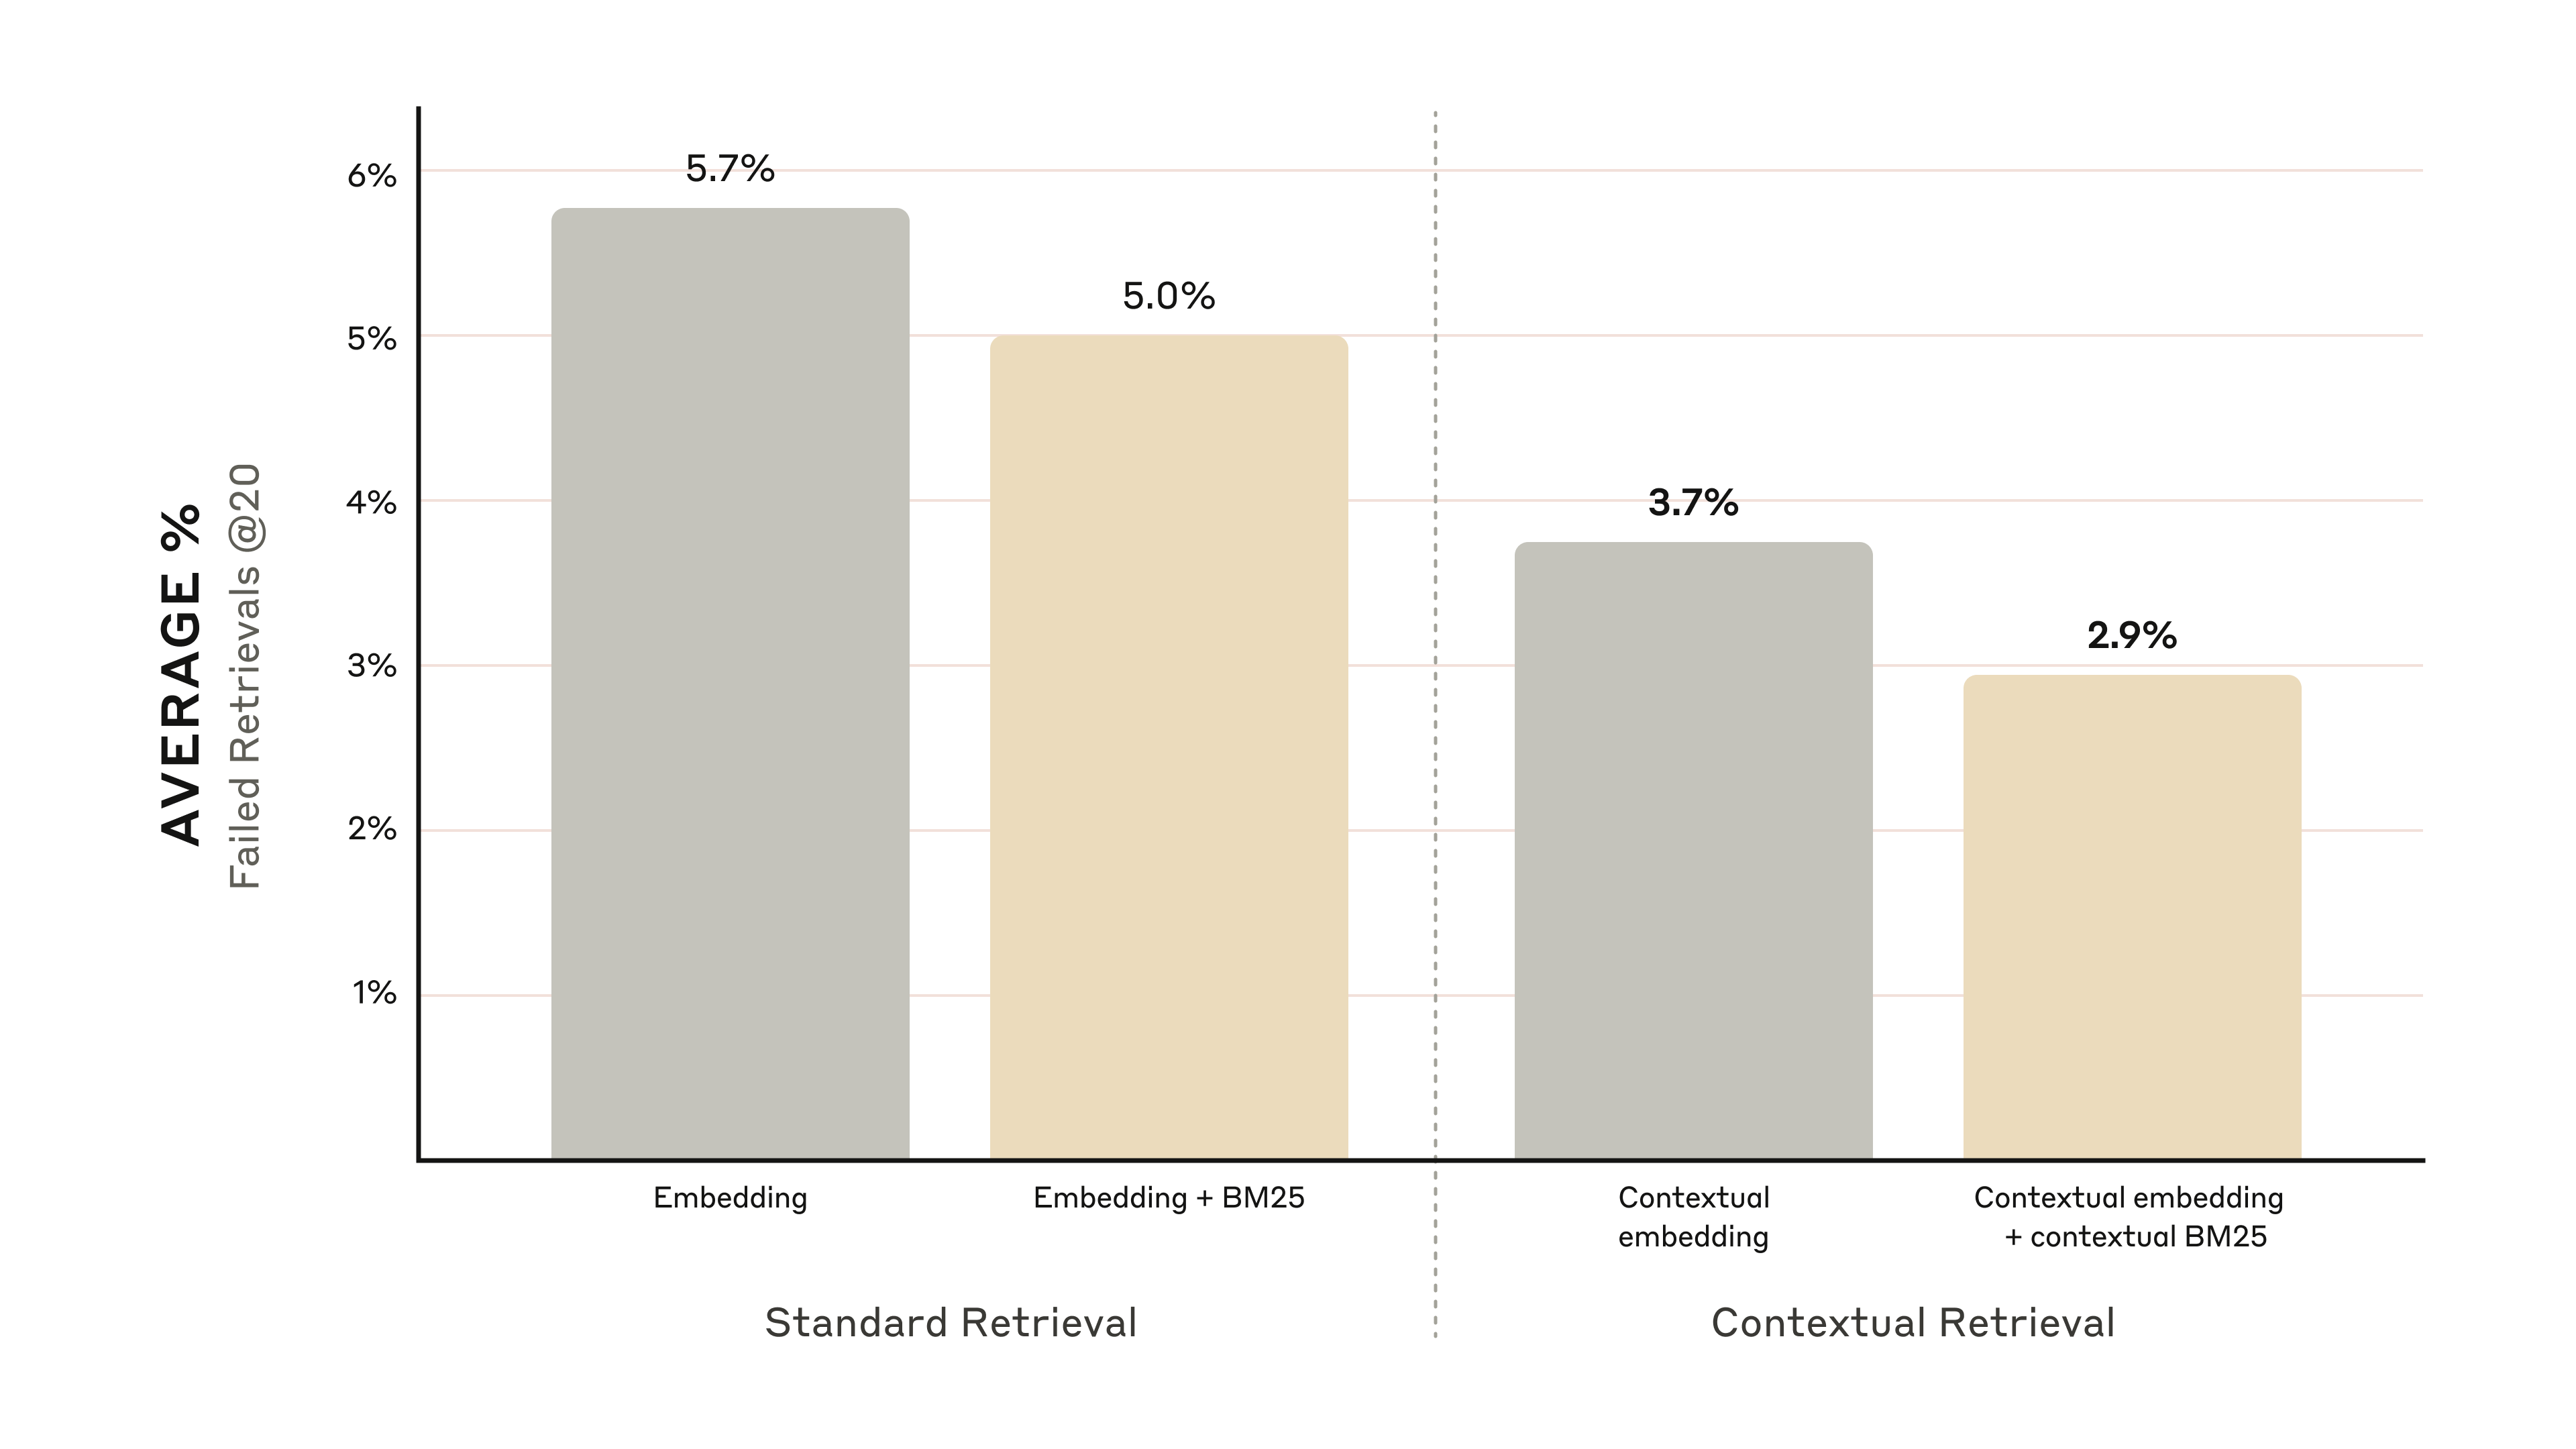
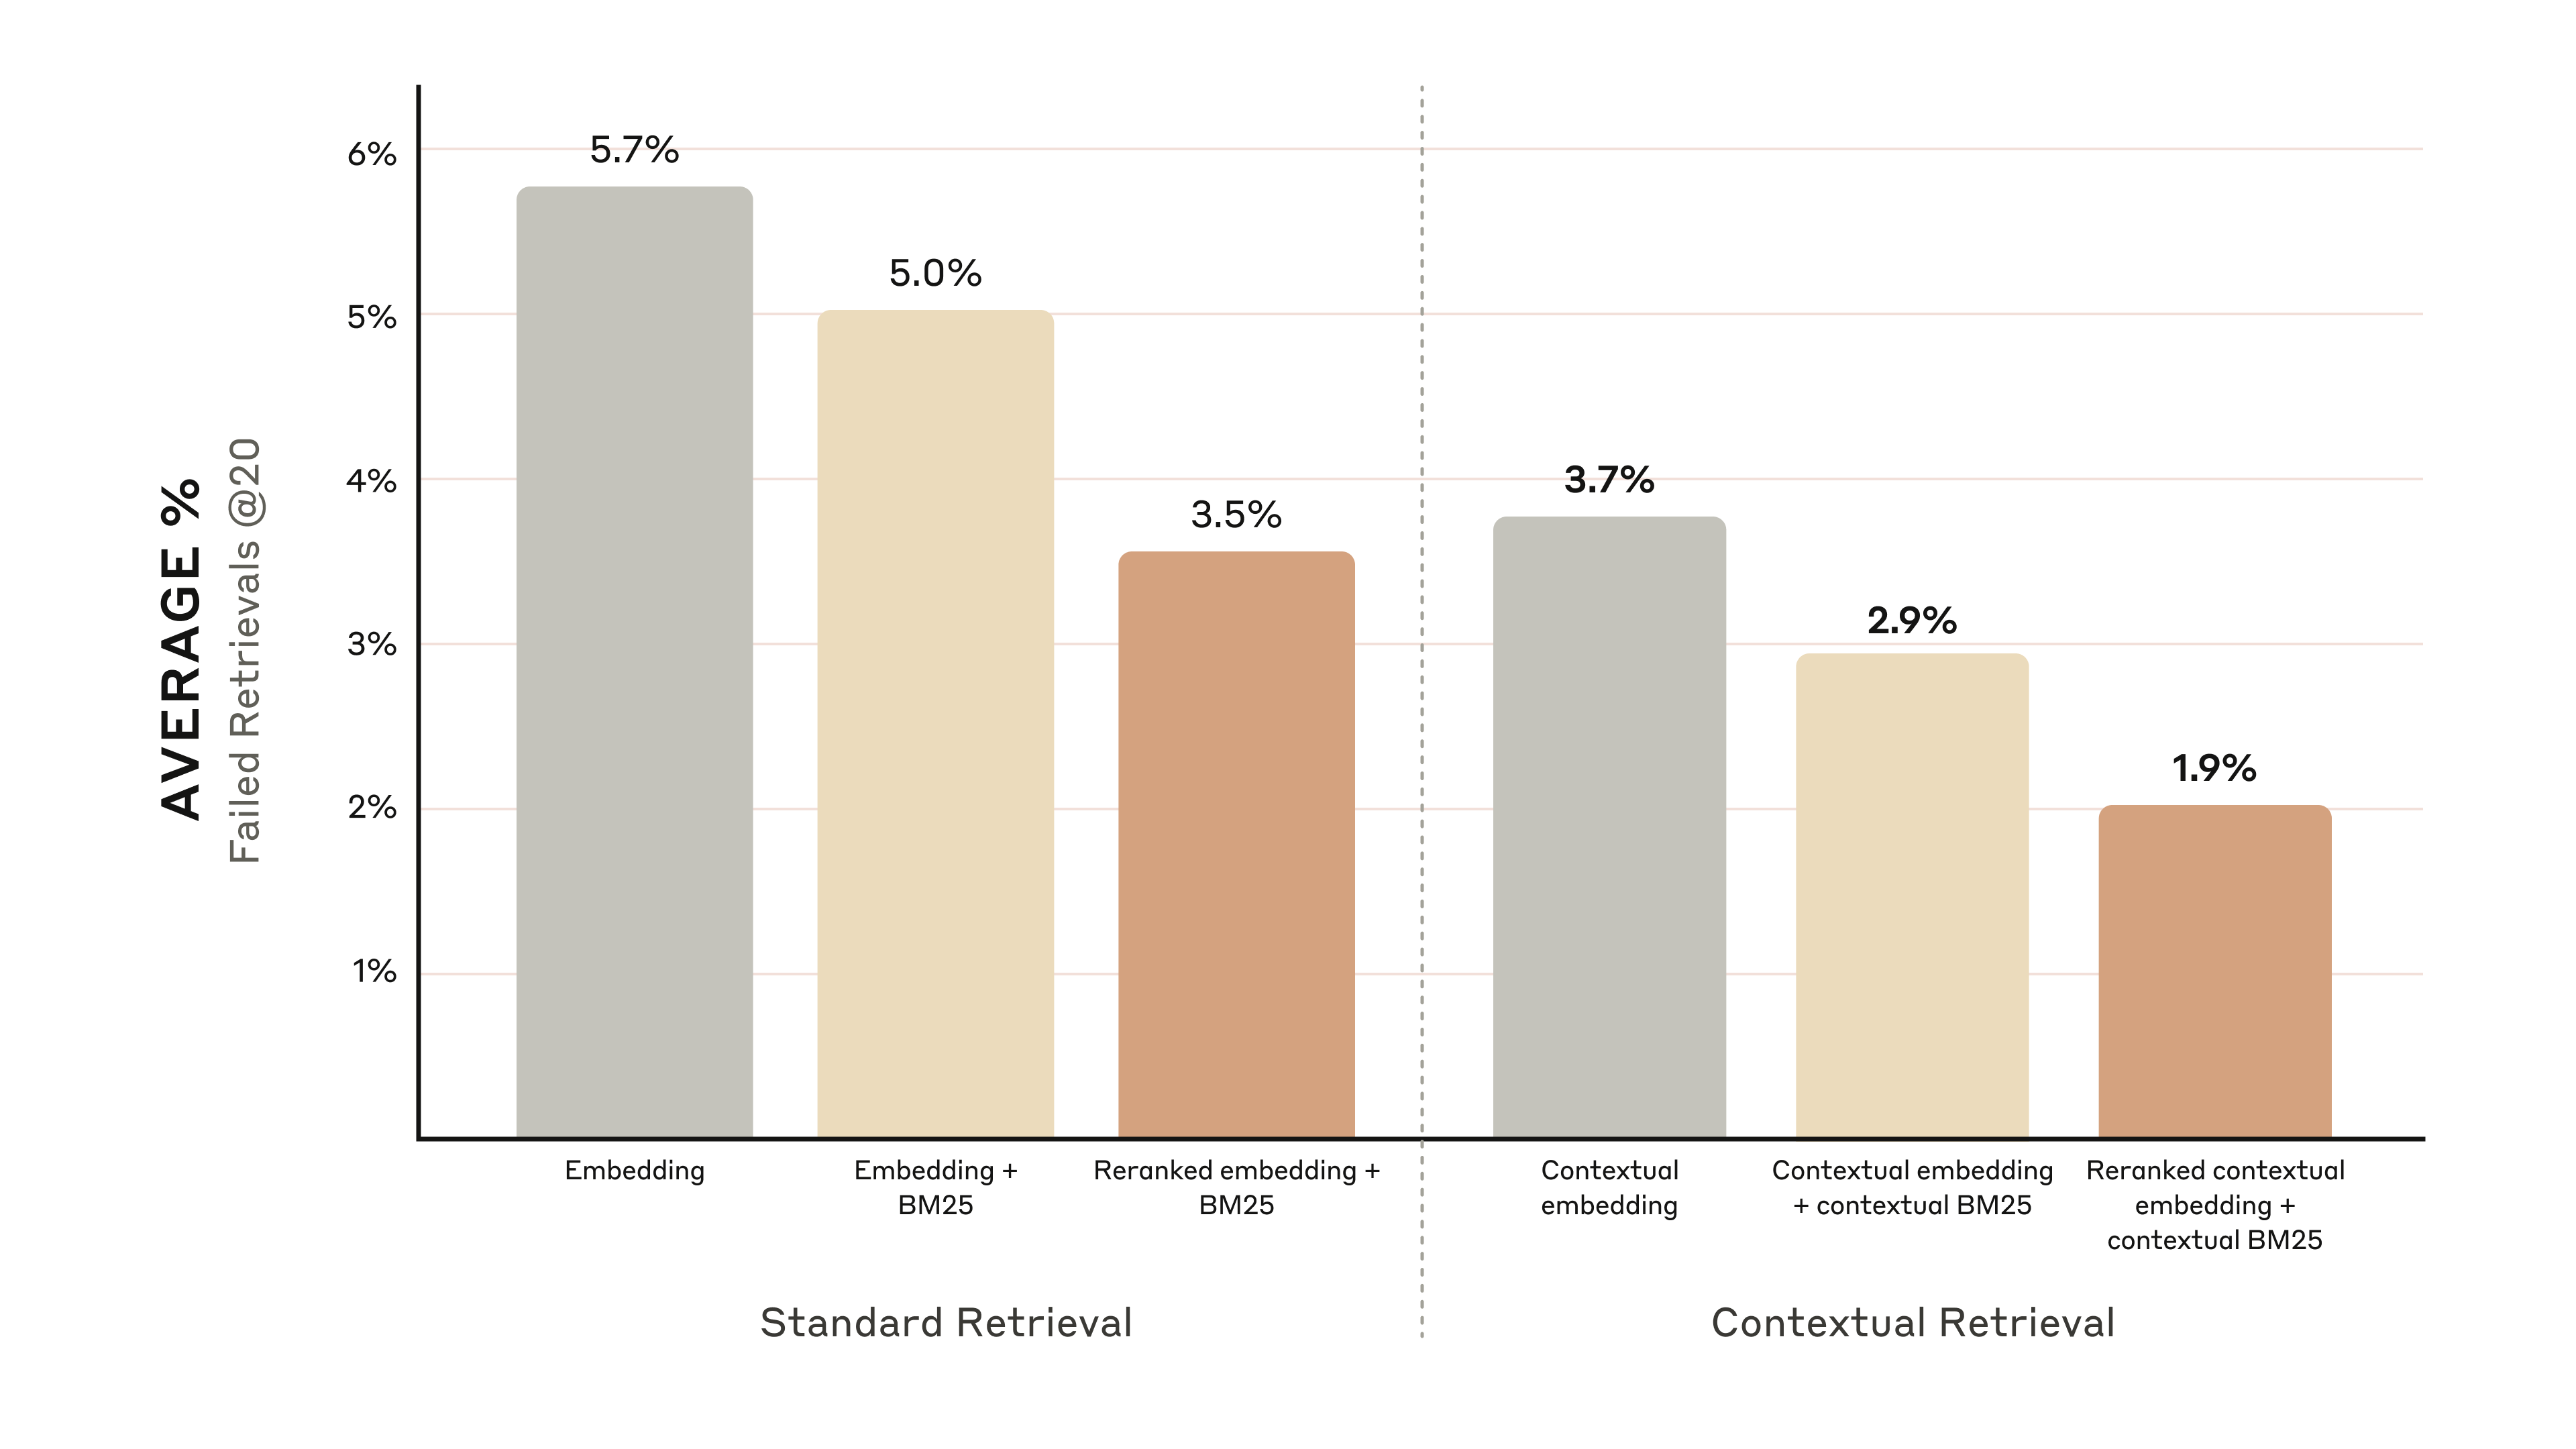
- 仅使用“上下文嵌入 (Contextual Embeddings)”可将前 20 个文本块的检索失败率降低 35%(从 5.7% 降至 3.7%)。
- 结合“上下文嵌入”和“上下文 BM25”,可将检索失败率降低 49%(从 5.7% 降至 2.9%)。
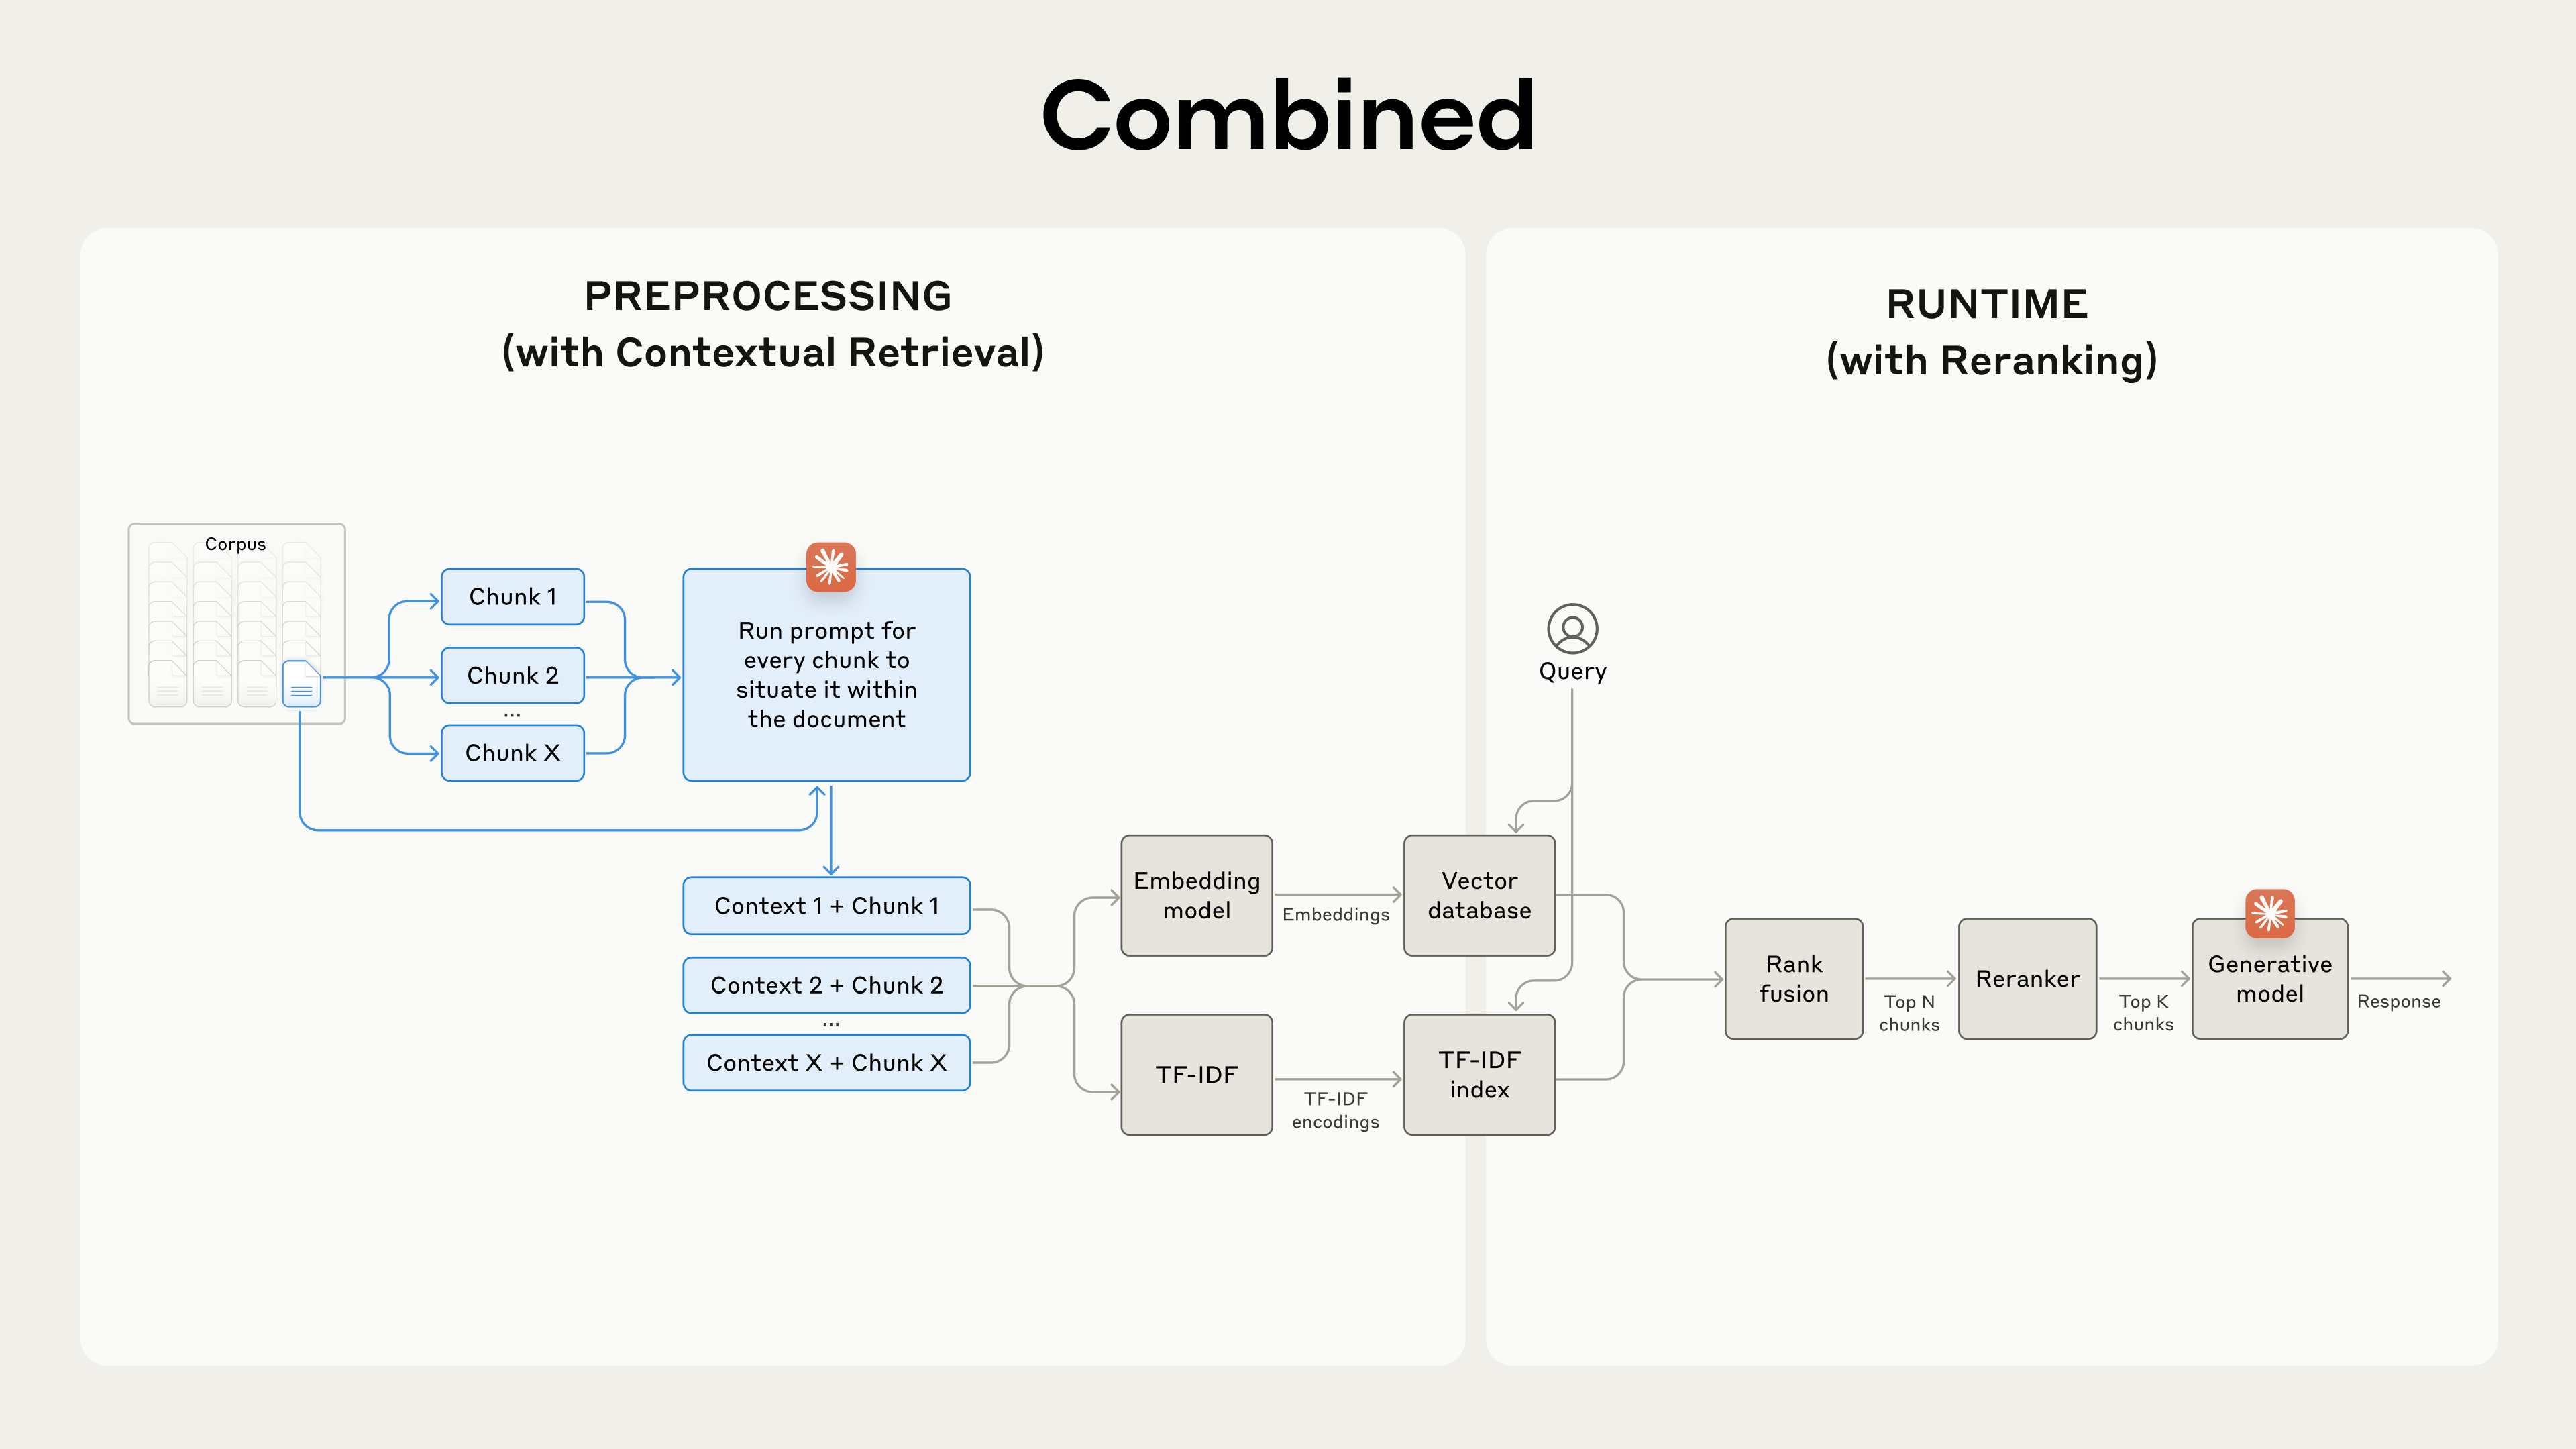
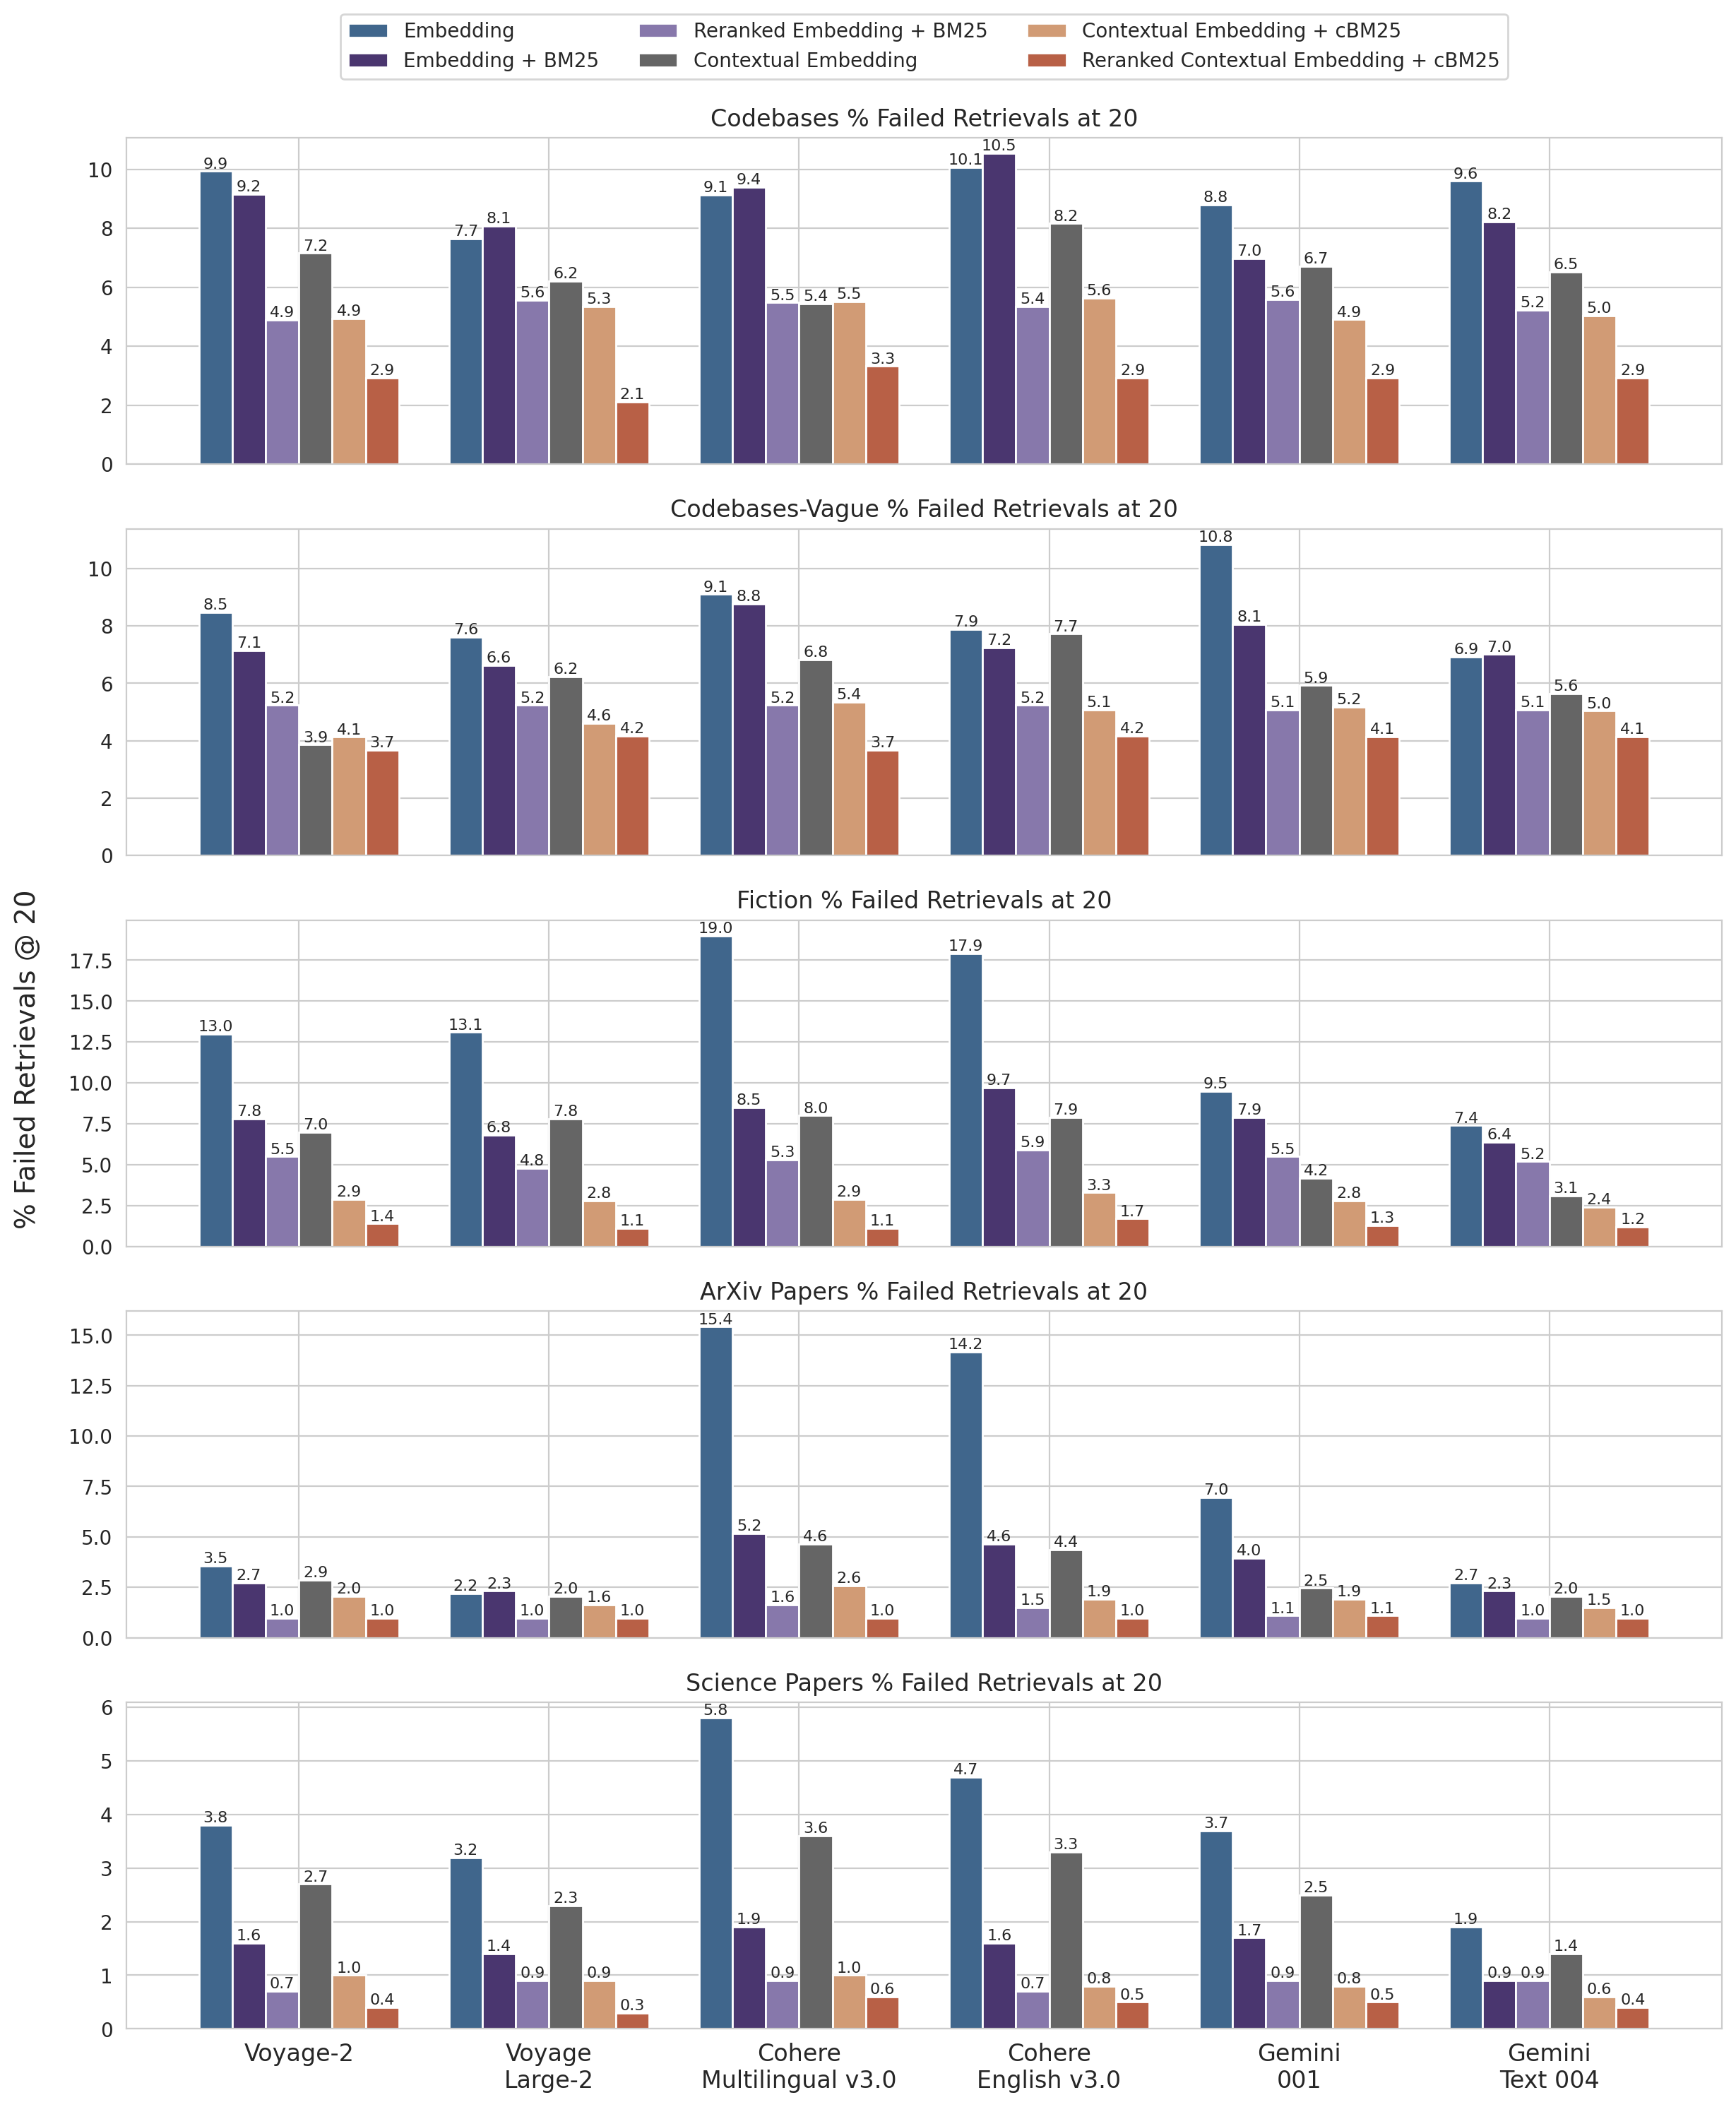
在实现该方案时,开发者还需要考虑如何切分边界,并选择优秀的嵌入模型(Anthropic 发现 Gemini 和 Voyage 表现最为出色)。同时,向模型提供 20 个上下文块已被证明是一个最有效的数字平衡。
结合重排 (Reranking) 进一步提升性能
在传统 RAG 中,为了确保模型处理最相关的信息并降低成本与延迟,通常会在检索之后加入一个重排步骤。
使用 Cohere 的重排模型进行的实验表明,结合“上下文嵌入”、“上下文 BM25”以及重排步骤,能使前 20 个文本块的检索失败率大幅下降 67%(从 5.7% 降至 1.9%)。
结论
在测试了众多参数和配置组合后,我们可以得出以下主要结论:
- Embeddings + BM25 的组合优于仅使用 Embeddings。
- Voyage 和 Gemini 的嵌入模型表现最好。
- 向大模型传递前 20 个检索结果的效果优于 10 个或 5 个。
- 为文本块添加上下文能大幅提升检索准确率。
- 引入重排 (Reranking) 总是比没有重排要好。
- 所有这些好处都是叠加的:将上下文嵌入、上下文 BM25 以及重排步骤结合使用,能最大程度释放系统的潜能。