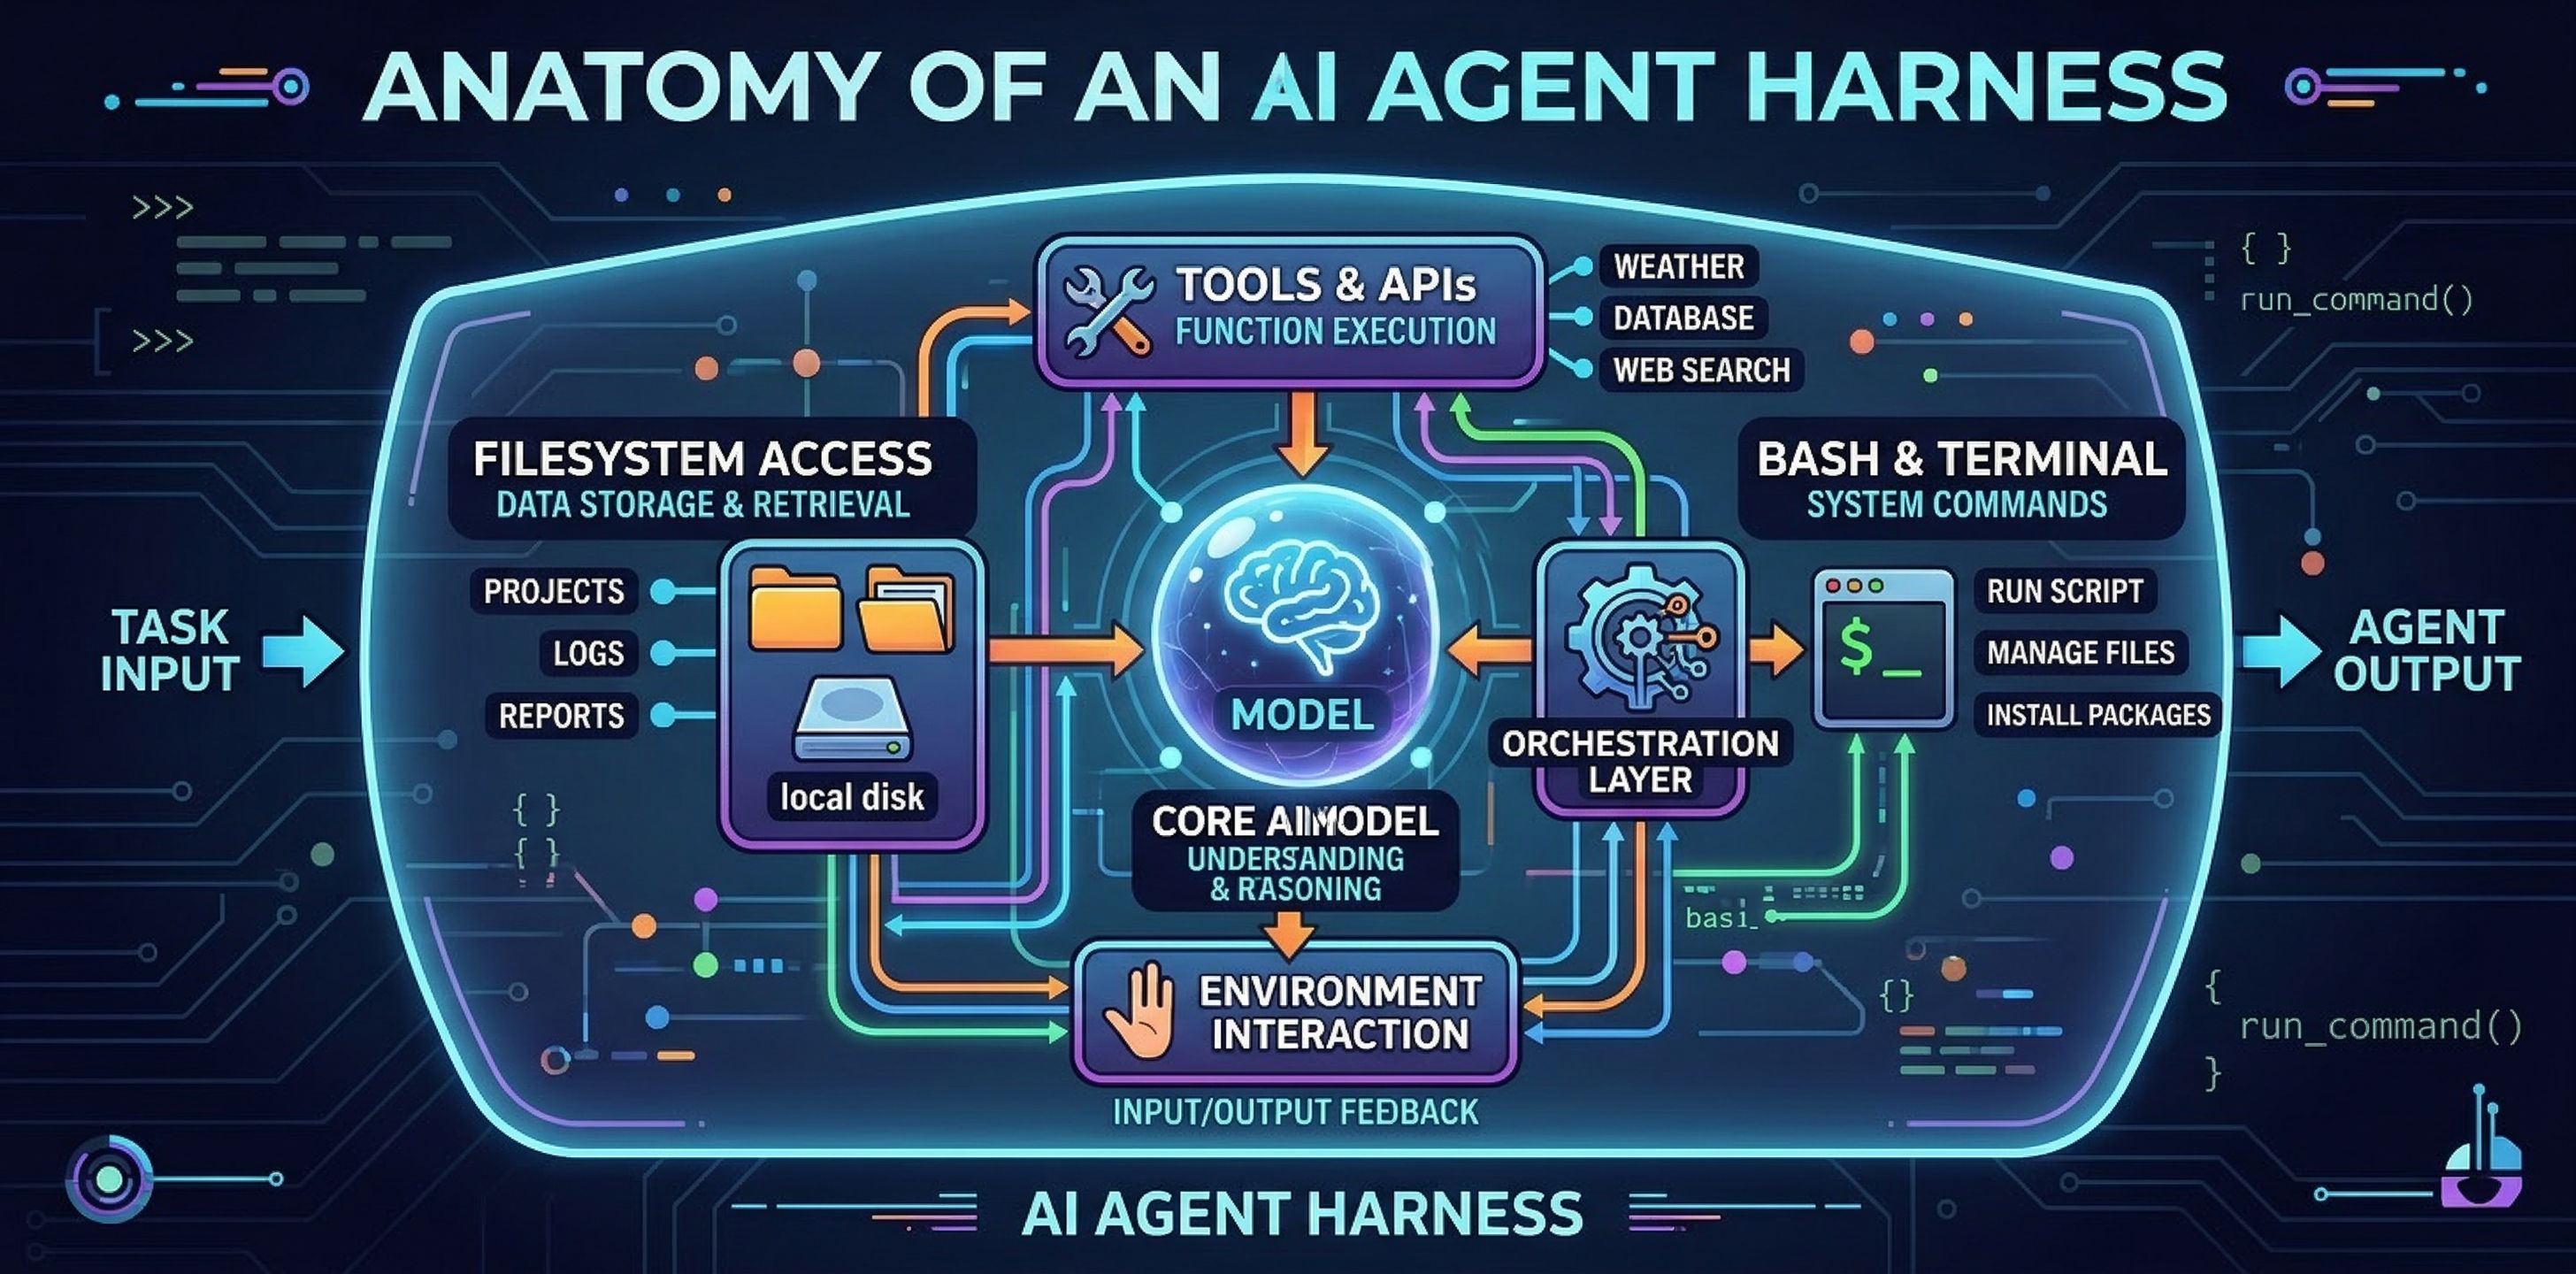
Agent Harness (智能体线束) 的剖析
快速阅读
核心观点:智能体 = 模型 + 线束(Harness)。 如果你不是模型,那你就是线束。线束工程探讨了我们如何围绕模型构建系统,将其转变为真正的工作引擎。模型包含智能,而线束则使这种智能变得实用。
线束是将原始大模型转化为智能体(Agent)的所有代码、配置和执行逻辑。它赋予模型状态、工具执行能力、反馈循环和强制约束等。具体组件包括:系统提示词(System Prompts)、工具/技能/MCPs、捆绑的基础设施(如沙盒、浏览器、文件系统),以及编排逻辑(子智能体生成、交接)和执行钩子(如上下文压缩、代码检查)。未来,随着模型能力增强,部分线束功能将被模型吸收,但线束工程在构建卓越智能体的过程中将持续发挥重要作用。
到底什么是“线束”(Harness)?
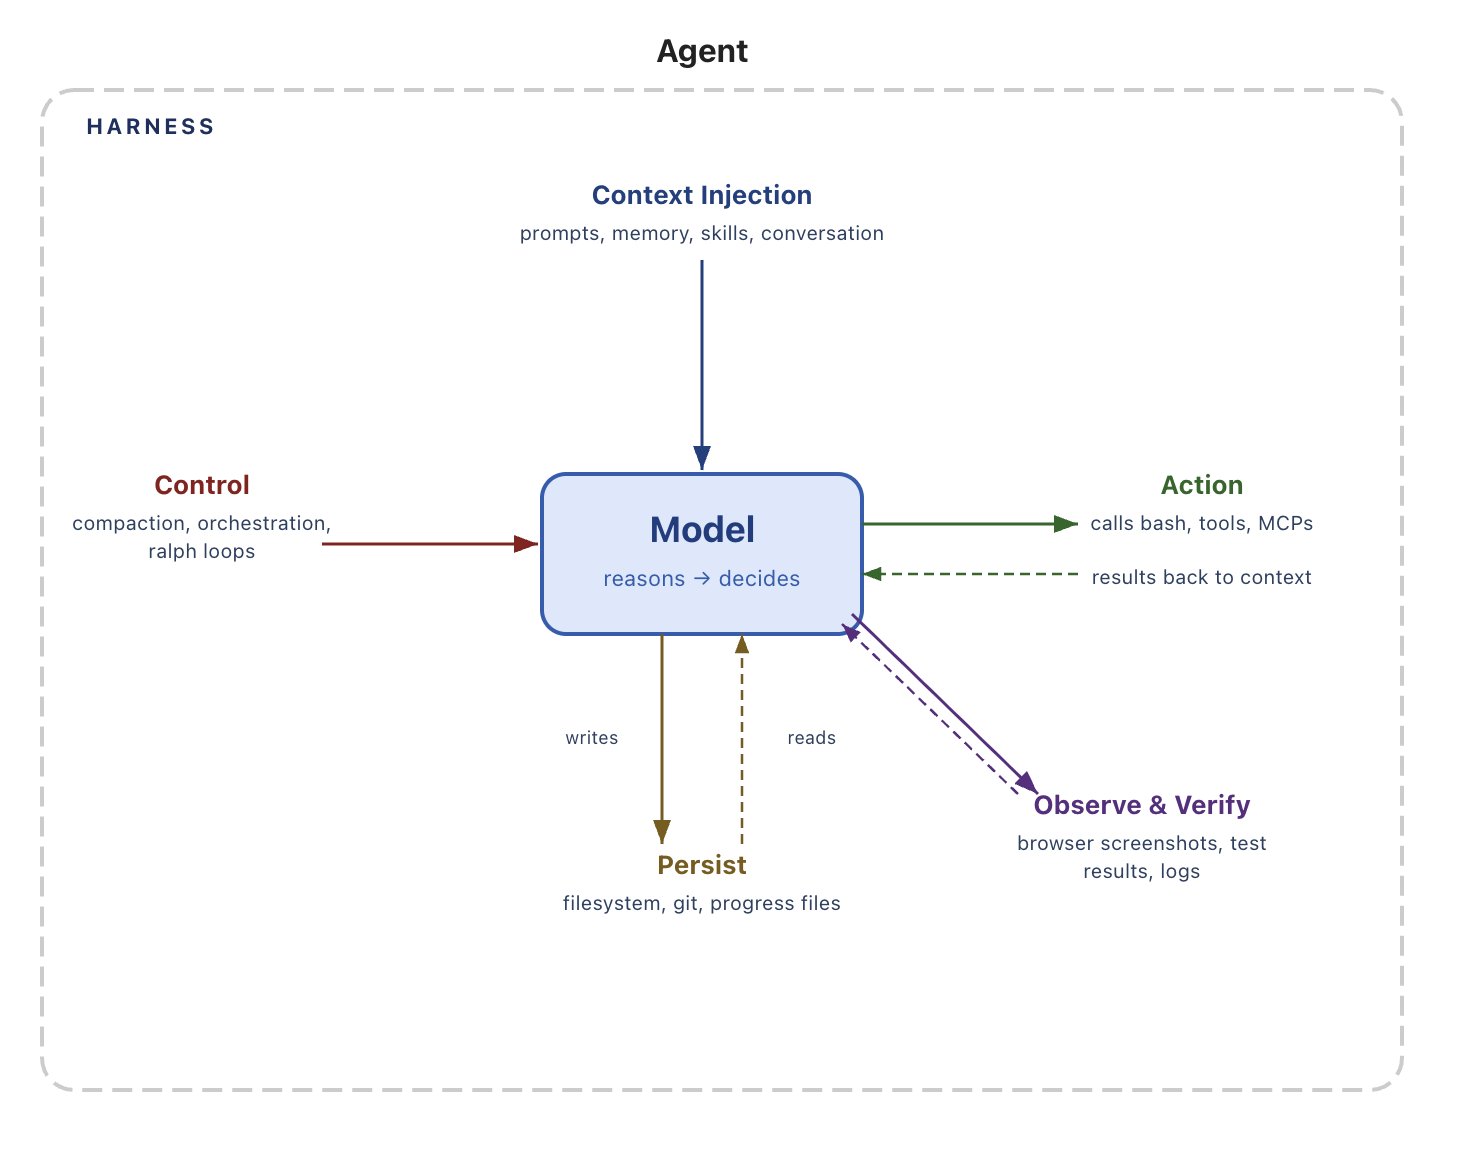
Agent = Model + Harness (智能体 = 模型 + 线束)
如果你不是模型本身,那你就是线束。线束指的是除模型之外的所有代码、配置和执行逻辑。一个原始的模型并不能称之为智能体;只有当线束为其提供了状态、工具执行、反馈循环和强制性约束时,它才真正成为一个智能体。
具体来说,线束包括但不限于以下内容:
- 系统提示词 (System Prompts)
- 工具、技能、MCPs 以及它们的描述
- 捆绑的基础设施(文件系统、沙盒、浏览器)
- 编排逻辑(子智能体生成、任务交接、模型路由)
- 用于确定性执行的钩子/中间件(上下文压缩、状态延续、代码检查)
在划分模型和线束的边界时,有很多模糊的处理方式。但笔者认为,这是最纯粹的一种定义,因为它迫使我们围绕“模型智能”来设计系统。
为什么我们需要线束……从模型的视角来看
有很多我们希望智能体完成的任务,是模型开箱即用无法做到的。这就是线束存在的意义。
大多数模型接收文本、图像、音频、视频等数据,然后输出文本。仅此而已。开箱即用状态下,它们无法:
- 在交互中维持持久化状态
- 执行代码
- 获取实时知识
- 设置环境并安装依赖包以完成工作
这些全都是线束层面的功能。大型语言模型(LLMs)的结构决定了它们需要某种“机械装置”来包裹,以便完成有用的工作。
举个例子,为了获得类似“聊天”的产品体验,我们将模型包裹在一个 while 循环中,以追踪历史消息并追加用户的新消息。读者们应该都体验过这种线束。核心思想是:我们希望将期望的智能体行为,转化为线束中的实际功能。
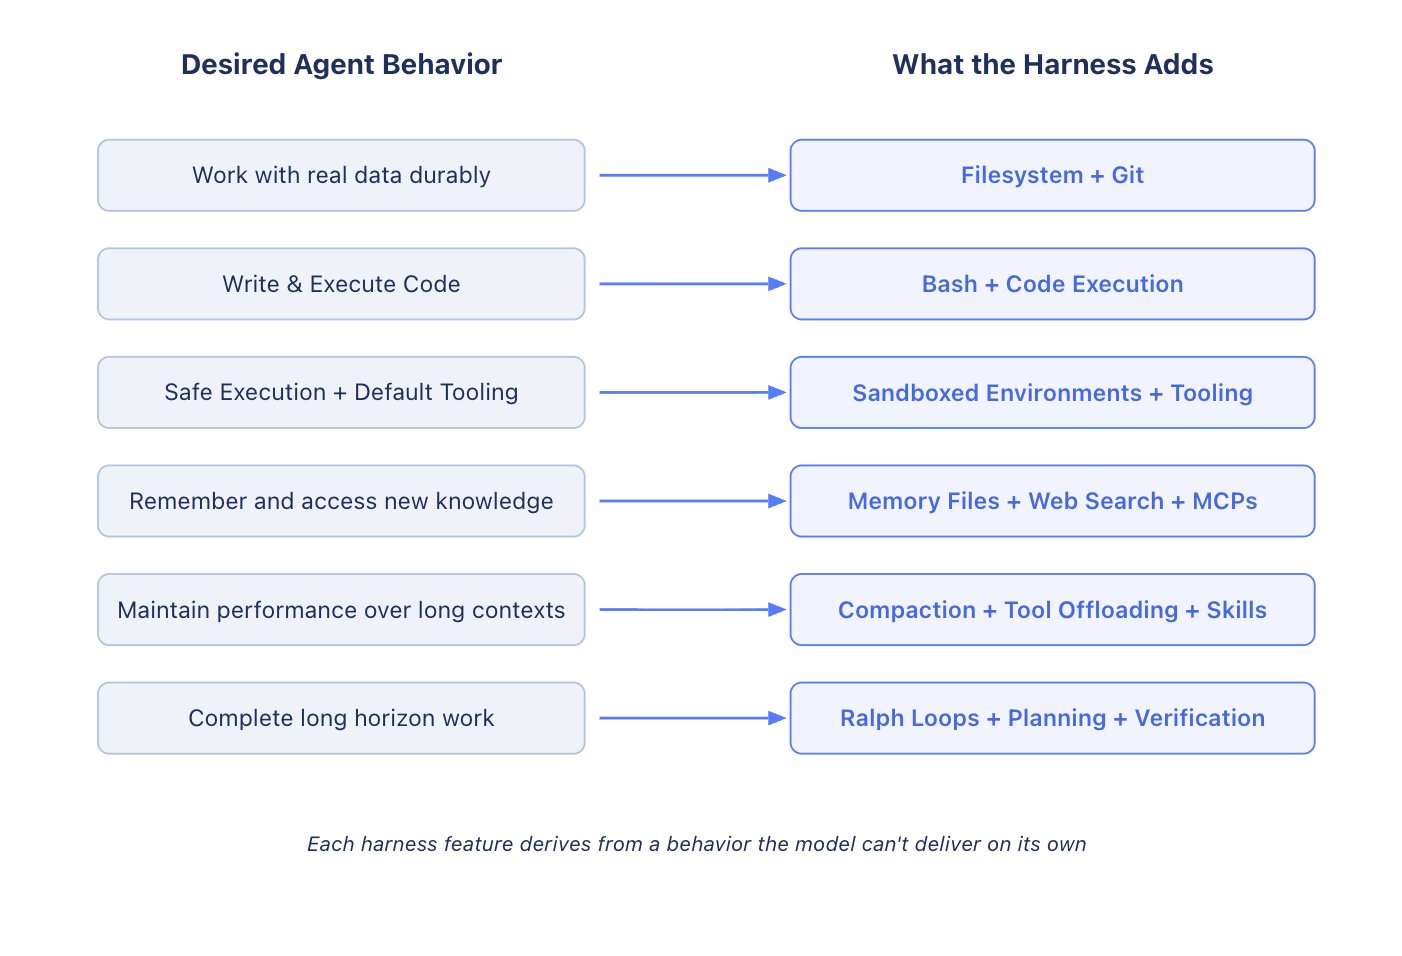
从期望行为逆推线束工程
线束工程帮助人类注入有用的先验知识,从而引导智能体行为。随着模型能力的增强,线束已被用于精准地扩展和纠正模型,去完成以前不可能完成的任务。
1. 用于持久化存储和上下文管理的文件系统
期望行为:我们希望智能体拥有持久化存储,以便与真实数据交互、卸载超出上下文的信息,并跨会话保留工作。
在文件系统引入之前,用户必须将内容直接复制粘贴给模型,这种体验很糟糕且不适合自治智能体。而全世界已经在广泛使用文件系统,模型自然也在数十亿的词元中学习过如何使用它。 线束设计:线束内置文件系统抽象,并提供文件操作工具。
文件系统可以说是最基础的线束原语:
- 智能体获得了一个工作区来读取数据、代码和文档。
- 任务可以逐步累加并卸载,无需把所有内容塞进上下文。
- 它为多智能体或人机协同提供了一个天然的协作界面。
- 结合 Git,智能体可以进行版本控制、回滚错误并进行分支实验。
2. Bash 与代码执行:通用工具
期望行为:我们希望智能体能够自主解决问题,而不需要人类预先设计好每一个工具。
当今主流的执行模式是 ReAct 循环(模型推理 -> 调用工具动作 -> 观察结果 -> 循环)。但线束只能执行它拥有逻辑的工具。与其让用户为每一个可能的操作构建工具,不如给智能体一个通用工具,比如 Bash。
线束设计:线束提供 bash 工具,让模型通过编写和执行代码自主解决问题。模型可以通过代码即时设计自己的工具,而不是受限于一组固定的预配置工具。
3. 用于执行与验证的沙盒和工具
期望行为:智能体需要一个具有合理默认值的环境,以便它们安全地执行动作、观察结果并取得进展。
在本地运行智能体生成的代码是危险的。沙盒为智能体提供了安全的运行环境,线束可以连接到沙盒来运行代码、检查文件、安装依赖。沙盒还解锁了扩展性,环境可以按需创建。
同时,好的环境需要配备好的工具(如浏览器、日志、截图、测试运行器),让智能体能够观察和分析自己的工作。它们建立起自我验证循环:编写代码、运行测试、检查日志、修复错误。
4. 用于持续学习的记忆与搜索
期望行为:智能体应该记住它们所见过的内容,并能访问它们被训练后产生的新信息。
线束设计:对于记忆,线束支持像 AGENTS.md 这样的记忆文件标准,这些文件在智能体启动时会被注入到上下文中,实现持续学习。对于更新的知识,网络搜索和像 MCP (Model Context Protocol) 这样的工具可以帮助智能体访问截断日期之后的信息(例如新版库或实时数据)。
5. 对抗上下文腐烂 (Context Rot)
期望行为:智能体的性能不应该随着工作推进而下降。
上下文腐烂描述的是模型在上下文窗口逐渐填满时,其推理和完成任务的能力会下降。线束需要策略来管理这个宝贵的资源:
- 压缩 (Compaction):当上下文快满时,线束会智能卸载并总结现有的上下文。
- 工具调用卸载:对冗长的工具输出进行截断,将完整内容保存到文件系统中。
- 技能的渐进式呈现:防止过多的工具一次性注入导致性能下降。
6. 长周期的自主执行
期望行为:我们希望智能体能够自主地、正确地、在长时间跨度内完成复杂工作。
由于存在提前停止、难以分解复杂问题和跨上下文时出现的不连贯等问题,长周期任务对模型是个挑战。线束中的基础原语在这里产生了复利效应:
- 追踪工作:文件系统加上 Git 可以帮助跨会话追踪长任务。
- Ralph 循环:一种线束模式,它通过钩子拦截模型退出的尝试,并在干净的上下文中重新注入原始提示,强迫智能体继续工作直到达成目标。
- 规划与自我验证:线束支持通过提示模型并引导其使用文件系统中的规划文件来分解目标,并通过运行测试套件来进行自我纠正。
线束的未来
模型训练与线束设计的耦合
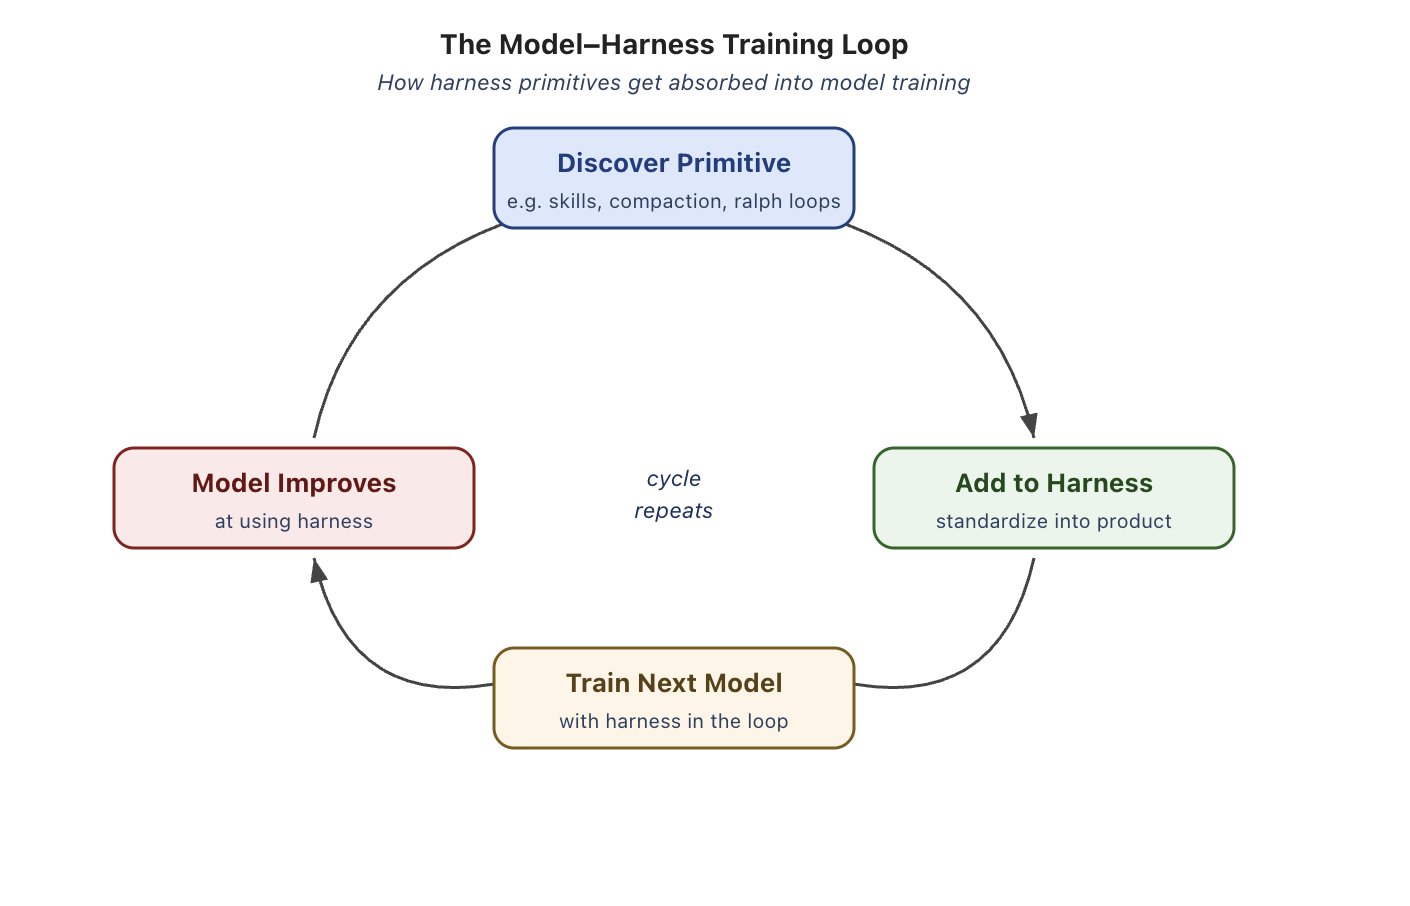
当今如 Claude Code 和 Codex 等智能体产品都在循环中引入了线束进行后训练。这产生了一个反馈循环:发现有用的原语 -> 加入线束 -> 用于训练下一代模型。
但这对于模型的泛化能力会产生有趣的副作用(即对特定线束过拟合)。这说明最适合你任务的线束未必是模型后训练时用的那个。在针对特定任务进行优化时,线束工程依然存在巨大的潜力。
线束工程的走向
随着模型能力的提高,当前存在于线束中的某些功能(如原生规划、自我验证和长周期连贯性)将会被模型自身吸收。
这是否意味着线束会变得不重要?恰恰相反。就像提示词工程(Prompt Engineering)在今天依然极具价值一样,线束工程将继续是构建卓越智能体的关键。线束在今天不仅是为了修补模型的缺陷,更是为了围绕模型智能进行系统工程化。一个配置良好的环境、恰当的工具、持久化的状态以及验证循环,将使任何模型都变得更加高效。
目前线束工程中仍有许多有趣的开放性问题值得探索:
- 协调数百个智能体在共享代码库上并行工作。
- 智能体能够分析自己的执行轨迹以识别并修复线束级别的故障。
- 线束根据给定任务“即时”(Just-in-time)动态组装工具和上下文,而非预先静态配置。
模型包含了智能,而线束才是使这种智能变得实用的系统。敬更好的线束,更好的系统,更好的智能体!