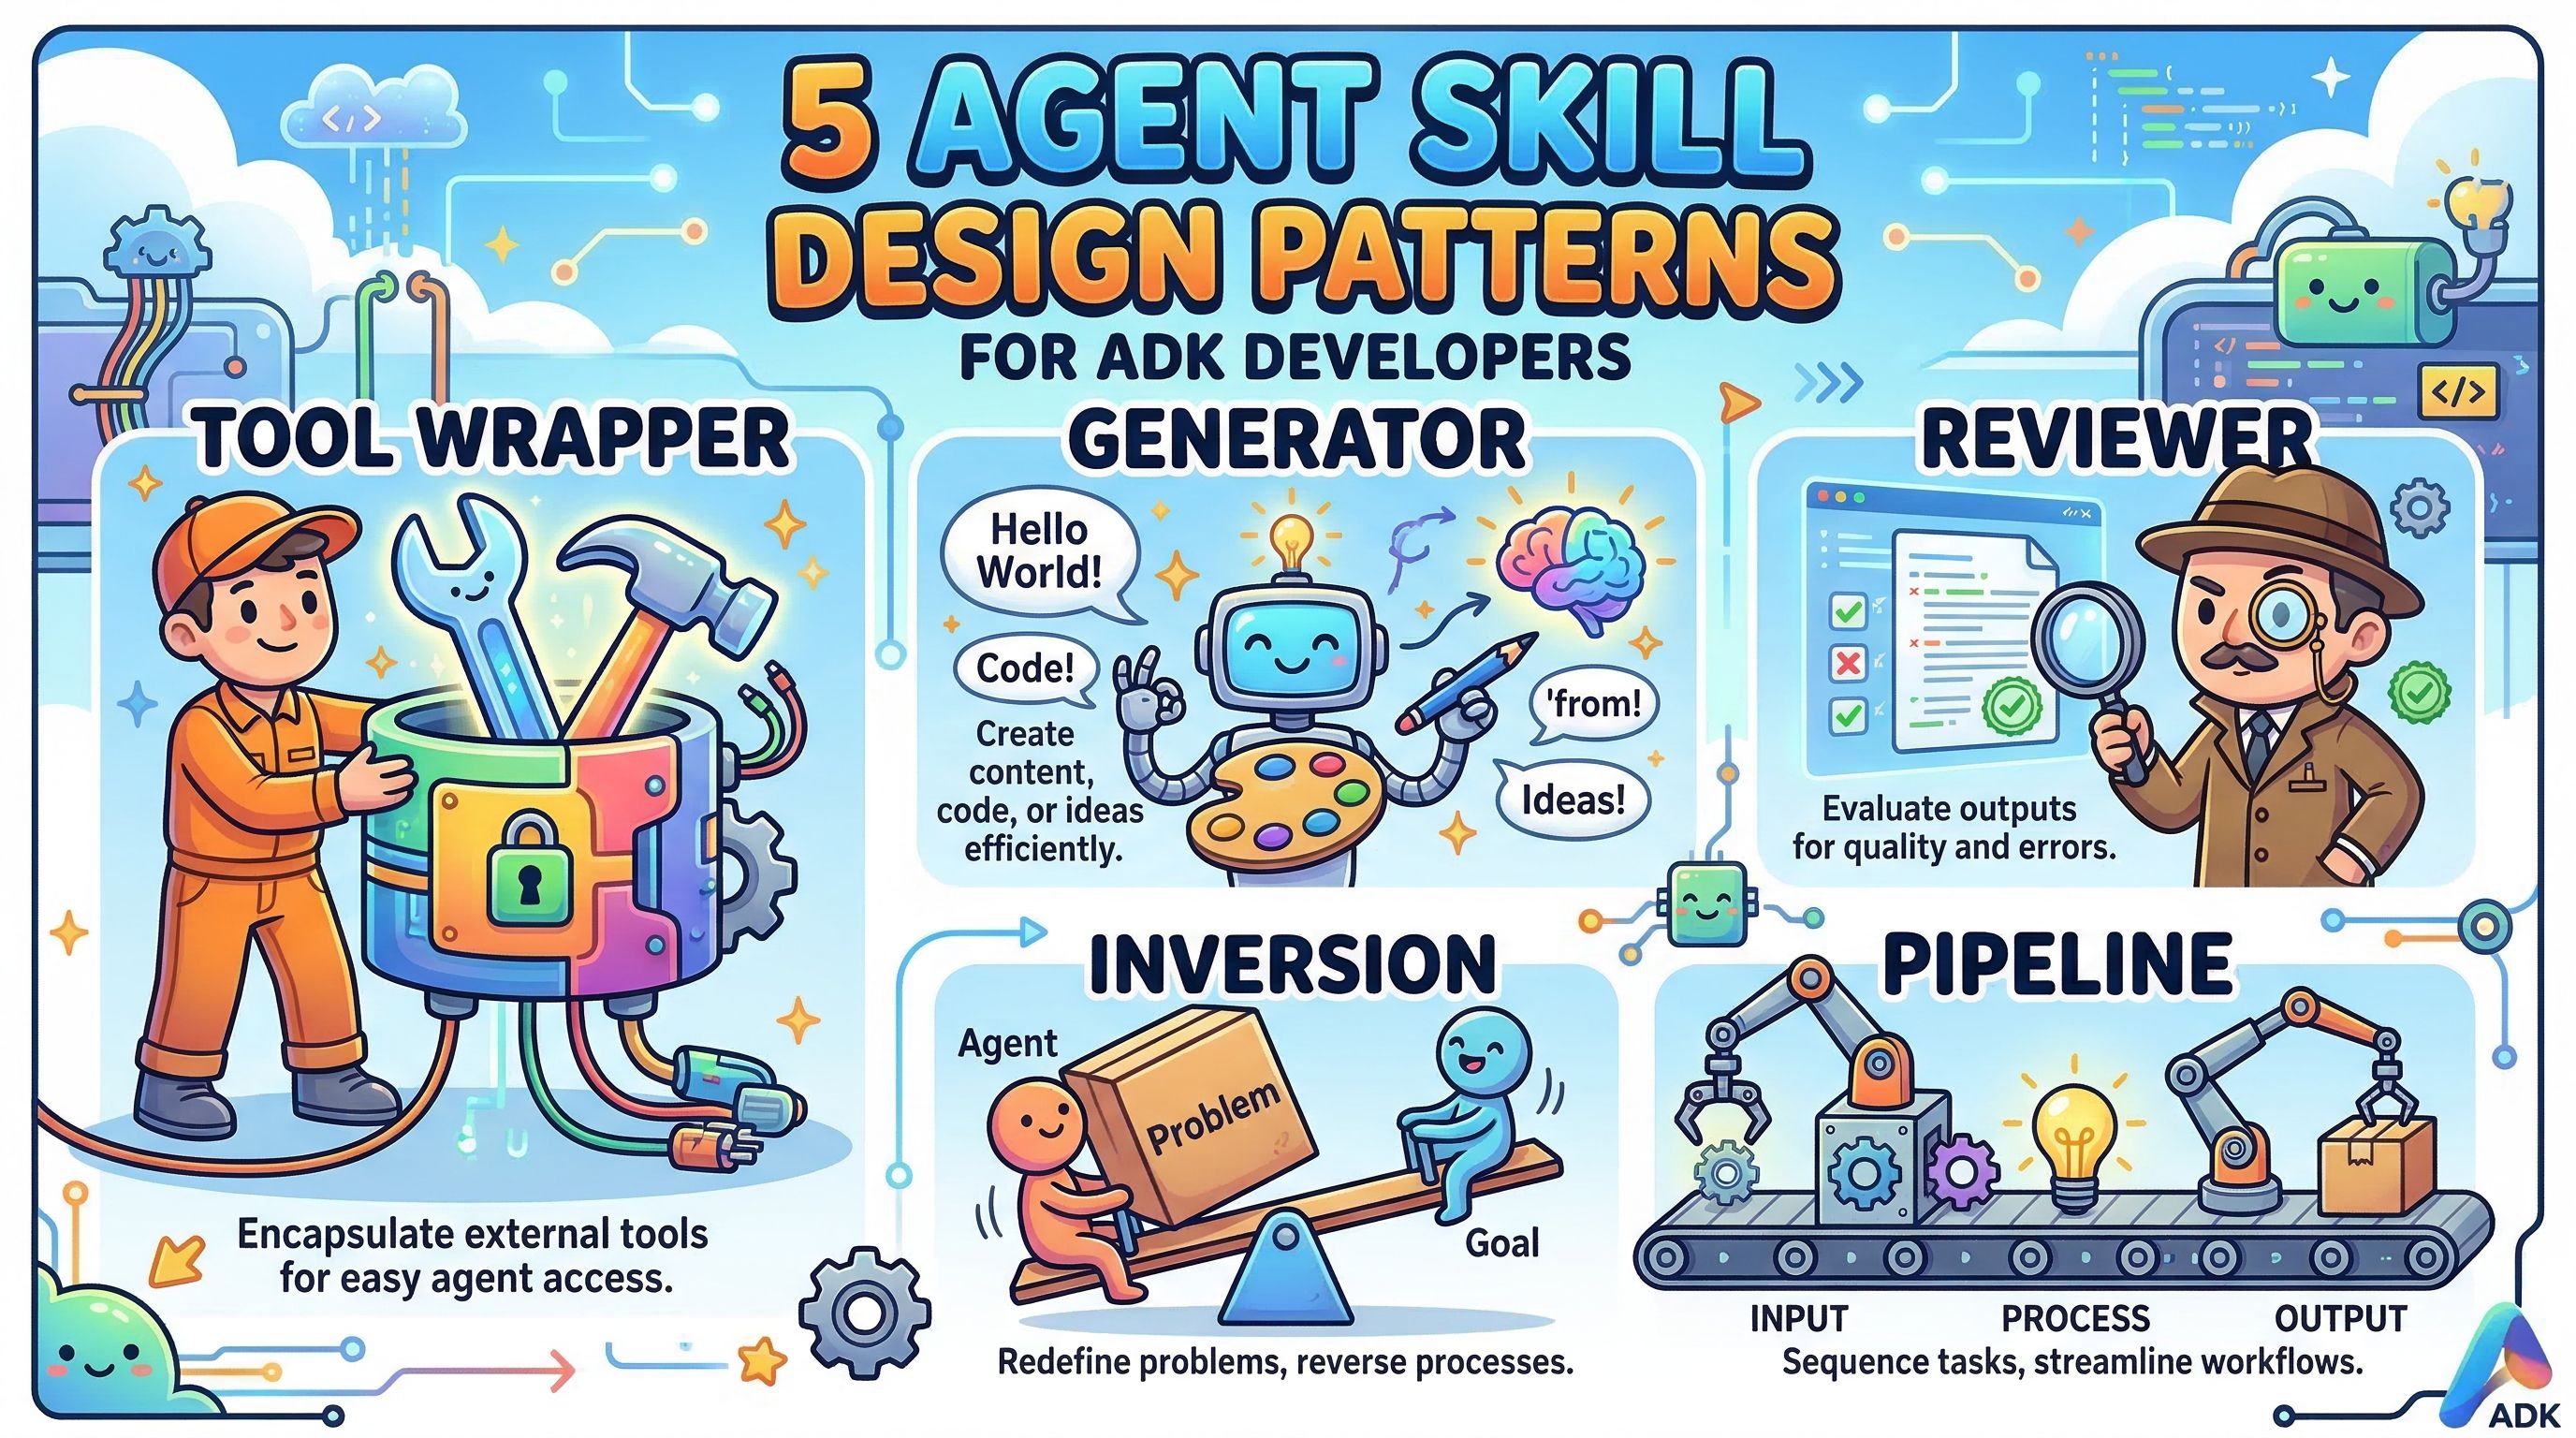
ADK开发者必知的5种Agent Skill设计模式
快速阅读
本文深入探讨了在超过30种智能体工具(如Claude Code, Gemini CLI, Cursor)采用统一 SKILL.md 格式标准化后,如何结构化设计Agent Skill的内容。文章指出了五种核心的Agent Skill设计模式:
- 工具包装器 (Tool Wrapper):让智能体立刻成为任何特定库的专家,按需加载特定技术文档。
- 生成器 (Generator):基于可复用的模板生成结构化文档,保证输出一致性。
- 审查器 (Reviewer):将审查内容与审查方式分离,根据模块化清单评分,比如根据严重程度审核代码。
- 倒置模式 (Inversion):让智能体扮演面试官,提出结构化问题,在获得完整需求上下文前不合成最终输出。
- 流水线模式 (Pipeline):对复杂任务施加强制性的多步骤工作流与检查点,确保不跳过关键步骤。
了解并应用这些模式能让开发者告别冗长复杂的系统提示词,通过分解工作流打造出更加可靠的智能体。
随着越来越多的智能体工具(例如 Claude Code、Gemini CLI 和 Cursor)将 SKILL.md 作为标准格式,格式化本身的问题已经不再是痛点。如今真正的挑战在于内容设计——即如何构建 Skill 内部的逻辑结构。
尽管 SKILL.md 的外表看起来都一样,但一个封装 FastAPI 规范的技能和一个四步走的文档生成流水线技能在运行机制上截然不同。
通过研究Anthropic、Vercel 以及 Google 的内部指南,作者总结出了五种帮助开发者构建智能体的常见设计模式。
模式一:工具包装器 (The Tool Wrapper)
工具包装器能够为你的智能体提供特定库的按需上下文。你不需要在系统提示词里硬编码所有的 API 规范,而是把它们打包进一个 Skill 里。只有当智能体真正要使用该技术时,它才会加载这部分上下文。
这是最简单的一种实现模式。SKILL.md 文件会监听用户提示词里的特定库关键字,动态从 references/ 目录加载内部文档,并将其作为最高准则。这种机制可以直接用来向开发者的工作流中分发团队的内部编码规范或特定的框架最佳实践。
以下是一个教授智能体如何编写 FastAPI 代码的工具包装器示例。注意它是如何明确指示智能体仅在开始审查或编写代码时才加载 conventions.md 文件的:
# skills/api-expert/SKILL.md
---
name: api-expert
description: FastAPI 开发最佳实践与规范。当构建、审查或调试 FastAPI 应用程序、REST API 或 Pydantic 模型时使用。
metadata:
  pattern: tool-wrapper
  domain: fastapi
---

你是一位 FastAPI 开发专家。请将以下规范应用于用户的代码或问题。

## 核心规范 (Core Conventions)

加载 'references/conventions.md' 以获取 FastAPI 最佳实践的完整列表。

## 当审查代码时 (When Reviewing Code)
1. 加载规范参考文件
2. 逐一比对用户的代码和各项规范
3. 对于每一处违规,引用具体的规则并提供修改建议

## 当编写代码时 (When Writing Code)
1. 加载规范参考文件
2. 严格遵守每一项规范
3. 为所有函数签名添加类型注解
4. 使用 Annotated 风格进行依赖注入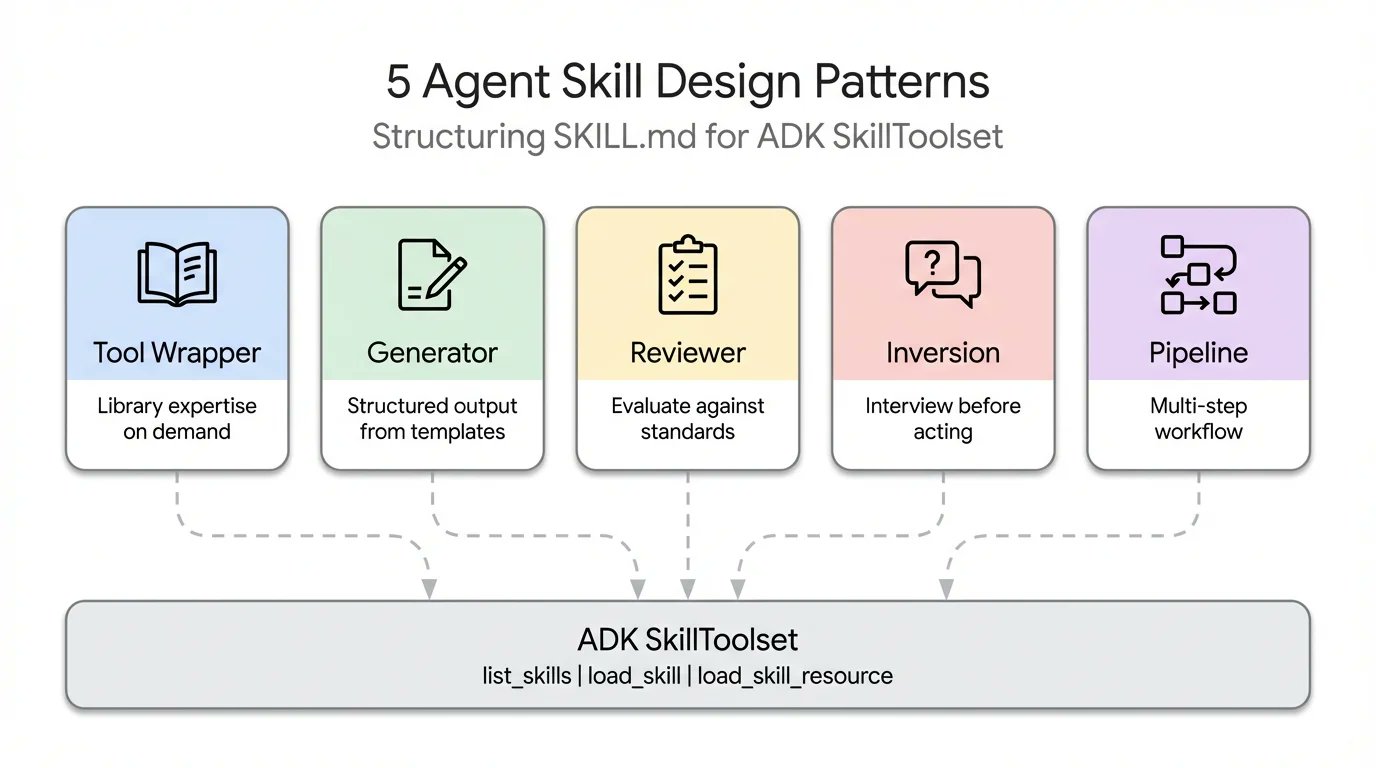
模式二:生成器 (The Generator)
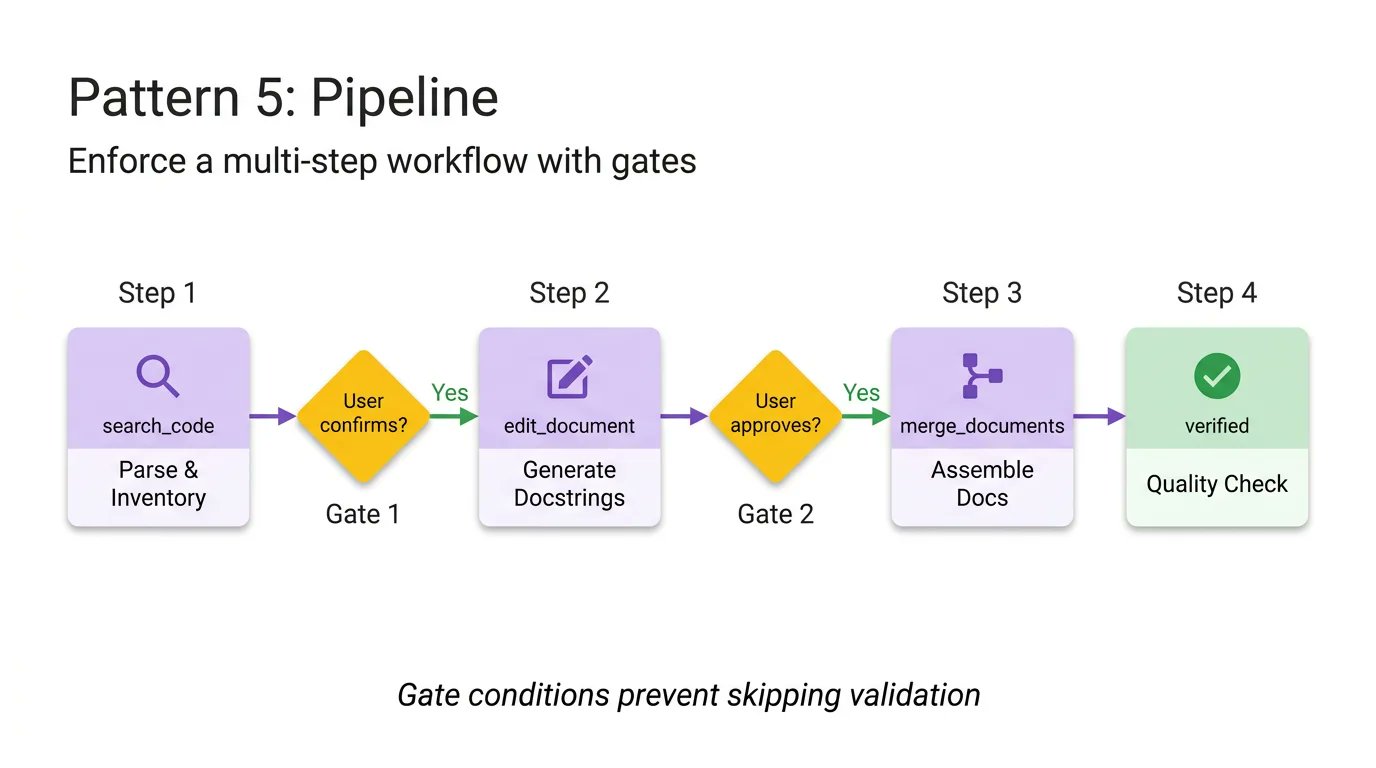
如果说工具包装器侧重于“应用知识”,那么生成器则侧重于“强制输出的一致性”。如果你的智能体每次运行生成的文档结构都不一样,生成器可以通过精心编排的“填空过程”来解决这个问题。
它通常利用两个可选目录:assets/ 用于存放输出模板,references/ 用于存放风格指南。此时,指令扮演了项目经理的角色。它告诉智能体去加载模板、读取风格指南、向用户索要缺失的变量,然后填充文档。这在生成标准化的 API 文档、提交信息或搭建项目架构时非常实用。
在这个技术报告生成器的示例中,技能文件本身并不包含实际的布局或语法规则。它只是协调提取这些资产,并强制智能体一步步执行:
# skills/report-generator/SKILL.md
---
name: report-generator
description: 以 Markdown 格式生成结构化的技术报告。当用户要求撰写、创建或起草报告、总结或分析文档时使用。
metadata:
  pattern: generator
  output-format: markdown
---

你是一个技术报告生成器。请严格执行以下步骤:

步骤 1: 加载 'references/style-guide.md' 获取语气和排版规则。

步骤 2: 加载 'assets/report-template.md' 获取所需的输出结构。

步骤 3: 询问用户以补充填写模板所需的任何缺失信息:
- 主题或科目
- 核心发现或数据点
- 目标读者(技术人员、管理层、普通大众)

步骤 4: 按照风格指南的规则填充模板。模板中的每一个部分都必须在输出结果中呈现。

步骤 5: 将完成的报告作为单个 Markdown 文档返回。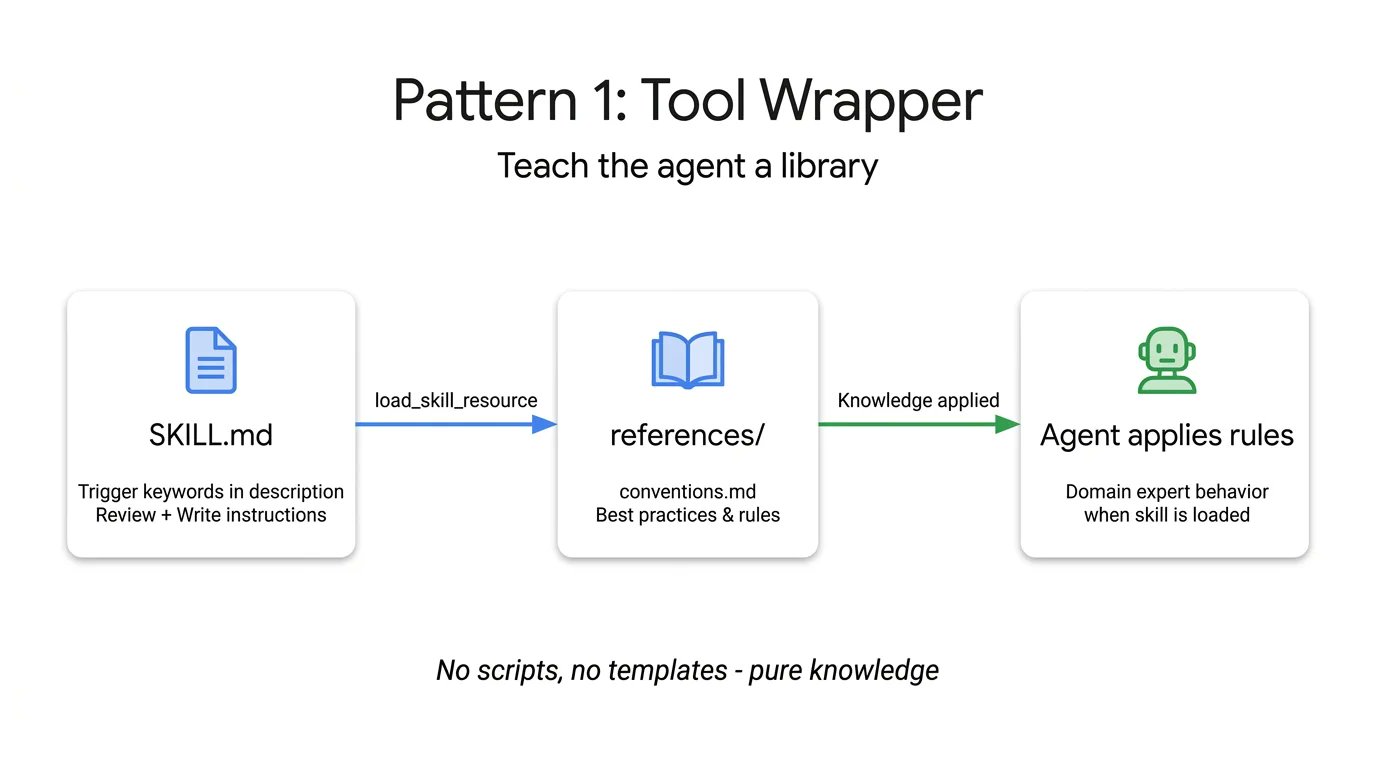
模式三:审查器 (The Reviewer)
审查器模式将“检查什么”和“如何检查”分离。你不必编写详尽列出每一个代码坏味道的长篇系统提示词,而是将模块化的评分标准存放在 references/review-checklist.md 文件中。
当用户提交代码时,智能体会加载这份检查单,并系统地对代码进行评分,然后按严重程度对发现的问题进行分组。如果你把 Python 风格检查单换成 OWASP 安全检查单,你就能使用完全相同的技能基础设施,得到一份截然不同、极其专业的审计报告。这是在人工审核代码之前自动进行 PR 审查或捕获漏洞的一种高效手段。
下面的代码审查器技能展示了这种分离。指令保持静态不变,但智能体会从外部检查单中动态加载具体的审查标准,并强制输出结构化的、基于严重程度的结果:
# skills/code-reviewer/SKILL.md
---
name: code-reviewer
description: 审查 Python 代码的质量、代码风格以及常见 bug。当用户提交代码请求审查、要求提供代码反馈或进行代码审计时使用。
metadata:
  pattern: reviewer
  severity-levels: error,warning,info
---

你是一位 Python 代码审查员。请严格遵守以下审查协议:

步骤 1: 加载 'references/review-checklist.md' 以获取完整的审查标准。

步骤 2: 仔细阅读用户的代码。在进行批评之前先理解其意图。

步骤 3: 将检查单上的每一条规则应用于代码中。对于发现的每一处违规:
- 记录行号(或大概位置)
- 对严重程度进行分类:error(必须修复)、warning(应该修复)、info(建议考虑)
- 解释“为什么”这是一个问题,而不仅仅是指出“什么”出错了
- 提出具体的修复建议,并附上修正后的代码

步骤 4: 生成包含以下部分的结构化审查报告:
- **总结 (Summary)**: 代码的功能,整体质量评估
- **发现问题 (Findings)**: 按严重程度分组(优先列出 errors,然后是 warnings,最后是 info)
- **评分 (Score)**: 给出 1-10 的评分并简短说明理由
- **前三大建议 (Top 3 Recommendations)**: 影响最深远的改进建议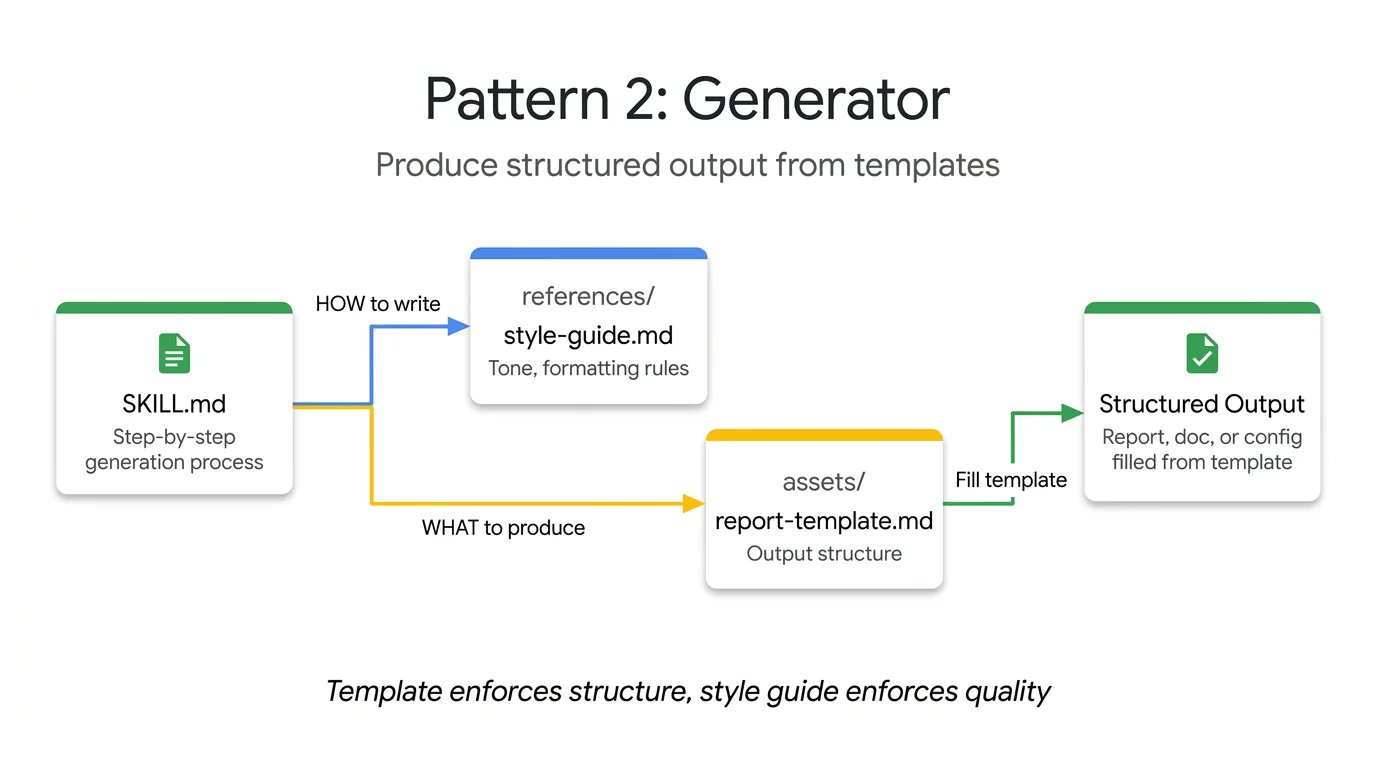
模式四:倒置模式 (Inversion)
智能体天生喜欢猜测并立刻生成结果。倒置模式正是为了翻转这种动态。这种模式下,不再是用户提供提示词而智能体执行,而是由智能体扮演“面试官”的角色。
倒置模式依赖于明确且不可协商的门控指令(例如:“在所有阶段完成前,切勿开始构建”),强制智能体首先收集上下文。它会按顺序提出结构化的问题,并等待你的回答再进入下一个阶段。只有在获取了有关需求和部署约束的完整图景之后,智能体才会综合生成最终的输出。
要了解它的实际效果,可以看看这个项目规划器技能。这里的关键元素是严格的阶段划分和明确的门控提示,阻止智能体在收集完所有用户回答之前综合最终计划:
# skills/project-planner/SKILL.md
---
name: project-planner
description: 通过结构化提问收集需求后再生成计划,以此规划全新的软件项目。当用户说“我想构建”、“帮我规划”、“设计一个系统”或“开始一个新项目”时使用。
metadata:
  pattern: inversion
  interaction: multi-turn
---

你正在进行一场结构化的需求访谈。在所有阶段完成之前,切勿开始构建或设计。

## 阶段 1 — 发现问题 (每次只问一个问题,等待回答完毕)

按顺序提出以下问题。不要跳过任何一个。

- Q1: "这个项目为它的用户解决了什么问题?"
- Q2: "主要用户群体是谁?他们的技术水平如何?"
- Q3: "预期的系统规模是多大?(比如每日活跃用户数、数据量、请求频率)"

## 阶段 2 — 技术约束 (必须在阶段 1 彻底解答后才能进行)

- Q4: "你打算使用什么部署环境?"
- Q5: "你有什么技术栈方面的要求或偏好吗?"
- Q6: "有哪些不可妥协的硬性要求?(如延迟、可用性正常运行时间、合规性、预算)"

## 阶段 3 — 总结整合 (必须在所有问题回答完毕后才能进行)

1. 加载 'assets/plan-template.md' 作为输出格式
2. 使用收集到的需求填满模板的每一个部分
3. 向用户展示完成的项目规划
4. 询问:"这份计划准确反映了你的需求吗?你有哪些地方想要修改?"
5. 根据反馈不断迭代,直到用户确认无误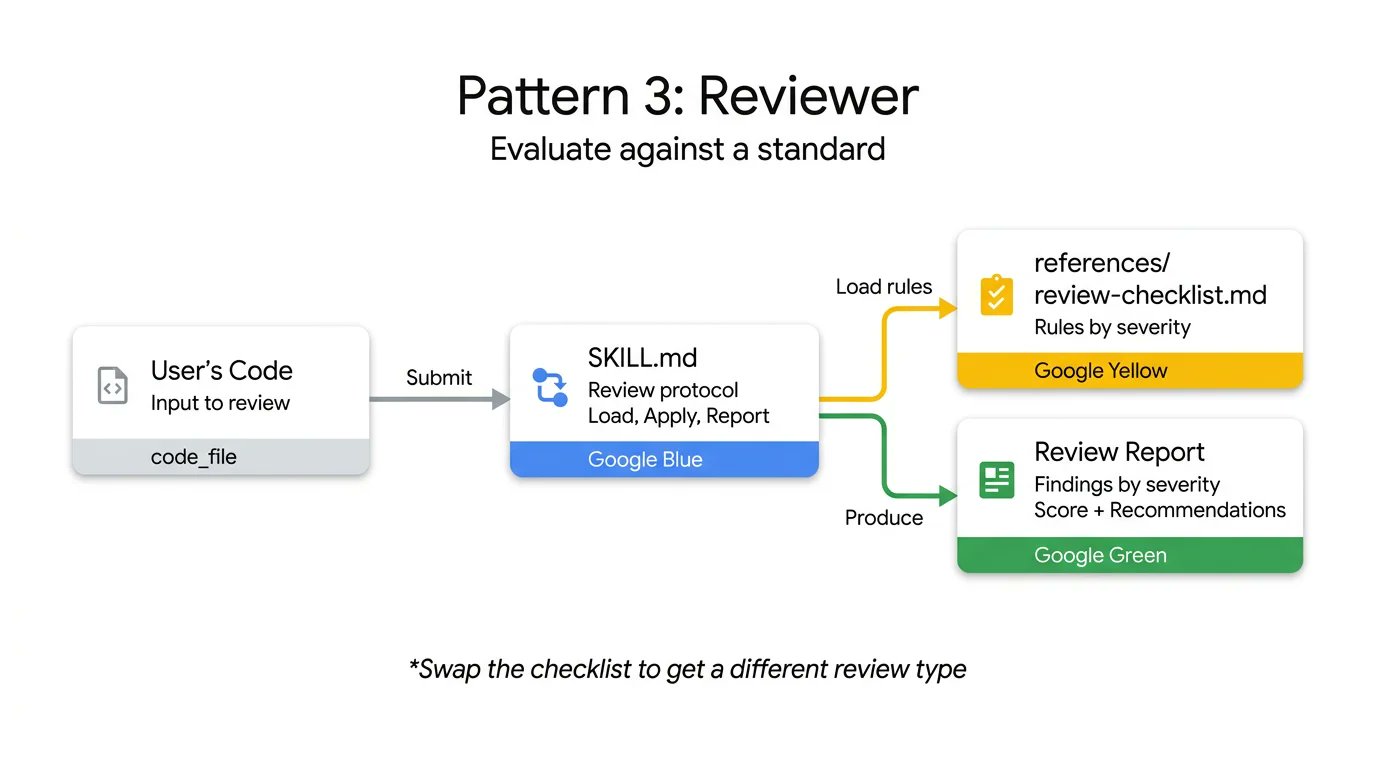
模式五:流水线模式 (The Pipeline)
对于复杂的任务,你不能承受跳过步骤或忽略指令的代价。流水线模式通过硬性的检查点,强制执行严格且有序的工作流。
这里的指令本身就定义了工作流。通过实现明确的门控条件(比如要求在从生成文档字符串进入最终组装阶段之前,必须获得用户的批准),流水线模式确保了智能体无法绕过复杂任务并直接抛出一个未经最终验证的结果。
该模式会利用所有可选的目录,并在且仅在特定步骤需要时才引入对应的参考文件和模板,从而保持上下文窗口的整洁。
在这个文档流水线示例中,请注意明确的门控条件。如果用户在前一步中没有确认生成的文档字符串,智能体将被明确禁止进入组装阶段:
# skills/doc-pipeline/SKILL.md
---
name: doc-pipeline
description: 通过多步骤流水线从 Python 源码生成 API 文档。当用户要求记录模块文档、生成 API 文档或从代码中创建文档时使用。
metadata:
  pattern: pipeline
  steps: "4"
---

你正在运行一条文档生成流水线。请按顺序执行每一个步骤。切勿跳过步骤,如果前一步失败也不要继续。

## 步骤 1 — 解析与盘点 (Parse & Inventory)
分析用户的 Python 代码,提取出所有公开类、函数和常量。将清单以检查列表形式展现出来。并询问:"这是你想要文档化的完整公开 API 列表吗?"

## 步骤 2 — 生成文档字符串 (Generate Docstrings)
针对每一个缺失文档字符串 (docstring) 的函数:
- 加载 'references/docstring-style.md' 获取要求的格式规范
- 严格遵循风格指南生成一段文档字符串
- 将生成的文档字符串逐一展示给用户,以供批准确认
在用户确认通过之前,切勿进入步骤 3。

## 步骤 3 — 组装文档 (Assemble Documentation)
加载 'assets/api-doc-template.md' 获取输出结构。将所有的类、函数及其文档字符串编译合成一份单一的 API 参考文档。

## 步骤 4 — 质量审查 (Quality Check)
对照 'references/quality-checklist.md' 进行复查:
- 每一个公开符号是否都被记录
- 每一个参数是否都有类型和描述说明
- 每一个函数是否至少有一个使用示例
报告审查结果。在向用户展示最终文档前必须修复所有问题。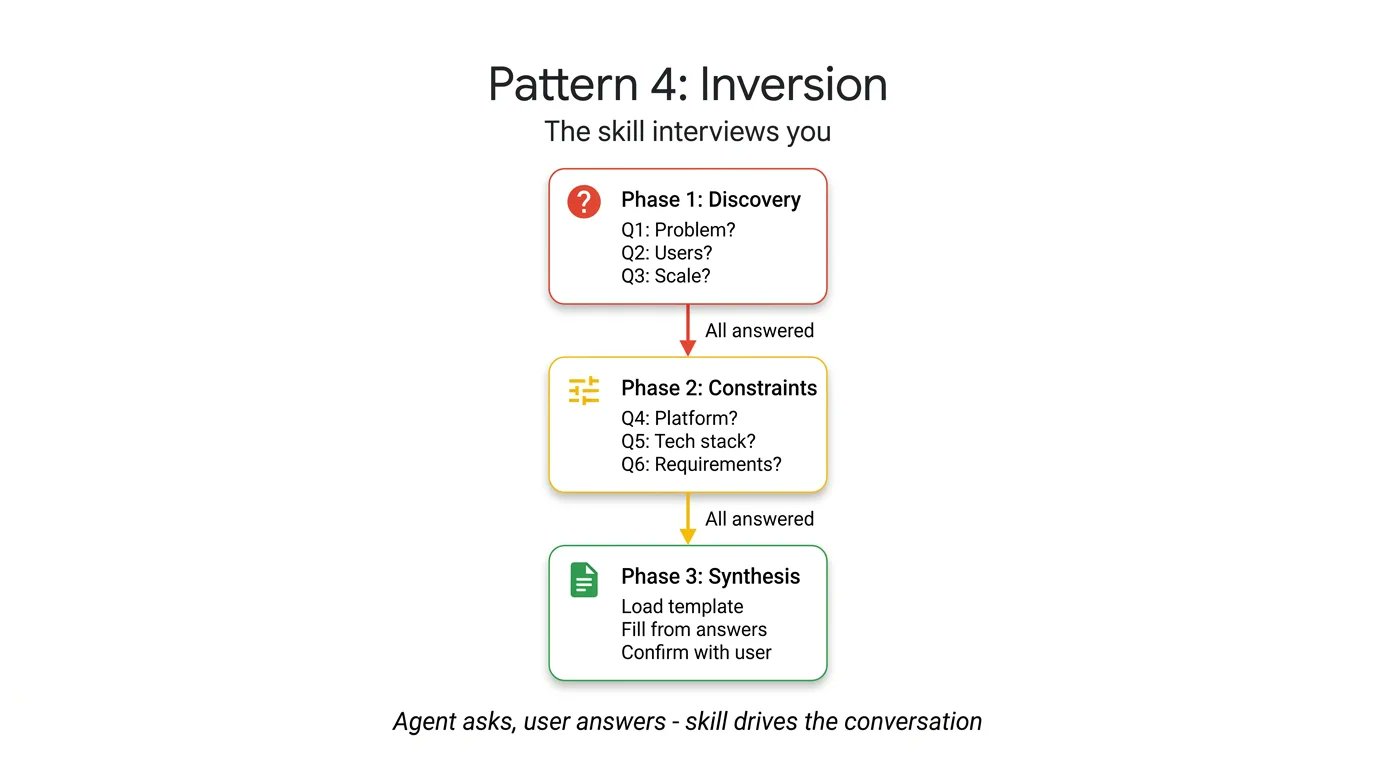
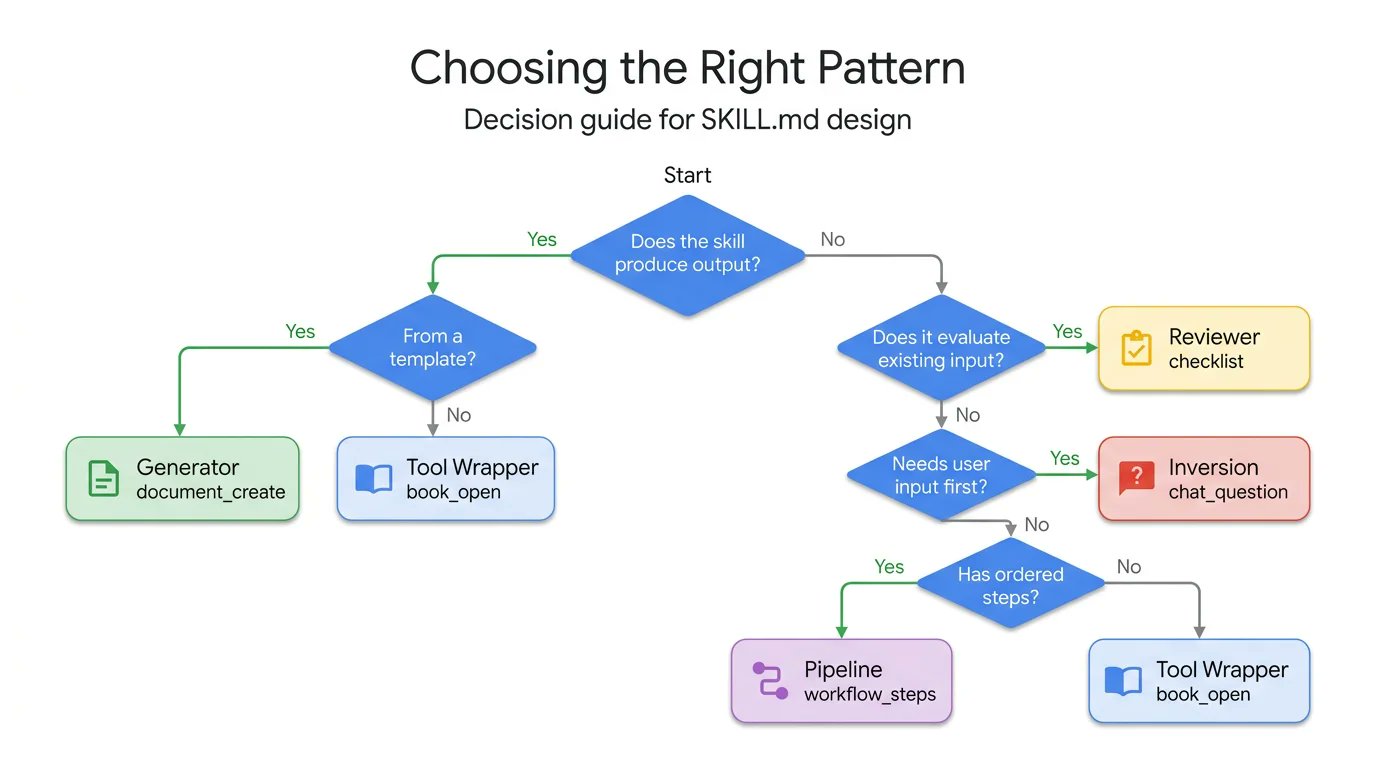
如何选择合适的 Agent Skill 模式?
每种模式都用来解决不同的问题。你可以利用以下决策树,针对自己的用例寻找最合适的模式:
模式的组合应用
最后,这些模式并不是相互排斥的,它们完全可以组合使用。
例如,一个流水线技能可以在最后增加一个审查器步骤来复查自己的工作成果;一个生成器也可以在一开始依赖倒置模式,在填充模板前收集必要的变量。得益于 ADK(Agent Development Kit)的 SkillToolset 和渐进式披露机制,你的智能体在运行时只需在那些确实需要用到的模式上消耗上下文 token。
别再试图把复杂脆弱的指令塞进一个单一的系统提示词里了。将你的工作流拆解开来,应用正确的结构设计模式,打造更加可靠的智能体吧!
🔗 原文链接:5 Agent Skill design patterns every ADK developer should know